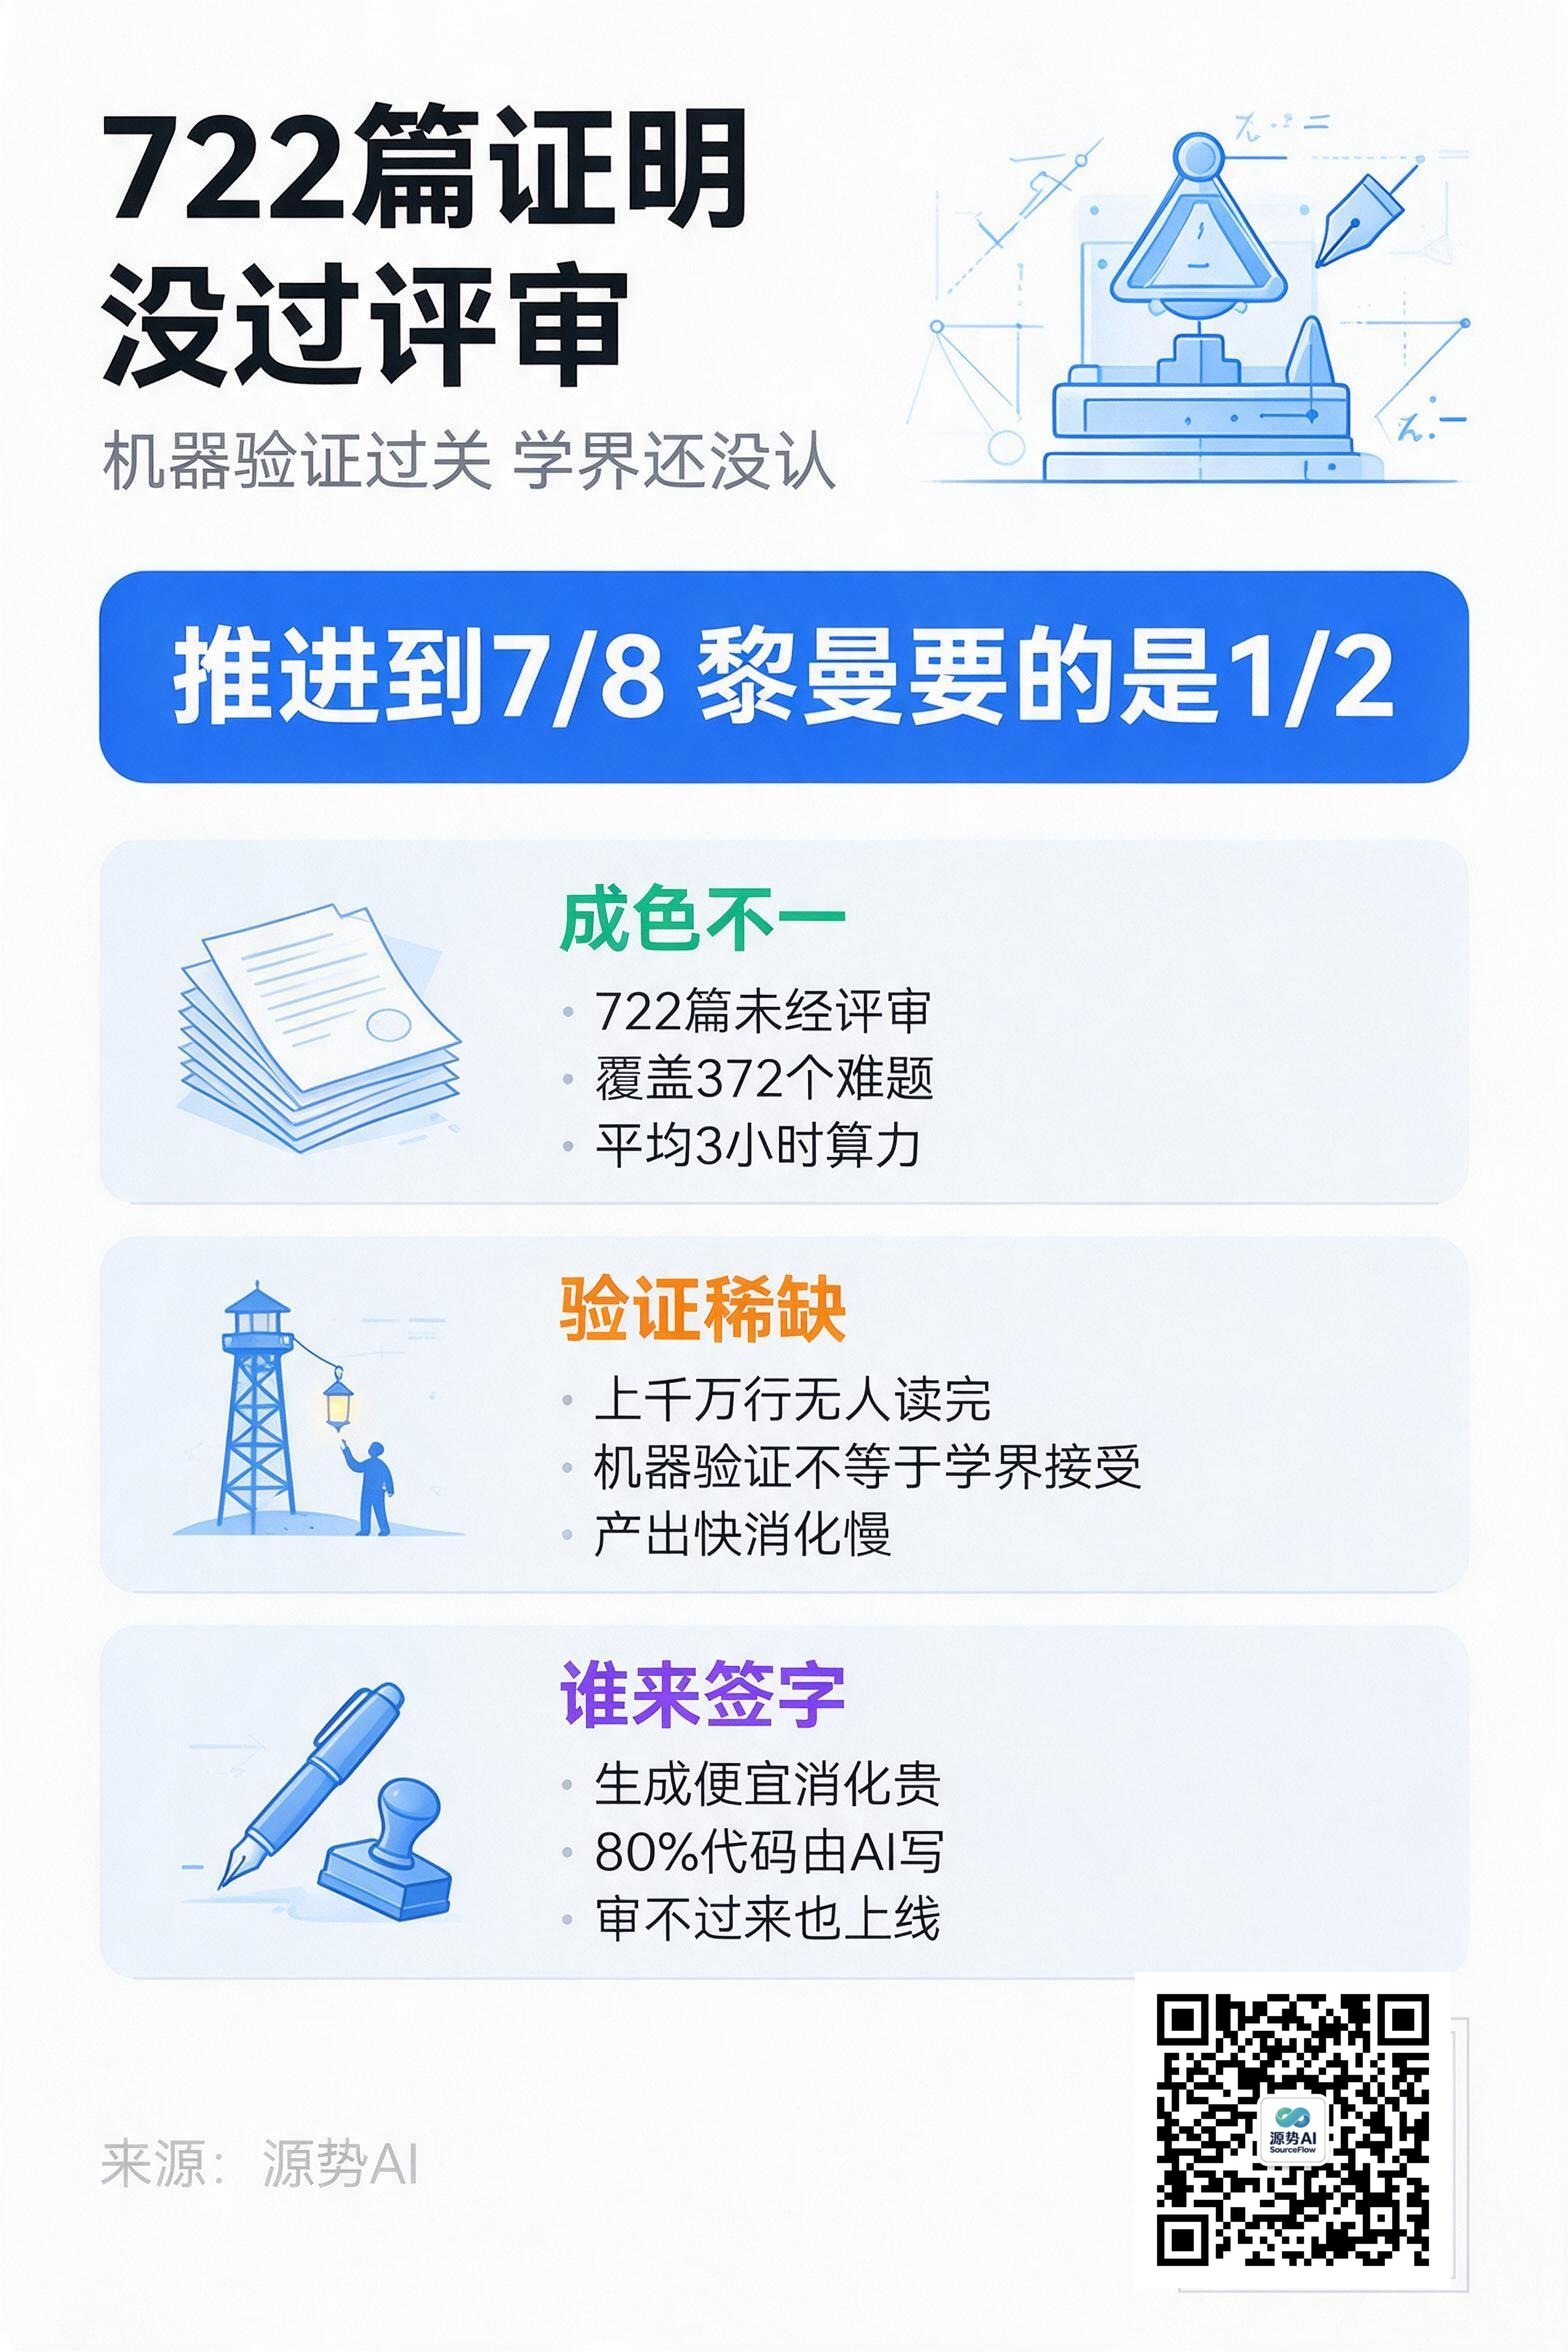
OpenAI 上线了一个 GitHub 项目库 math,一次性公开 722 篇数学手稿,覆盖 372 个此前悬而未决的难题家族,全部由内部未发布模型产出,且没有经过同行评审。最受关注的三项:编号 Result 003 的工作把狄利克雷 L-函数的无零点区域推进到实部大于 7/8,并排除朗道-西格尔零点,同步给出 Lean 形式化验证;Result 102 在经典 P≠NP 框架下处理"基本半定阈值下的普通 NP-困难",试图摆脱对唯一游戏猜想的依赖;Result 001 证明复数域上具有复乘的阿贝尔簇的有理霍奇猜想。官方披露绝大多数结果由模型自动跑出、平均约 3 小时 ChatGPT Pro 思考算力(来源:Tech Digest《AI行业24小时_20261008_10》,2026-10-08)。
数字很漂亮。但真正值得读的不是 722,是"没经过同行评审"这六个字。
7/8不是1/2
先把口径理清。外界一度把这批结果传成"证明黎曼猜想",事实是它到达的是固定常数界 7/8,而黎曼猜想要求 1/2,两者差着一整个量级。Lean 验证只保证形式推导正确,不保证所证命题就是学界真正关心的那个;未经同行评审,意味着结论随时可能被推翻。
这不是给 AI 泼冷水,是提醒"机器验证通过"和"数学界接受"是两件事。前者是程序跑完没报错,后者是活人愿意把结论写进自己的研究里。
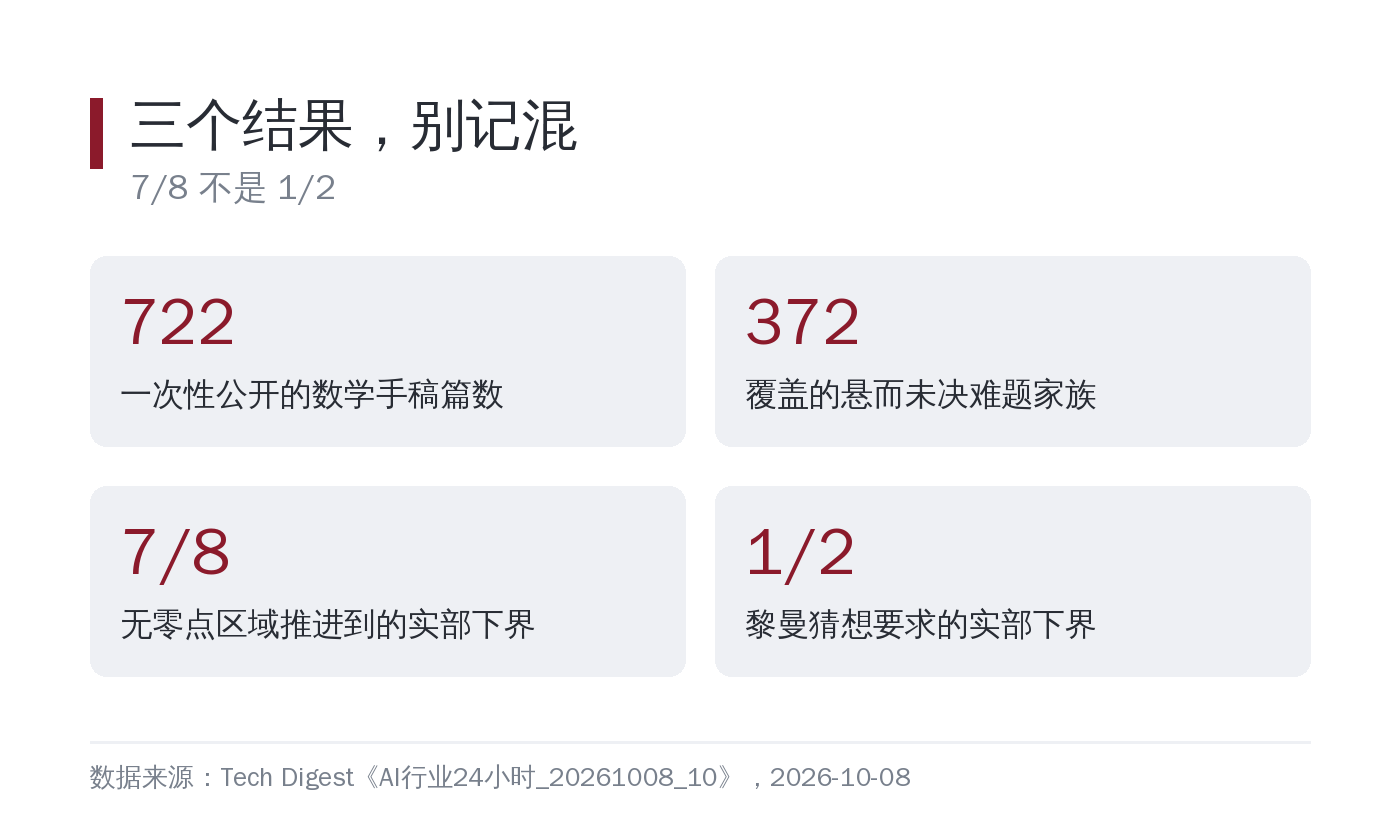
图注:同一批 722 篇里,三项被重点点名的结果成色并不一致——推进到 7/8 与"证明黎曼猜想"之间,差的是一整个量级。
验证正变成稀缺资源
这个矛盾,陶哲轩早就写进过报告:产出证明正急速变便宜,读懂、审核、讲清楚并没有变快。他给这个现象起了个名字,叫"阻抗失配"。他还说过一句被反复引用的话——一个没有人能妥当解释的证明,应当被视为不完整的,哪怕它已经通过了形式化验证(来源:源势AI《1300万行的证明,没人读得完》,2026-09-07)。
参照坐标就摆在 9 月:Anthropic 称 Claude 基本自主运行 11 天,产出约 1300 万行 Lean 代码、约 3.03 万个可机器验证的定理,完成费马大定理的首个端到端形式化证明(来源:源势AI《1300万行的证明,没人读得完》,2026-09-07)。这上千万行代码,没有任何人类能逐行读过。人类验证退化成"运行编译器,看它报不报错"。
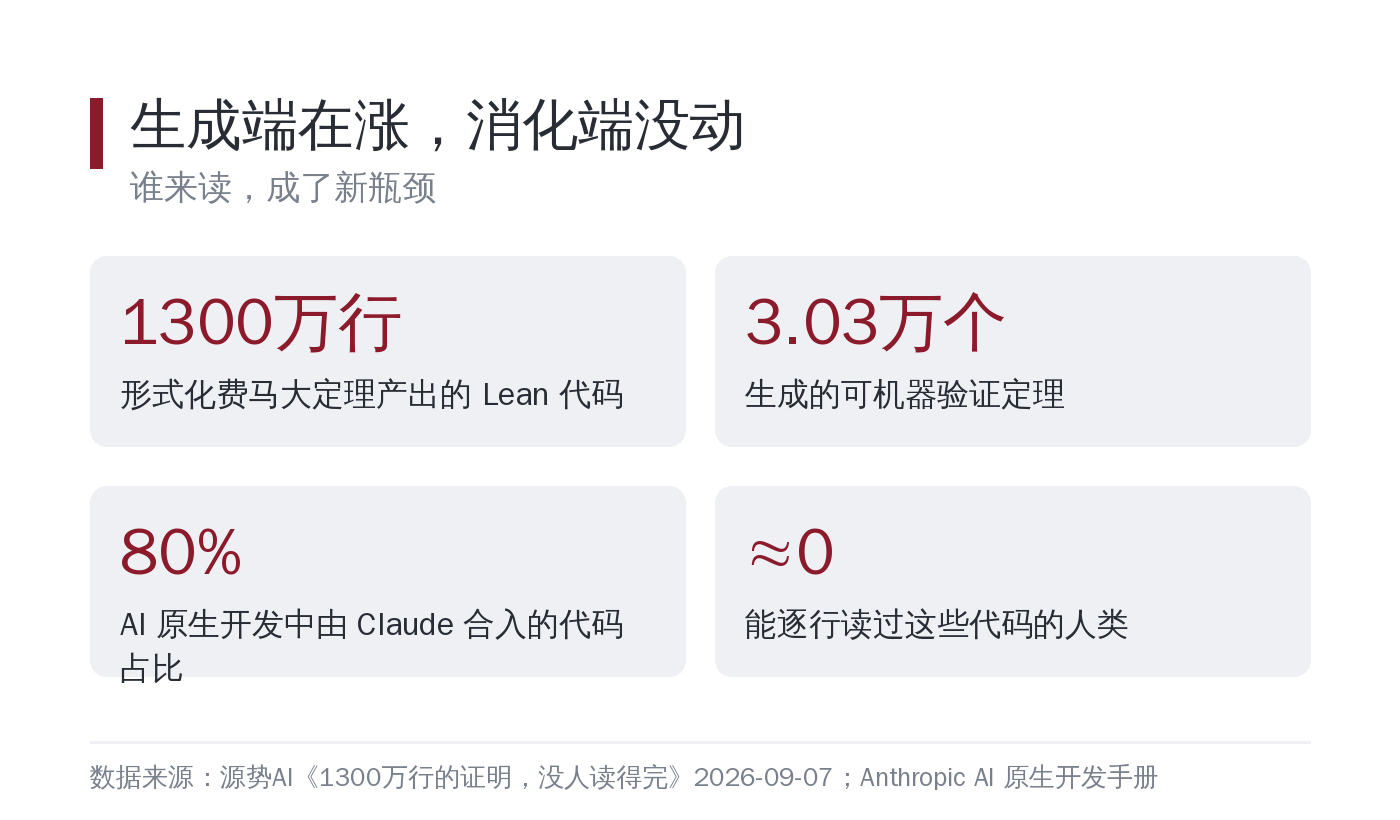
图注:生成端的规模一路走高,读过它的人类数却停在接近零——722 篇手稿和上千万行 Lean 代码是同一道题的两种写法(来源:源势AI《1300万行的证明,没人读得完》,2026-09-07)。
生成便宜了,消化没有
同一场病,在写代码上早有切片。Anthropic 公布的 AI 原生开发手册里,80% 合入代码由 Claude 编写,配套遥测同时显示 PR 审查耗时成了新的瓶颈(来源:Anthropic《AI Native 全流程实践指南》,转引自源势AI《1300万行的证明,没人读得完》,2026-09-07)。生产端供给充裕之后,稀缺资源向下游迁移——"谁来写"不值钱了,"谁能证明它是对的、谁来解释它为什么对"开始值钱。
这件事有一个不太舒服的推论:过去学术界的把关靠"同行评审"这道闸,现在闸门前的稿件量级变了。722 篇手稿没有一篇走评审,直接上了 GitHub,不是因为评审制度坏掉了,而是生成速度已经让评审跟不上。跳过评审、用仓库代替期刊,这套做法数学界有强烈反对。
数学有 Lean 这种"能机械验货"的基础设施,法律、医疗、金融的交付物没有等价验证器。数学界今天撞上的墙,别的行业只会撞得更疼。
企业里的版本更朴素。模型写出来的代码、报告、分析,产出量已经远超团队能认真读的份量;审不过来,最后就变成"没人细看,但照样上线"。这不是模型的问题,是消化能力的缺口被产量放大了。
数学界开始给验证定价
生成端狂奔的时候,数学界的动作也密集得反常。
Leiden 声明主张,AI 参与成果的作者身份归属需要重新约定;网上流传丘成桐悬赏 10 万元征集佩雷尔曼庞加莱猜想证明的形式化验证(新智元报道写明截图尚未证实);陶哲轩给的处方是动声望结构——降低"证明生成"的文化权重,提高"证明消化"的地位,把结果讲清楚、认真审稿、整理成领域能反复引用的标准表述(来源:陶哲轩 ICM 2026 报告及论文《Mathematics in the age of AI》,转引自源势AI《1300万行的证明,没人读得完》)。
一个从不给知识定价的共同体,开始给"可验证性"标价,这本身就是信号。它等于承认:能被机器检查的证明只是半成品,还得有人讲清楚它到底证明了什么。
源势AI观点
我们在企业级 Agent 交付里越来越多碰到同一个问题:客户不怀疑模型能不能干,怀疑的是干完这一步谁签字。所以我们的工程投入大头放在验证侧而不是生成侧——FDE 交付的每个智能体工作流都带机器可核查的验收条件加可回放的轨迹日志,判不准的置信度阈值宁可保守也不放行。
陶哲轩给数学界开的方子,放到企业 AI 落地上是一样的:生成能力是供应商的事,消化能力是你自己的。评估一个 Agent 项目值不值,别只问它做出了什么,问它做出的东西有多少能被你的人讲清楚、有多少能被第三方复核。722 篇证明摆在面前,真正卡住你的不会是"AI 能不能证明",而是"你有几个人看得懂"。
话题标签:#AI数学 #形式化验证 #同行评审
