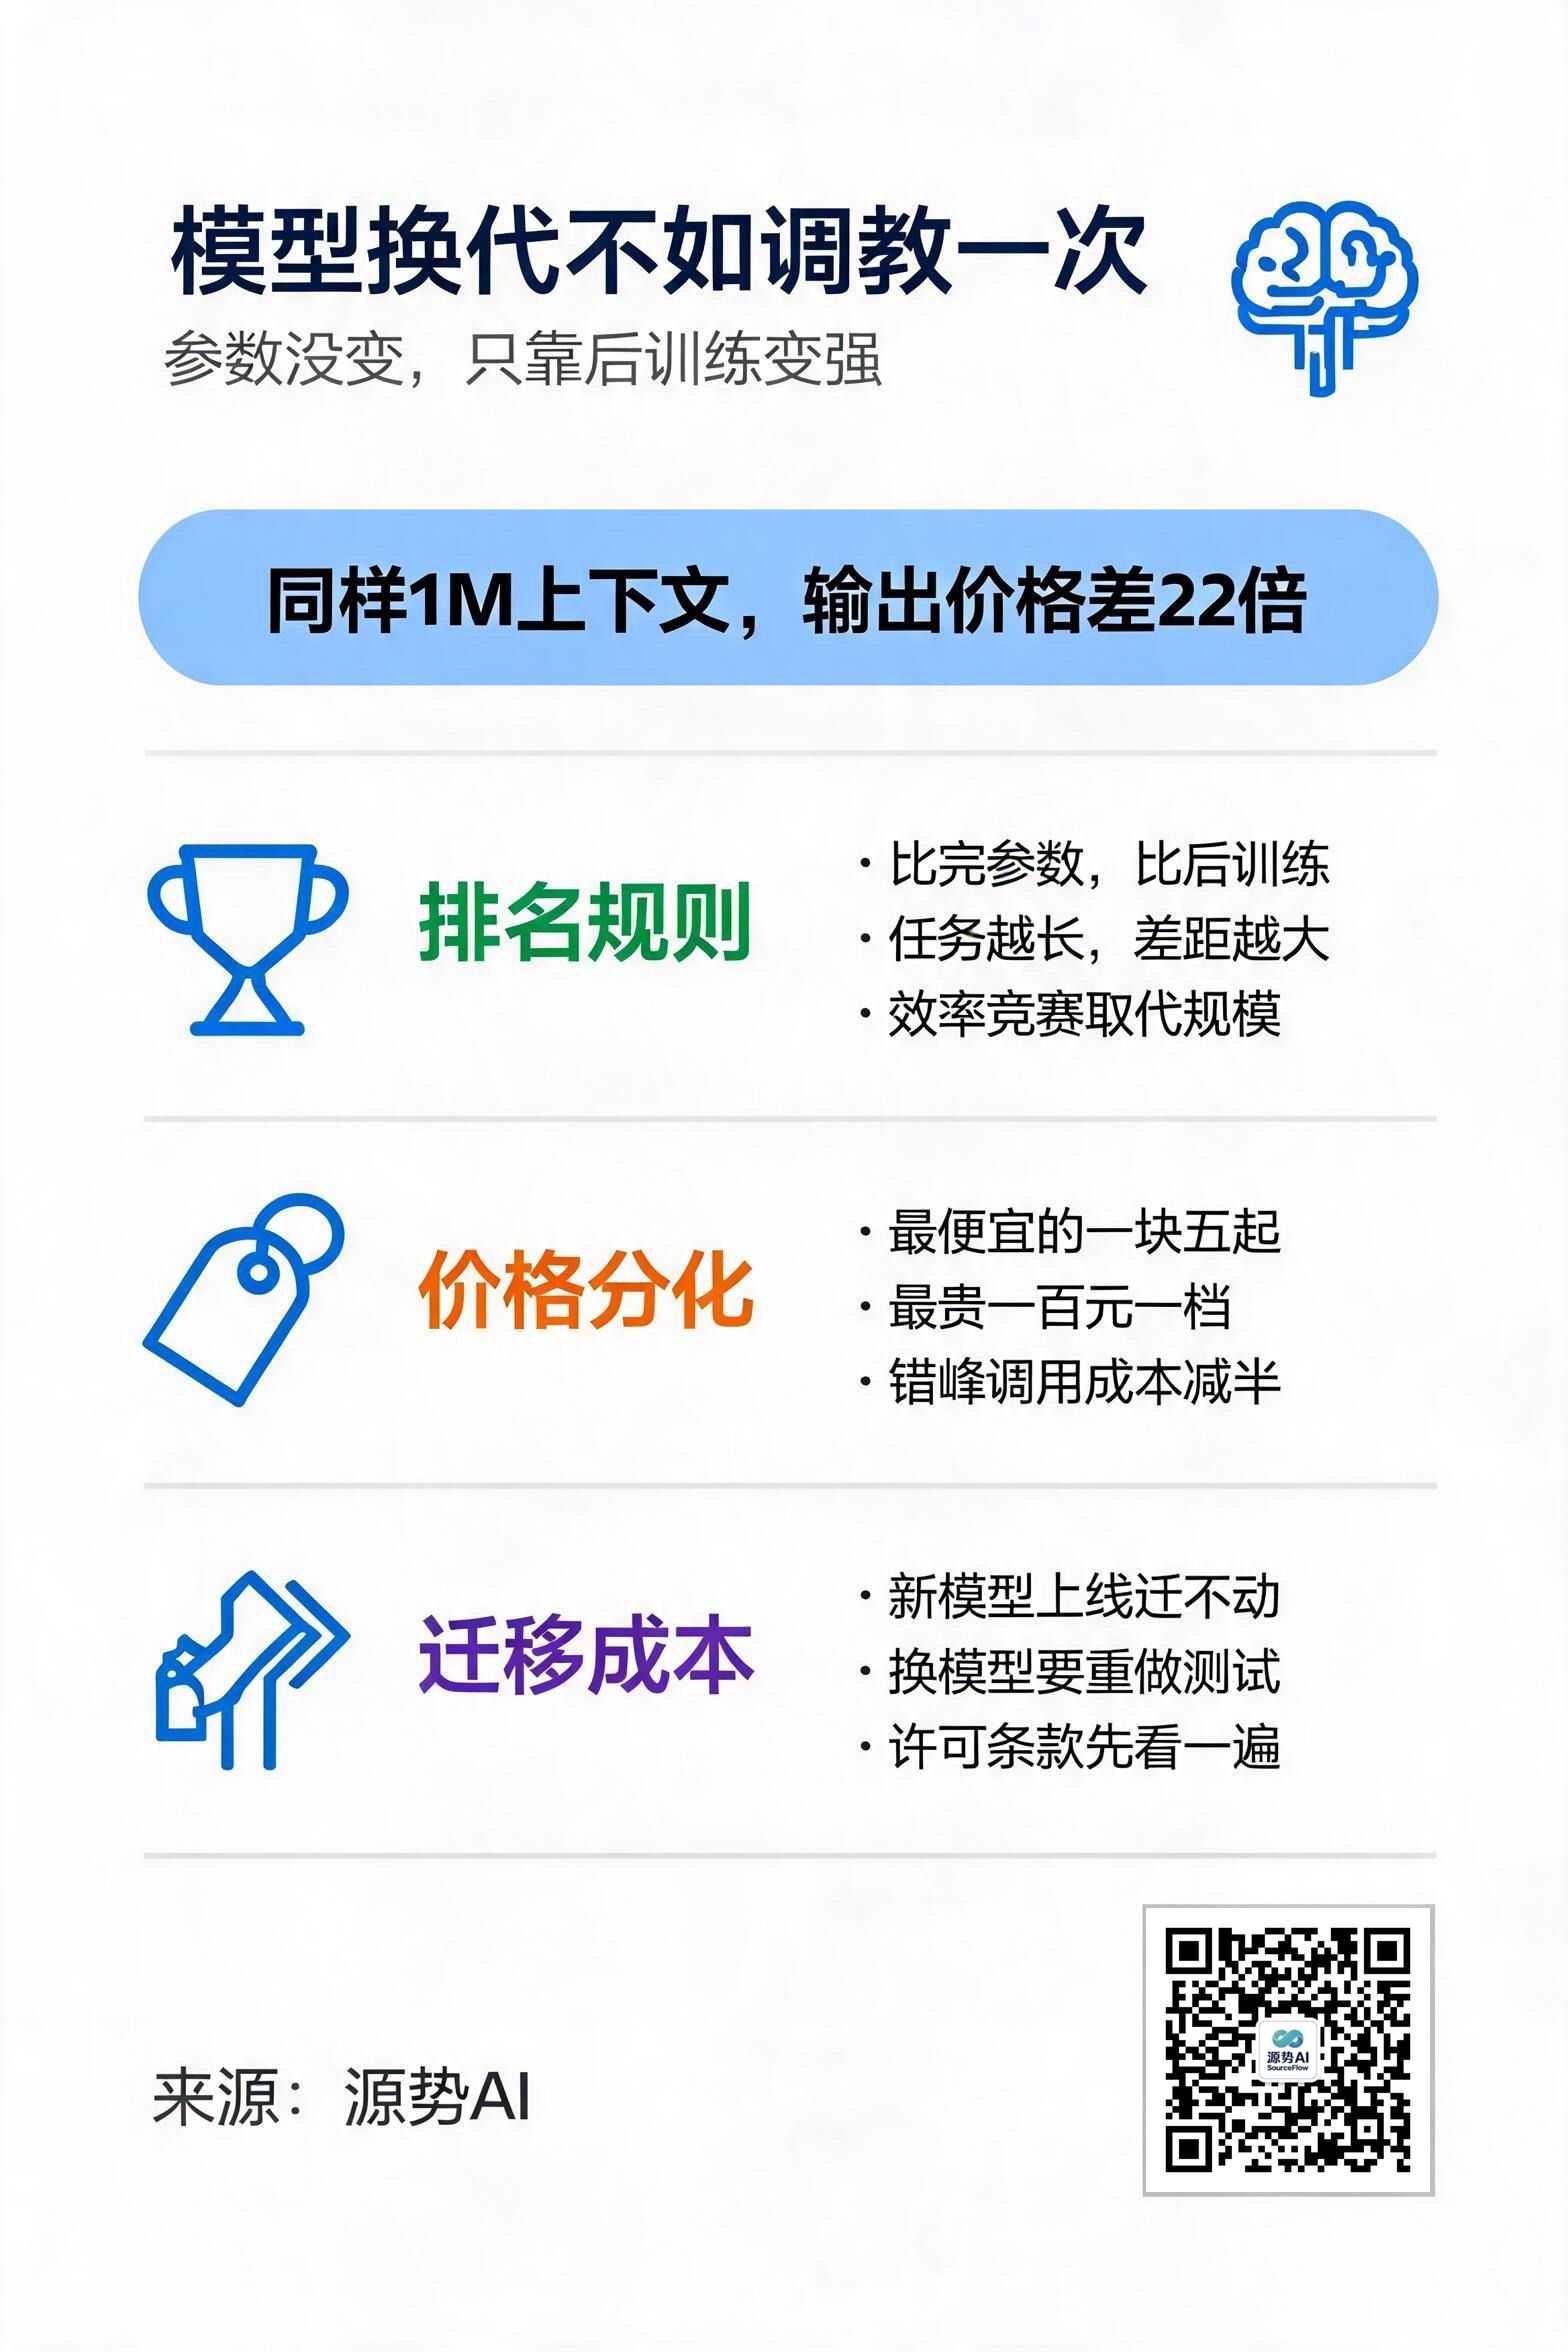
9 月 11 日深夜,DeepSeek 发了条公告:V4 Pro 的 API 不下线了,原定的 9 月 14 日截止撤回,计费不变。往前翻两天,这家公司的操作堪称反复横跳:9 月 9 日宣布把 V4 Pro 的流量全部路由到新模型 V4.1 Flash、按 Flash 的单价收费,9 月 10 日把下线时间推迟到 9 月 14 日中午,9 月 11 日干脆取消下线。24 小时里改了两次口径,最后一步退让。
让 DeepSeek 进退两难的,是自家新模型表现太好又太不够好。552B 参数的 V4.1 Flash 在第三方 Agentic 基准上超过了 1.6T 参数的 V4 Pro(来源:富瑞研报,2026-09-11),"以下犯上"已经成立;但 Pro 的存量用户就是迁不过去。接口契约、输出风格、工具链依赖,这些看不见的东西构成了真实的切换成本。
同一周,一份五款国产旗舰开源模型的横评把另一件事摆上了台面:模型能力的竞赛规则变了。
图注:同底座同参数的 GLM-5.3,靠后训练把 Terminal-Bench 3.0 从 4.6 拉到 28.3——参数规模让位给调教效率
同底座的对照实验
InfraBloom 在 9 月 10 日发布的横评覆盖了 Kimi K3、DeepSeek V4-Pro、V4-Flash、GLM-5.3、Qwen3.8-Max 五款模型、24 项基准(来源:《五款国产开源大模型旗舰横评:同样的 1M 上下文,输出价差 22 倍》,InfraBloom,数据核验至 2026-09-07)。最有说服力的一个数据来自智谱:GLM-5.3 与 GLM-5.2 完全同底座、同参数,提升全部来自后训练,Terminal-Bench 3.0 从 4.6 分拉到 28.3 分。
一次不算数的话,看全场。编程与软件工程项里,五家咬得极紧:Terminal-Bench 2.1 上 Kimi K3 拿了 88.3,GLM-5.3 是 88.2,V4-Pro 87.9,差距不到一个百分点。但换成更接近真实终端环境的 Terminal-Bench 3.0,GLM-5.3 的 28.3 对 Kimi K3 的 17.4,差距瞬间拉开。
这份数据在说同一件事:预训练决定底线,后训练决定长活干得好不好。任务链越长,后训练的差距越藏不住。
| 基准 | Kimi K3 | V4-Pro | GLM-5.3 |
|---|---|---|---|
| Terminal-Bench 2.1 | 88.3 | 87.9 | 88.2 |
| Terminal-Bench 3.0 | 17.4 | 未公布 | 28.3 |
| DeepSWE v1.1 | 67.5 | 62.7 | 66.9 |
| Terminal-Bench 2.1 | 88.3 | 87.9 | 88.2 |
|---|---|---|---|
| Terminal-Bench 3.0 | 17.4 | 未公布 | 28.3 |
| DeepSWE v1.1 | 67.5 | 62.7 | 66.9 |
| Terminal-Bench 2.1 | 88.3 | 87.9 | 88.2 |
|---|---|---|---|
| Terminal-Bench 3.0 | 17.4 | 未公布 | 28.3 |
| DeepSWE v1.1 | 67.5 | 62.7 | 66.9 |
| Terminal-Bench 3.0 | 17.4 | 未公布 | 28.3 |
|---|---|---|---|
| DeepSWE v1.1 | 67.5 | 62.7 | 66.9 |
| DeepSWE v1.1 | 67.5 | 62.7 | 66.9 |
|---|
(注:Terminal-Bench 3.0 一项,DeepSeek 未公布 V4-Pro 成绩,表中不填。)
22 倍的价差
能力趋近,价格却没趋近。五款模型都是 1M 上下文,输出单价从每百万 tokens 4.50 元到 100 元,差了 22.2 倍(来源:同上横评,人民币计价)。同样 100 块钱,买 V4-Flash 能拿到 2.22 亿个输出 token,买 Kimi K3 只有 1 亿。
DeepSeek 还干了件行业头一遭的事:把峰谷电价搬进了 API。8 月 16 日起,非高峰时段价格是高峰的一半。批处理、评测、索引回填这类"能等"的任务挪出高峰,成本直接对折;客服、编程助手这类交互式应用躲不开。
一家做智能路由聚合的平台看这张价目表,看到的不是便宜,是复杂度。同一个"跑一个 agent 任务",拆开后每一步该落在哪款模型的哪个时段,是一道持续变化的算术题。今天 V4-Flash 是全网最便宜的主力档,下个月可能有更便宜的掀桌者。把任何单一模型的现价写进长期预算,都是给自己挖坑。
下线公告里的采购课
回到 DeepSeek 撤回下线这件事。对企业采购者,这是一堂免费的课。
模型厂商的"建议尽早迁移",过去被当成技术提示,现在该被当成合同风险看。V4.1 Flash 分数超了 Pro,官方依然没法让全部流量无痛迁移,说明 API 背后不只是分数,还有一整条依赖链:提示词调优是按 Pro 的输出风格做的,工具调用的失败率是按 Pro 的行为分布评估的,评测基线是拿 Pro 跑出来的。换个模型,这些东西默默重算一遍。
横评里另一个细节值得注意:五款模型许可各不相同。V4 系列是标准 MIT,搬进自己机房没有任何门槛;Kimi K3 是修改版 MIT,商用有门槛;GLM-5.3 用的是自家许可证,Qwen3.8-Max 的开源许可细则还在复核中。分数一样漂亮,能不能私有化部署、能不能改权重,是四个不同的法律答案。
长上下文是另一个照妖镜。五款都宣称支持 1M 上下文,但"能塞进去"和"能找出来"是两件事:Kimi K3 的 BrowseComp 拿到 91.2、长上下文召回测试 AA-LCR 为 74.7,GLM-5.3 的最大输出长度停在 131K,而 V4 系列可到 384K(来源:同上横评)。做文档问答和代码库级分析的团队,这组数字的权重应该排在跑分前面——1M 窗口配 131K 输出,意味着读得进整本书、写不出完整答案。
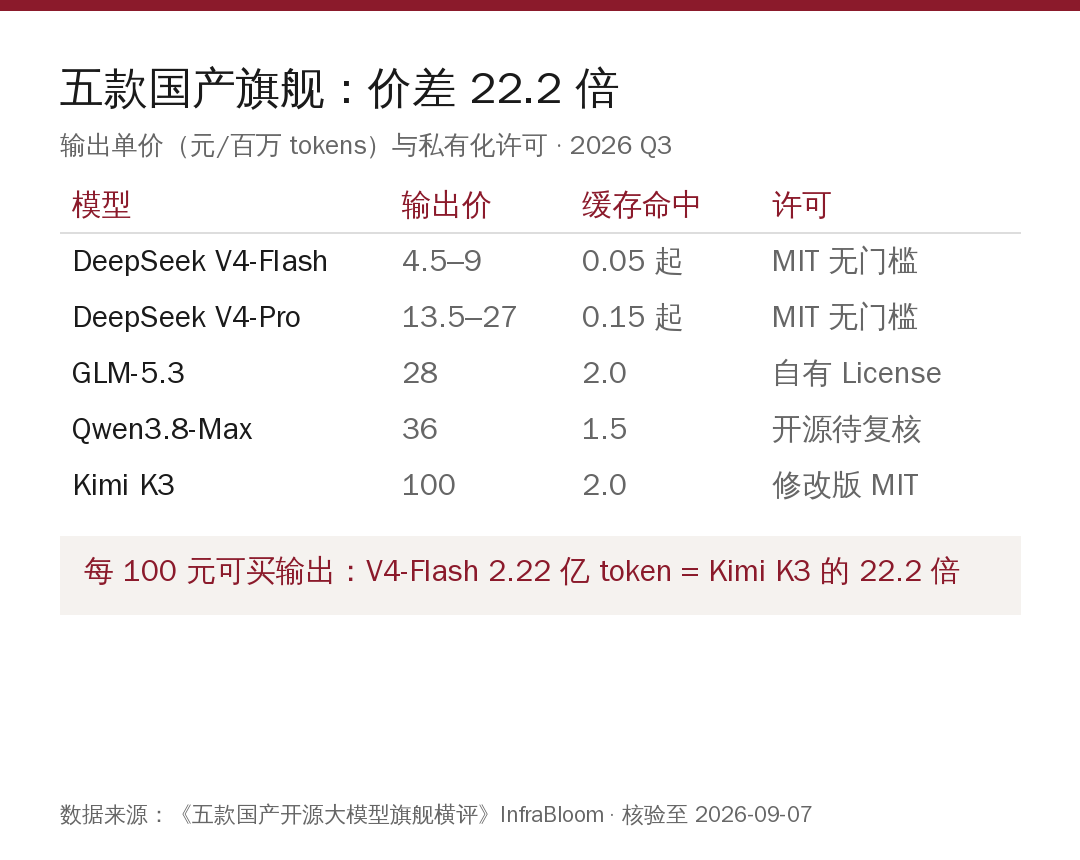
图注:22 倍价差与三种许可并存——每 100 元可买 V4-Flash 输出 2.22 亿 token,是 Kimi K3 的 22.2 倍(来源:InfraBloom 横评)
源势AI观点
这轮变化对企业落地意味着什么,源势AI有三个判断。
第一,选型单位从"模型"变成"任务档位"。我们的 Token 聚合平台接了 20 多个模型,路由策略最近明显往细了做:同一个客户的工作流里,长程 agentic 任务走后训练强的档,批量抽取走最便宜的档,能等的任务错峰跑。单模型直连的企业,这道题没人替他做。
第二,把"迁移成本"写进采购评估。每次模型下线公告,都是重排供应商的机会,也是被动挨刀的时刻。判断标准很简单:你的提示词资产、评测基线、缓存策略,有多少绑定在特定模型的行为特性上。绑定越深,议价权越弱。
第三,许可比分数先谈。99 分和不能商用,是两个世界的选项。
参数竞赛落幕不等于竞争结束,只是计分板换了。旧的看显存,新的看谁能把便宜、能干、迁得动这三件事同时做到。DeepSeek 一夜撤回的下线公告,就是新规则下的第一份缴械书。
