曹操出行的 AI 打车服务正式接入荣耀 YOYO。用户对手机说一句用车需求,YOYO 自动识别起终点、匹配运力、规划车型与路线,然后完成下单(来源:中国经营报)。
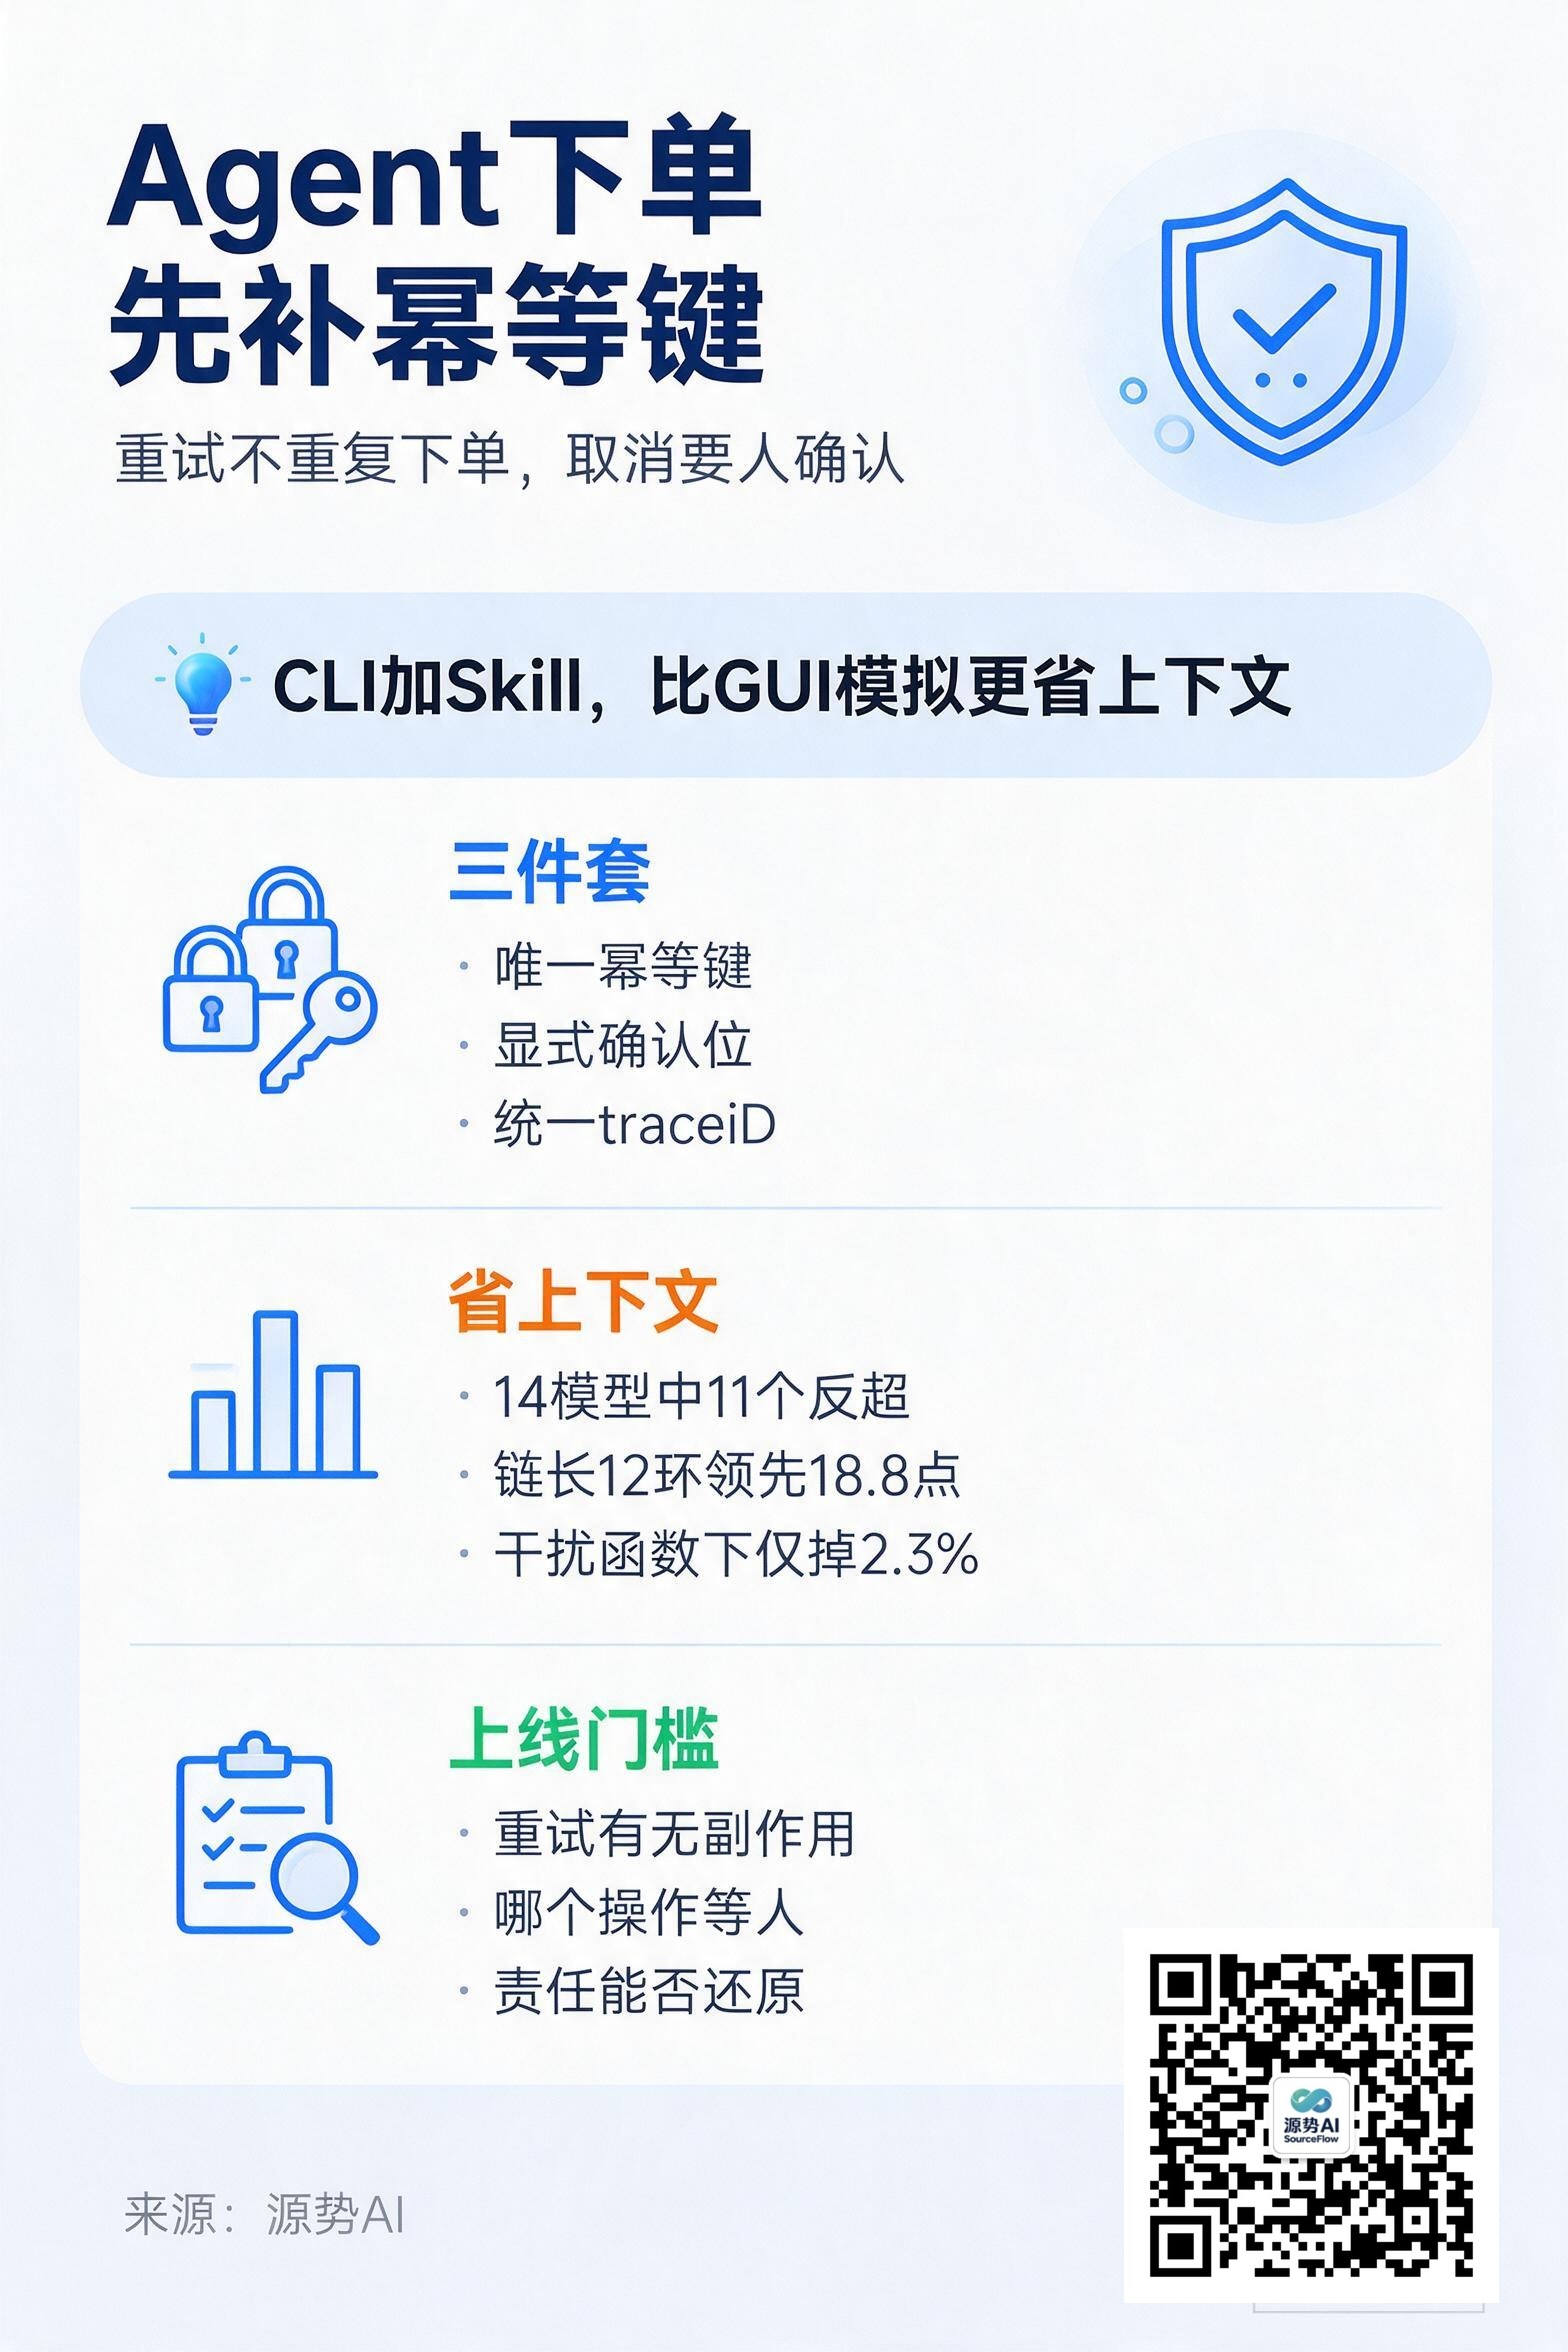
真正值得抄的部分不在交互,在技术层。这次曹操出行首次开放了 caocao-cli,并加了三样东西:唯一幂等键、显式确认位、统一 traceId。网络抖动下的重试不会变成重复下单,取消这类关键操作需要用户确认,跨服务全链路可回溯、可审计。
官方还补了一句判断:CLI 加 Skill 的方案比 GUI 模拟更省上下文。
图注:同一个意图被提交三次,系统只应该执行一次,这就是幂等键要管的事
能不能调通,已经不是门槛了
Agent 接外部服务这件事,两年前的门槛是"能不能调通"。今天这个门槛基本消失了——输入输出格式、鉴权、错误码都是标准动作,模型侧的调用能力也足够。
门槛换到了另一个位置:它调通之后,做错了事谁负责。
打车这件事很典型。重复下单不会报错,接口返回成功,系统一路绿灯,代价是用户账单上多出一笔。这类问题在工程上叫静默失败——动作看起来成功了,结果错了。它比报错难处理得多,因为它不触发任何告警。
幂等键解决的是其中最基础的一类:请求的身份。同一个意图无论被提交几次,系统只执行一次。这个东西在传统后端里是老知识,但 Agent 场景把它重新推到了台前——因为 Agent 的每一次重试都是自主发起的,没有人按按钮。
显式确认位,是把判断权留在人手里
第二样东西是显式确认位。下单可以自动完成,取消必须由人确认。
这条边界画得有讲究。下单失败用户可以再叫一次,成本低;取消一旦误触发,服务已经中断,司机已经在路上,代价由别人承担。工程上的通用做法是看操作的可逆性——不可逆操作必须留一个人类确认的关口。
这和我们昨天写过的《治理3.0:智能体风险首次单列》里的判断一致(来源:源势AI 9 月 16 日文章):智能体不是说话的系统,是动手的系统,它的风险清单里排第一的就是身份与权限滥用。
CLI 比 GUI 模拟省的是什么
第三种做法是最容易被低估的技术选择:用 CLI 加 Skill,而不是让模型去模拟人点屏幕。
GUI 模拟的思路是让视觉模型看着界面截图,决定点哪里。它的好处是任何 App 都能被接管,坏处是每一步都要一张截图进上下文——屏幕像素是上下文里最贵的东西。
CLI 方案绕开了这一层:工具以命令的形式暴露给模型,参数就是参数,返回就是返回。
《别再用JSON调工具了》这篇解读里的实测数据可以用来说明同一件事(来源:普华永道技术团队论文《The Bitter Lesson of Tool Calling》,arXiv:2608.06370)。他们在 BFCL v4 基准上测了 14 个模型,比较程序化工具调用(PTC,模型写一段脚本一次性把工具调完)和原生 JSON 逐轮调用:11 个模型的 PTC 准确率持平或反超,GPT-5.6 家族最高提升 10.6 个百分点。
更关键的是两组消融。链式调用场景里,链长达到 12 环以上时,PTC 平均领先 18.8 个百分点——多出来的每一个推理轮次,都是 JSON 为每一环交的税。上下文污染场景里,往上下文塞 128 个干扰函数定义,JSON 的准确率平均掉 2.3%,而"让模型自己去读工具定义文件"的方案平均掉 32%。
工具描述本身就是污染源,谁往上下文里塞得少,谁就稳。
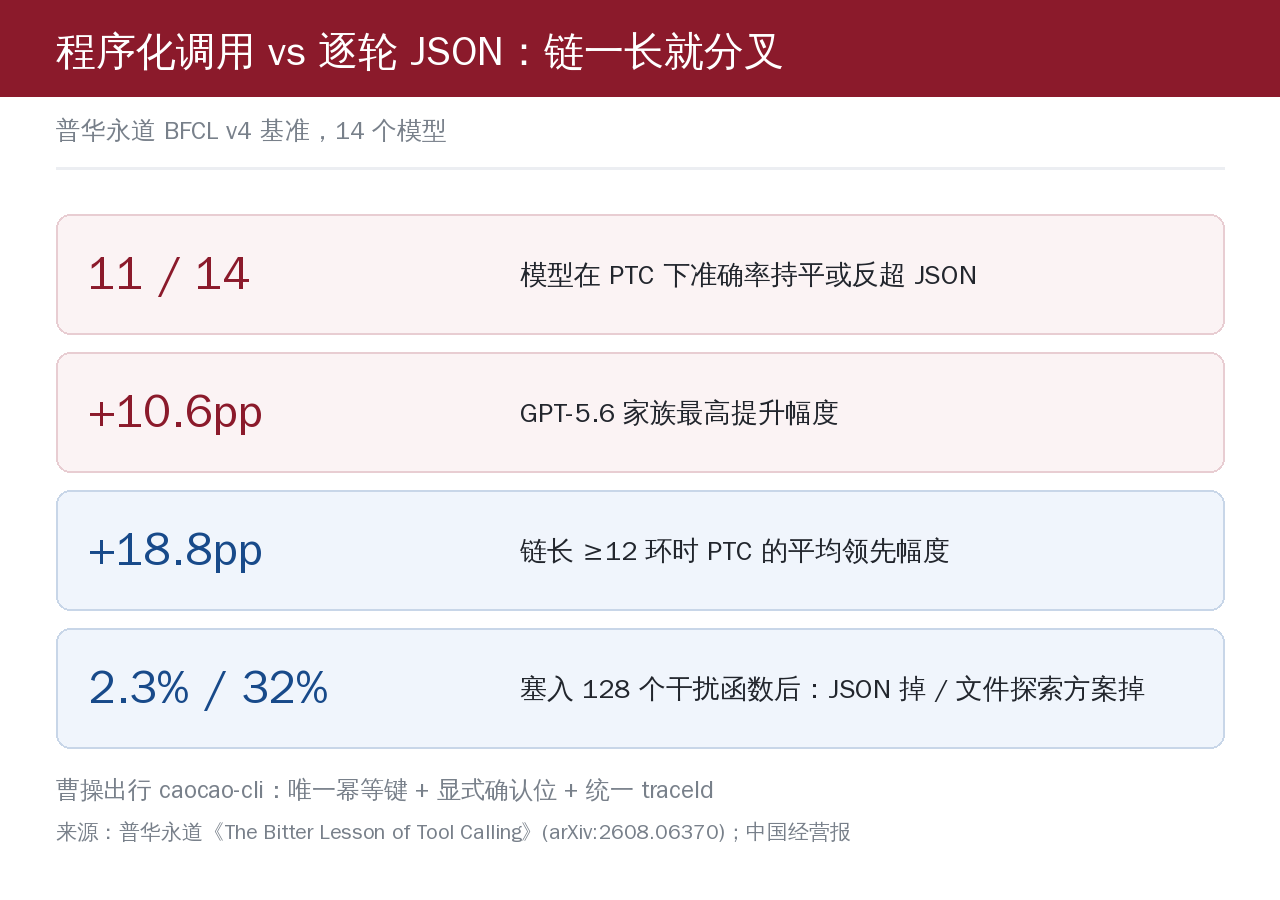
图注:链越长、上下文越脏,逐轮 JSON 为每一环交的税就越贵
动作前那一层校验
还有一层防护值得单独提。arXiv 上有一篇《Look Before You Leap: Pre-Action Verification for LLM Agents》(arXiv:2609.11957),主张在动作真正生效之前插入一次廉价的确定性校验(来源:该论文)。
论文在 9930 条命令、482 个真实工具上构建了反循环基准:静态校验器以 10.0% 的误报率捕获了 95.8% 的非法命令,其中语法检查与二进制检查达到零误报。代码编辑侧的数据更刺眼——行号锚定格式在偏移一行时会损坏 99.1% 的文件,而基于内容锚定的 search/replace 格式失败得干净。
这条结论和幂等键是一体两面:幂等键保护"同一个意图不重复执行",动作前校验保护"这个动作本来就不该执行"。两样都做,Agent 才谈得上无人值守。
源势AI怎么看
把这次接入当成一个验收模板,比当成一条产品新闻有用。
我们给企业做 Agent 落地时,客户最常问的是准确率。准确率当然要看,但生产环境真正决定能不能上线的是另外三个问题:这个动作能不能重试而不产生副作用?哪一个操作必须停下来等人?出了问题能不能顺着一条链路把责任还原出来。
幂等键、确认位、traceId 这三样,对应的就是这三个问题。它们不需要模型升级,也不需要更多数据,属于工程侧就能补齐的东西——但漏掉任何一样,系统就只能停在演示阶段。
曹操出行这次把 CLI 开放出来,等于是把这三件事做成了行业可参照的样本。手机厂商的系统级智能体正在快速铺开,接下来一年,能被接入的服务会有很多,能通过这三道检查的不会太多。这中间的差距,就是工程能力的差距。
