周一,运营总监问 AI 助手:上个月哪些门店业绩下滑了?答,12 家。周三换个问法再问,答,9 家——两份名单里有 4 家对不上。
《万字长文说清Palantir式本体对AI的真实价值》把这类问题拆成六层机制,第一层叫"语义透明"。它的判断很直接:用户看到的是"答案变了",实际发生的是"定义变了",而没有任何人能指出定义在哪一刻变的。
图注:五套系统各说各话,中间缺的不是管道,是一份共同的词表
口径住在运行时,还是住在模型里
"业绩"在直营与加盟混合的体系里天然有两套账:总部看订货额,加盟商看动销。正常时候同向,出问题的时候背离——一家店上月订货额没跌,因为月初压了一批货,动销却在持续走低。
通用大模型的做法是,每次回答时在运行时临时替你选一套口径。这套口径不稳定、不可见,会随措辞漂移。
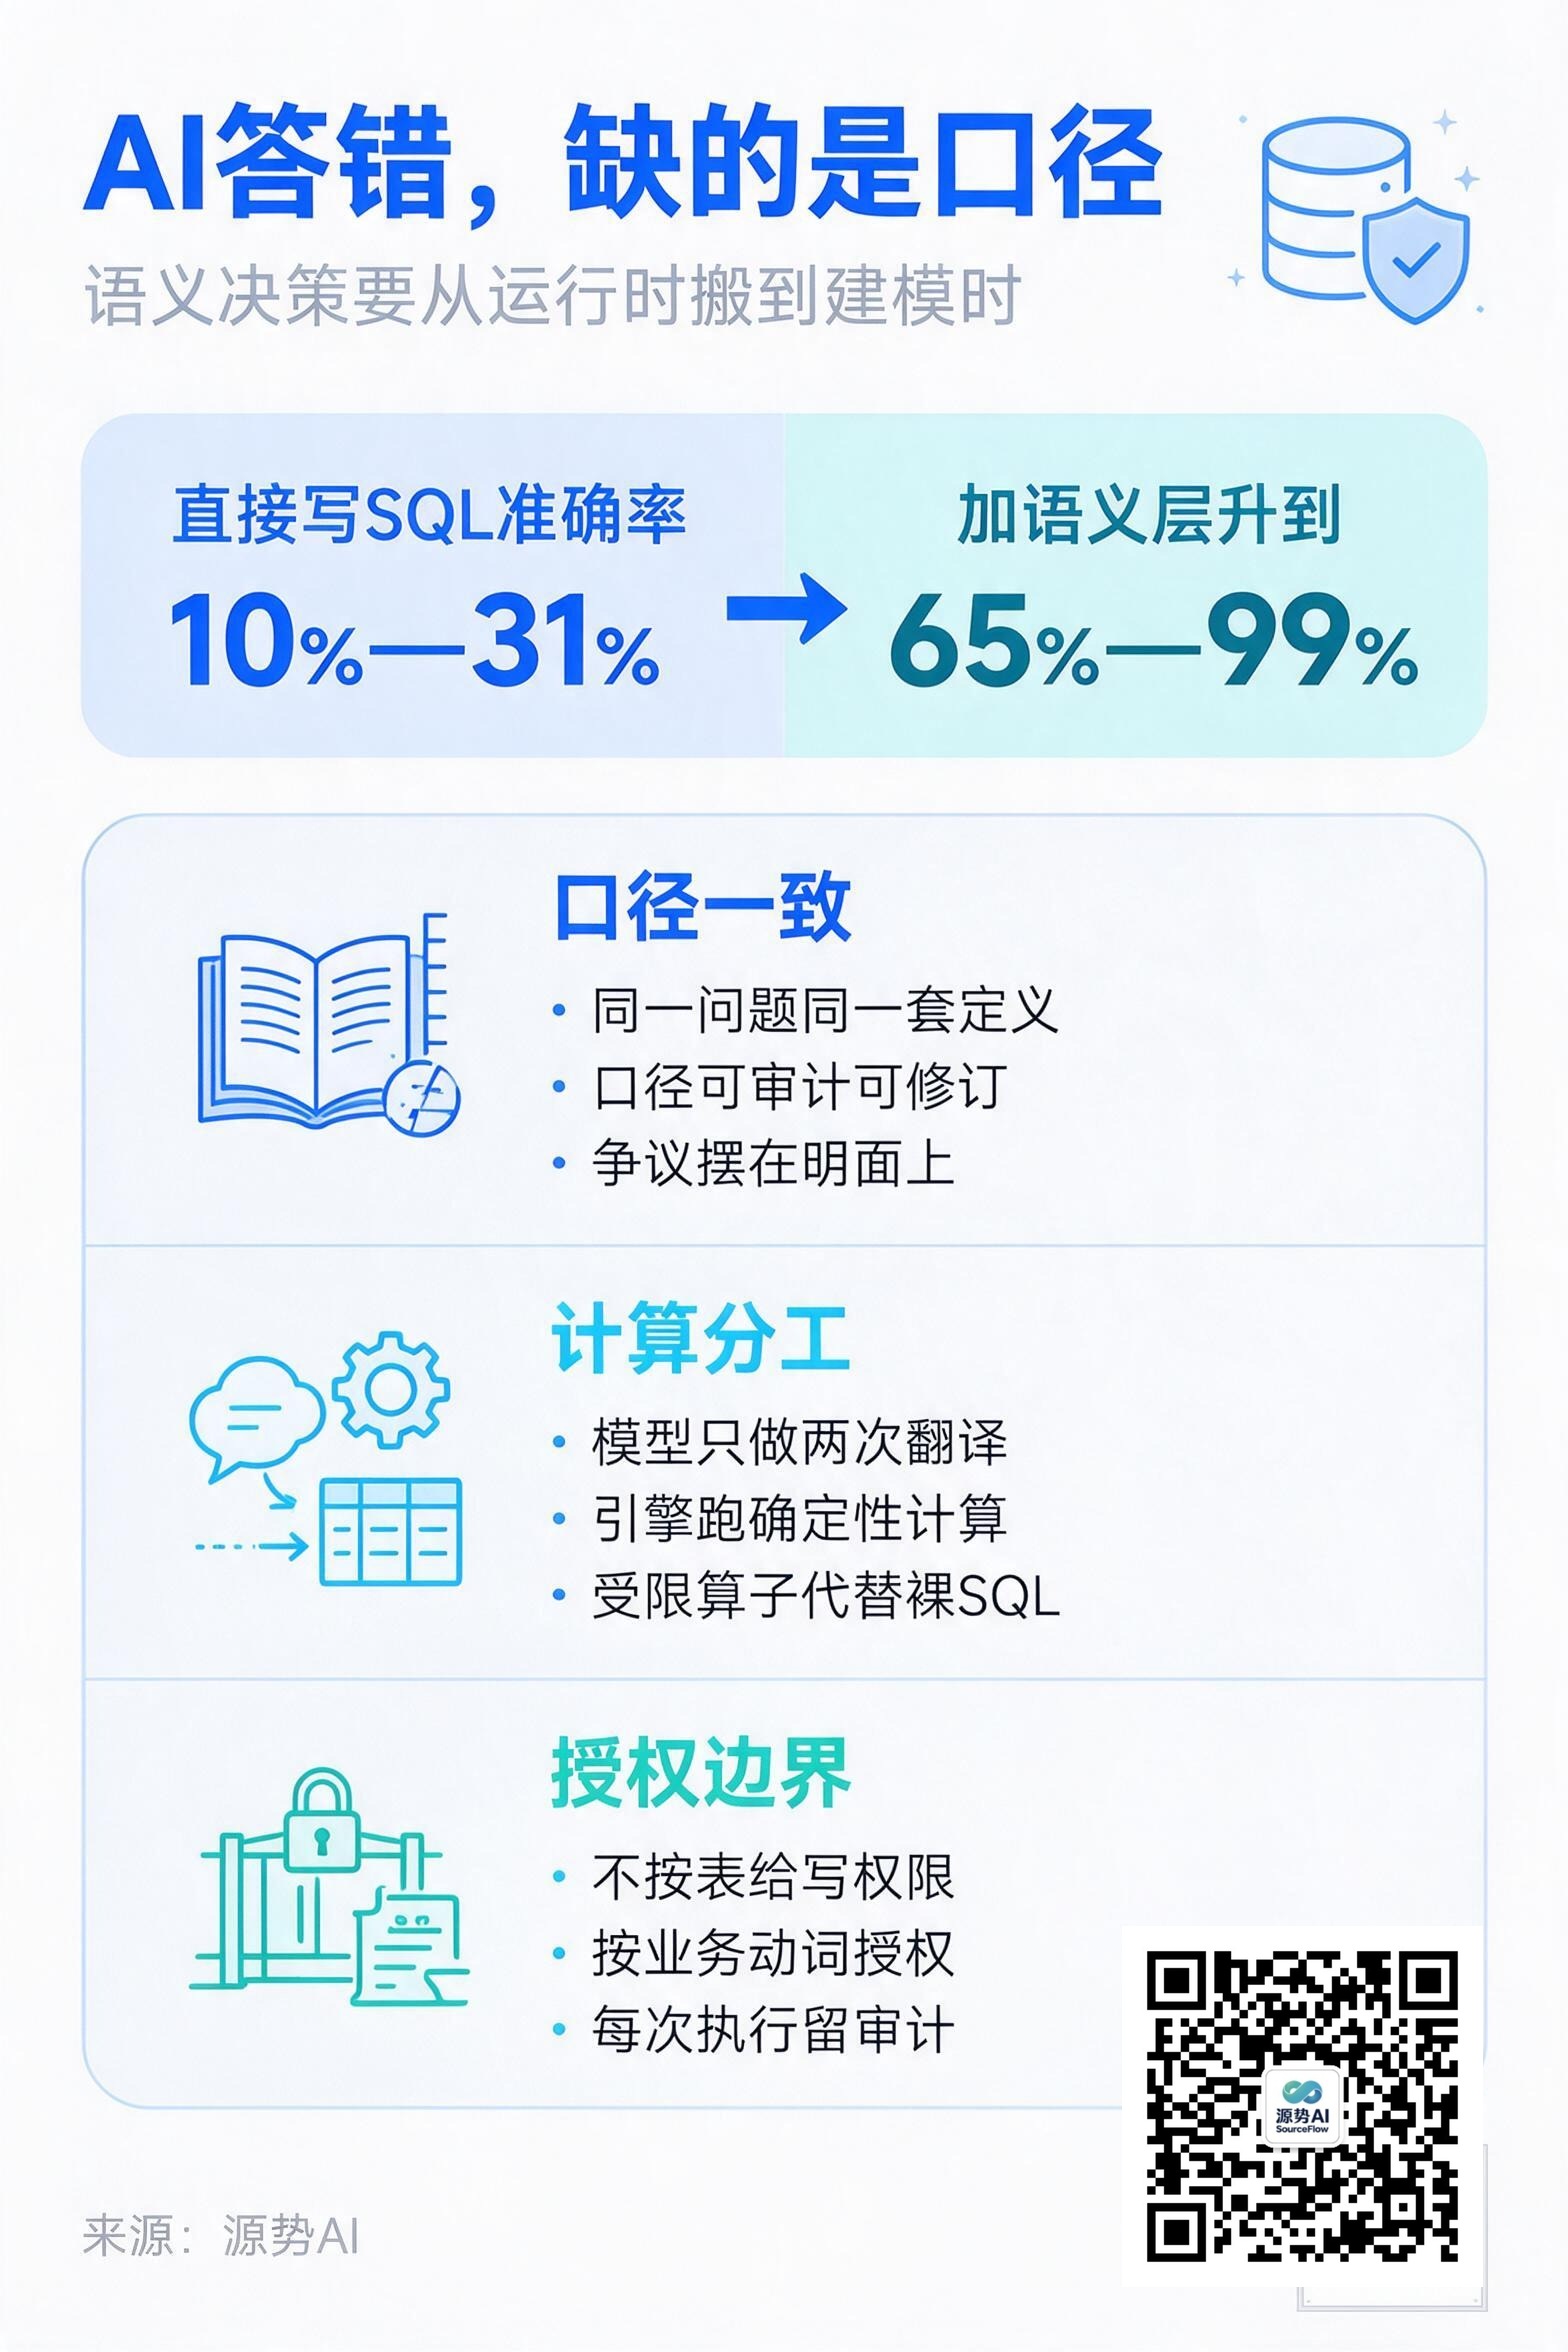
本体的解法是一次搬家:把语义决策从运行时搬到建模时。"门店月度业绩"被显式写成一条明文规则——以动销实收为准、按结算周期归集、开业未满 90 天不参与同比。
结果是口径唯一、口径可审计,争议被放到一个公开且可修订的位置(来源:《万字长文说清Palantir式本体对AI的真实价值》)。
收益有外部证据。2025—2026 年多个针对企业真实 schema 的基准测试显示,让 LLM 直接对生产库写 SQL,准确率只有 10%—31%;引入显式语义层之后跃升到 65%,部分场景达到 92%—99%。
计算的事,不该交给语言模型
口径定清楚,第二个问题更硬:下滑门店里,哪些不是客流问题,而是订货节奏问题——鲜果类报废率连续四周高于同城均值,同时招牌产品又频繁估清下架?
这个问题的内核,是跨订货记录、报废登记、POS 动销、估清日志四类数据,带时间窗的聚合、分组对比和多条件集合运算。
笔记里的判断很准:LLM 是概率性的语言器官,不是确定性的计算器官。它没有稳定的候选全集,计数靠印象而非枚举,过滤靠联想而非谓词。这类问题问三遍,名单漂移三次,每份都配着自洽的解释。
解法是分工重构:LLM 只做两次翻译——把问题翻译成结构化查询,把结果翻译成自然语言。中间的计算交给确定性引擎。
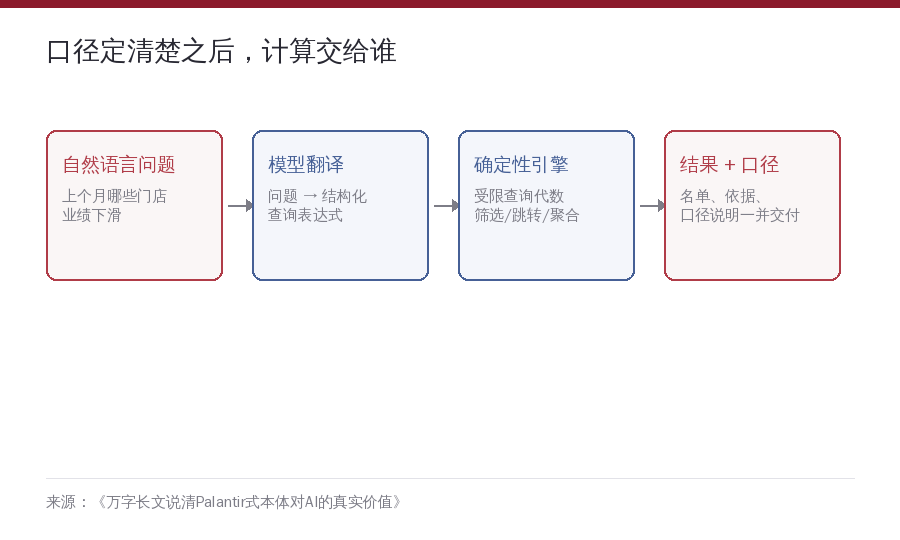
图注:模型翻译问题,引擎执行计算——分工的目的是让概率器官碰不到计数
关键在"受限"。成熟的本体系统暴露给 AI 的不是全功能 SQL,而是一套封闭的查询代数:筛选、沿关系跳转、聚合,算子的输入输出都是对象集,只能在给定的积木里组合。对 Agent 而言,防错性比表达力更重要——表达式树能在每个节点注入权限过滤、静态估算代价、在类型层面拒绝非法组合。RAG 在这里补不上洞,它把召回内容交回模型做运行时推理,计数和聚合仍由概率器官承担。
让它动手之前,先定义业务动词
读的事说完,接下来是写——往供应链 ERP 里写真实的订货单。
风险在这里质变。读错了可以重问;订货单提交了,仓库就要备货、冷链要排线、财务要挂应收。
本体体系的解法是把"写"建模为业务动词而非数据操作。AI 不能执行"INSERT INTO 订货单表",只能调用一个被预先定义的 Action:"提交门店订货调整"。
这个 Action 声明了参数约束、提交条件、副作用清单和审批要求,每次执行留下完整的审计事件。调整幅度超过该店历史均值 30% 的单据,自动转门店与督导双确认(来源:《万字长文说清Palantir式本体对AI的真实价值》)。
这一层回答了一个很多企业还没问清的问题:组织可以给 AI 授权的最小安全单元是什么?答案不是"一张表的写权限",而是一个语义完整、约束齐备、审计内建的业务动词。边界用业务语言写成,供应链负责人看得懂、签得了字。
五个系统里的五个"门店"
同一家"国贸店",在 POS 里是一个门店编码,在外卖平台是另一个店铺 ID,在小程序里是"归属门店",在 ERP 里是一个收货点。每个系统里的它都没错,但没有任何地方声明这五个它是同一家店。
对人,这是月底对账会硬扛的老问题。对 AI 就被急剧放大:跨系统的问题要求它同时理解五个系统的接口语义、库表结构和隐性口径,并在运行时自行完成实体对齐。语义负担不是相加,是相乘。
解法是建立组织级的唯一语义契约。这是六层里工程成本最高的一层,因此有个明确的合算判据——跨系统需求密度。
世界形状的模型,还是问题形状的表
给单个问题建一张专用宽表,效果并不输本体。但下一周问题换了形状,就要再建一张。更隐蔽的是各表口径会悄悄不一致,第一层辛苦消灭的答案漂移,在表的集合层面借尸还魂。
宽表的 schema 是从某一个具体问题反推出来的,它是问题形状的。本体建模是世界形状的:不面向具体问题,而面向"这个生意里有什么"。这本质上是给业务做数字孪生。
《知识图谱如何提升智能体的能力》从另一条路径走到同一个位置:用实体—关系—属性三元组,为智能体提供显性、确定性、可校验的结构化知识底座,补的正是大模型实体混淆、随意编造关联、长链路推理断裂这几个短板(来源:《知识图谱如何提升智能体的能力》)。
源势AI怎么看
本体正在变成新的营销标签,风险也在这里:抄形不抄神的本体平台,大概率会变成又一代没人用的数据治理工程。
我们的判断是,不必一上来就建全量本体,按病抓药更划算。只在单个系统内做分析,语义层工具加受限查询就够;问题一旦开始跨系统、跨部门、跨时间,再谈组织级语义契约。
三条能落地的动作。第一,把口径从提示词里搬出来,写进可版本化的定义,哪一条被谁在什么时候改过,能查。第二,凡计数、聚合、多跳关联的问题,一律不让模型直接回答,改成"模型翻译问题、引擎执行计算"。第三,AI 的写权限不按表给,按业务动词给,每个动词自带约束、条件和审计。
一个组织真正稀缺的不是模型能力,是那套所有人都认的口径。
