两家公司部署了同一种基础模型。刚上线时,它们的能力起点差不多。
之后,一家公司遇到失败案例,留在日志里等工程师有空再排查;另一家公司把这些反馈整理成训练材料,定期更新模型,并回头检查改进是不是真的生效了。
半年后,两边的模型架构可能还是一样,业务表现已经拉开差距。区别不在部署那天,在部署之后。
9 月 6 日,OpenAI 披露 Agent 已参与内部的代码编写、实验运行和结果分析;更早之前,Google 发布 Gemini 3.8 Flash 时也提到,长期运行的 Agent 循环参与了底层模型的评估与改进(来源:《RSI走向产业,需要怎样的基础设施?》,DeepTech深科技)。
图注:起点相同,分岔发生在"部署之后"这段没人排进计划的时间里
会工作,不等于会成长
一家做 GUI Agent 的团队踩过这个坑。他们想让 AI 像人一样操作图形界面——识别屏幕内容、点击按钮、填写表单。先换更强的视觉语言模型,再补提示词和规则,又补数据做监督微调。
已知任务的成功率确实上去了。但新的应用、新的界面一出现,表现又回落。
团队能修好一个问题,却无法让这次修复自动减少下一次维护的工作量。这家团队后来把这种状态概括成一句话:今天的 Agent 已经会工作,但还不会成长。
这不是 GUI 场景的专属困境。软件界面会更新,生产物料会更换,业务规则和验收标准也会变。环境每变一次,Agent 就可能冒出新错误。基础模型升级能提高通用能力,却替不了企业做场景适配——哪些错误可以容忍、什么情况下必须转交人工,这些要求来自具体业务,得靠数据和反馈进系统。
四条用来验真的标准
判断一套系统有没有持续改进能力,第一件事是看经验有没有真的进入模型。
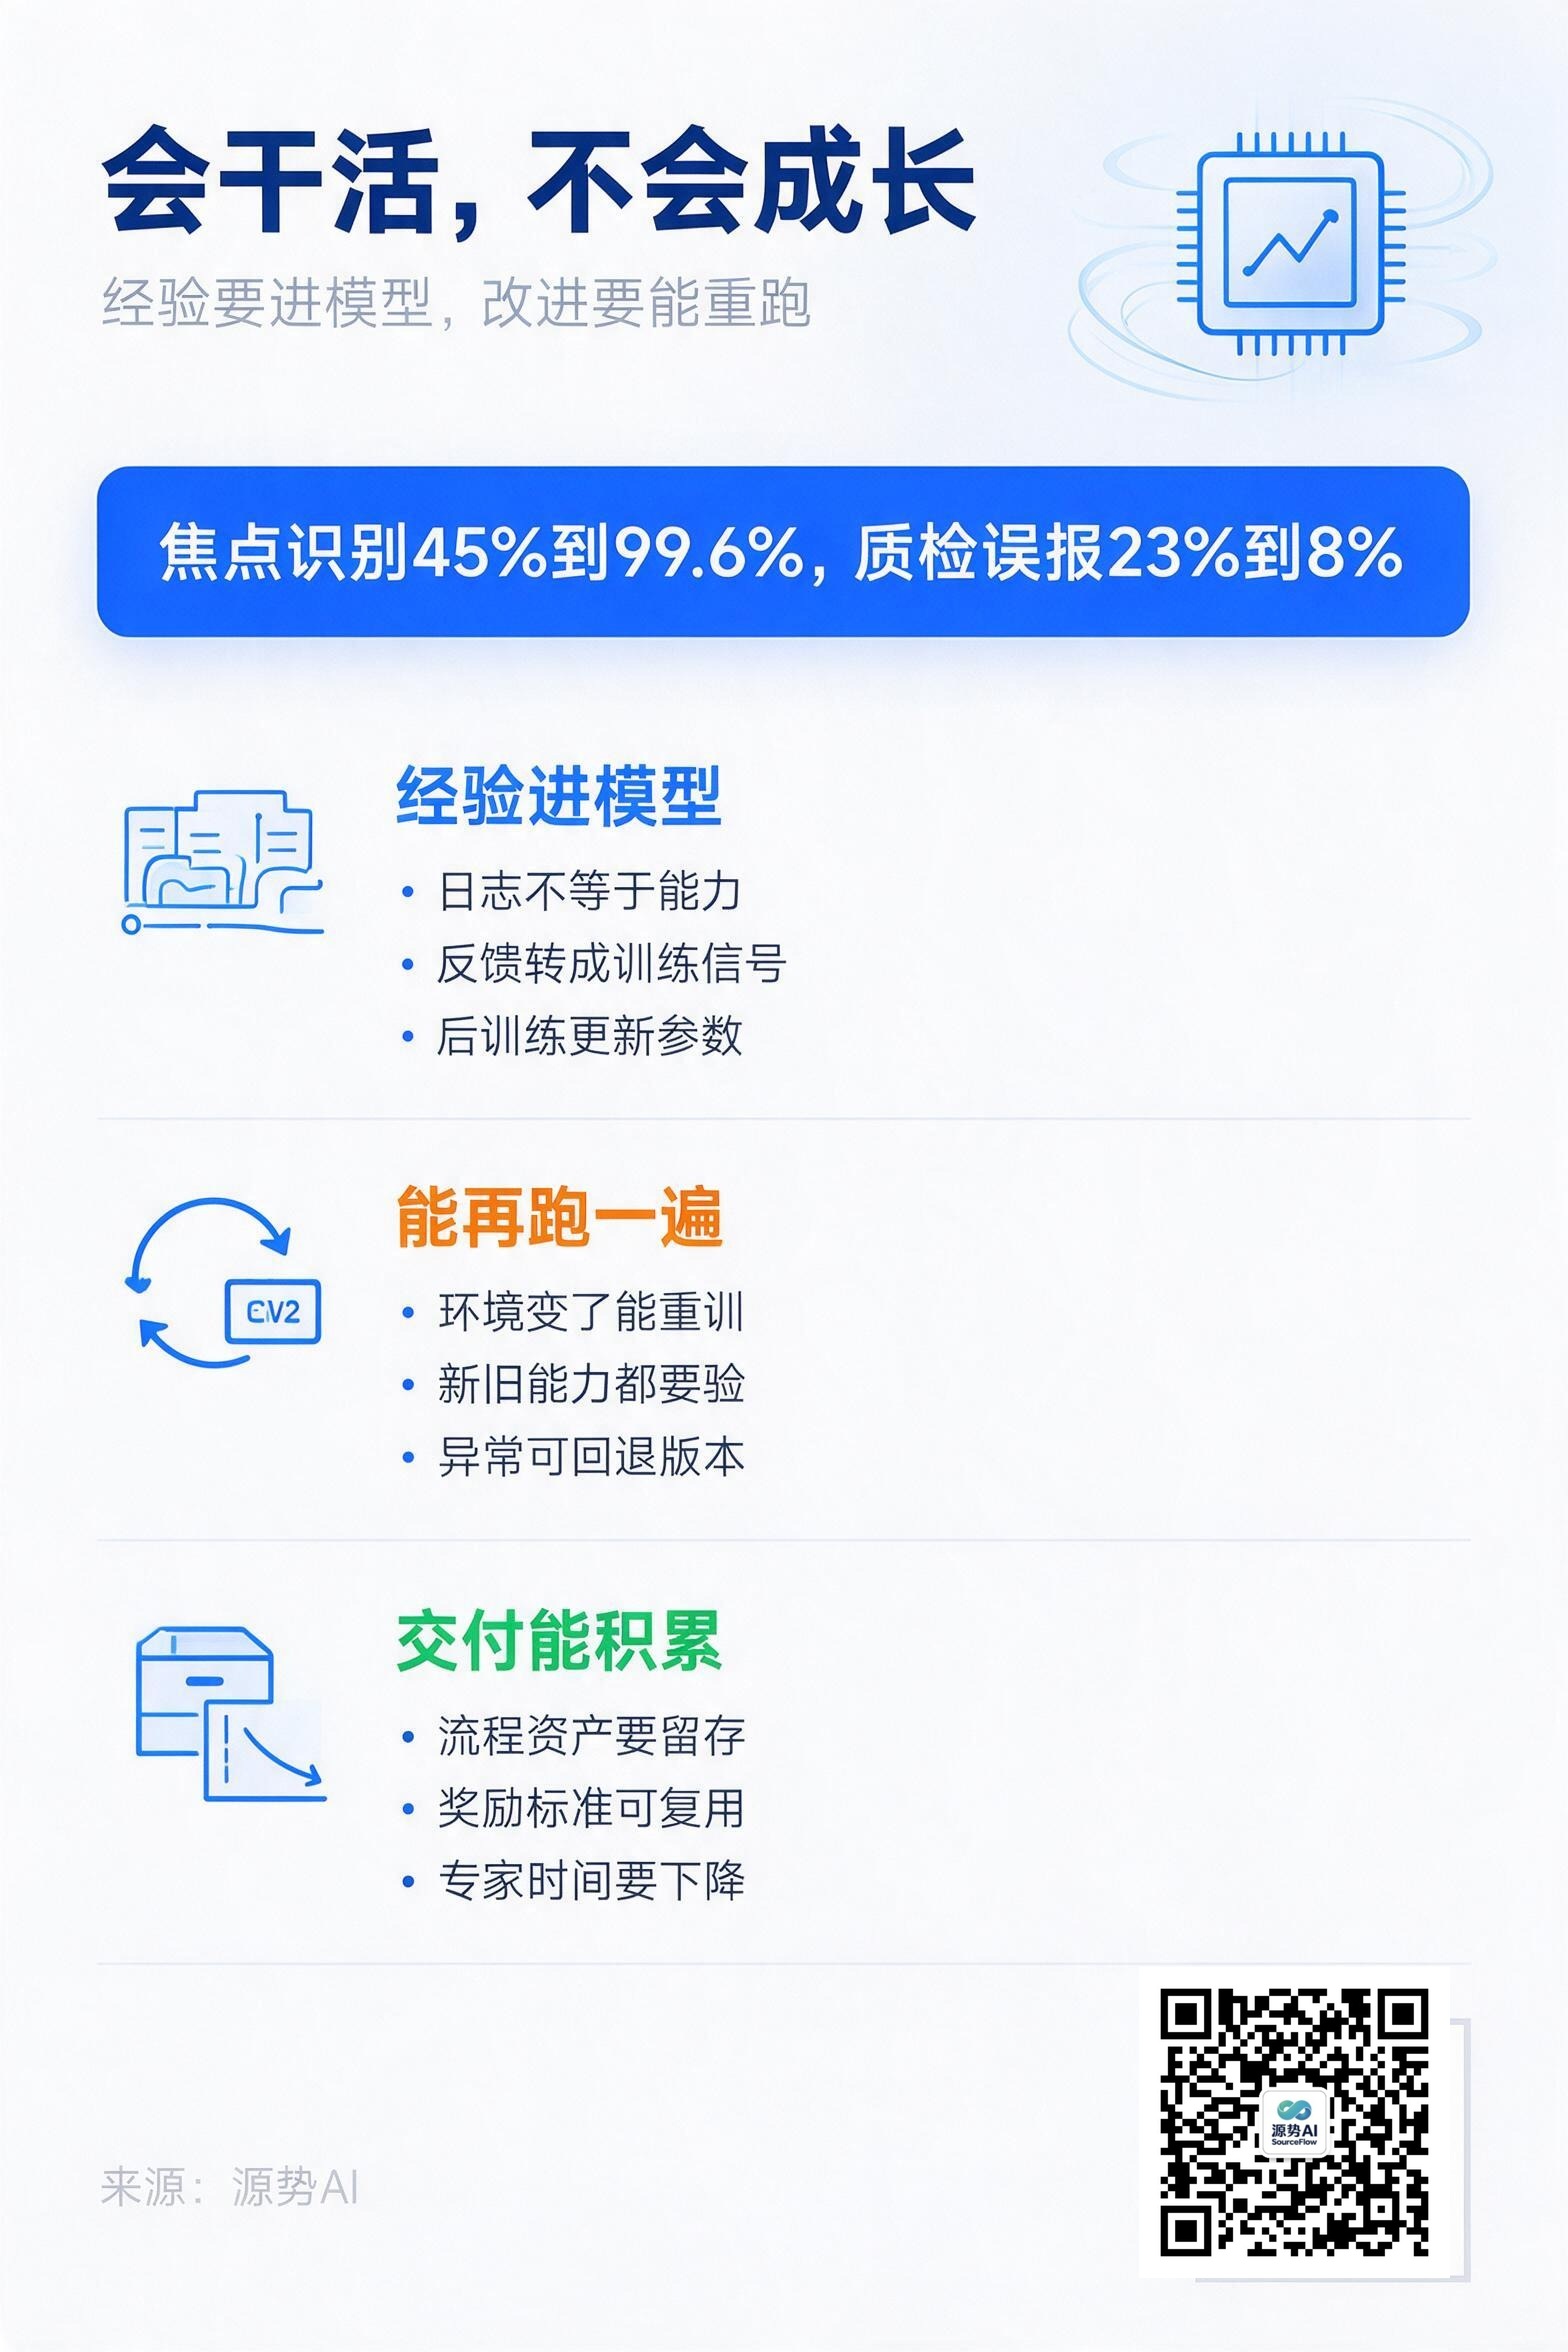
Agent 在真实任务里会留下执行轨迹、失败案例和用户反馈。很多系统攒了一堆日志,但这些信息只被用于检索、提示词优化或人工排查,那仍然属于模型之外的辅助能力。后训练是另一条路:把业务反馈转成训练信号,更新模型参数(来源:《RSI走向产业,需要怎样的基础设施?》,DeepTech深科技)。
第二件事更难:环境变了,流程能不能再跑一遍。新数据进来,训练和评估能否重新触发;新能力有没有提高,旧能力有没有退化;异常出现时能不能回退到可靠版本。
第三件事看交付能不能积累。新客户、新场景接入时,数据处理、训练调度、实验管理和评估方法能否沿用,决定了这套系统能不能规模化。如果每个项目都要投同等规模的专家团队重新设计,持续学习就形不成规模经济。
最后一件事落到经济账上。准确率、任务成功率的提升,要对应人工成本、质量损失或维护投入的下降。
三个场景,验的是同一件事
和欢网的合作里,团队对 Qwen3-VL-4B 做强化学习训练,任务是 Android TV 的遥控器操作:系统要先判断电视屏幕上当前选中了哪个元素,才能执行下一步。训练后,焦点识别准确率从约 45% 提升到 99.6%。数据来自真实电视界面的操作轨迹,里面有成功操作,也有失败尝试。
华秋项目验的是另一环——专业规则能否转成训练和评价标准。面向工业场景的电子元件专业输出任务,训练后渲染相似度的 IoU 从 0.2 提升到 0.65。
到了具身智能,循环的起点又变了。机器人要从经验里学习,先得稳定记录真机执行时的动作、状态和环境信息。R2VLA 方案在真机环境下连续采集 24 小时数据、无需人工遥操作,把数据采集链路的时间缩短了 50% 以上。
经济账也有一组:在约 1 万张样本上,一个质检任务的误报率从 23% 降到 8%。误报下降直接减少人工复检工作量,再结合漏检风险、质量损失和训练投入,客户能自己判断一次更新值不值。
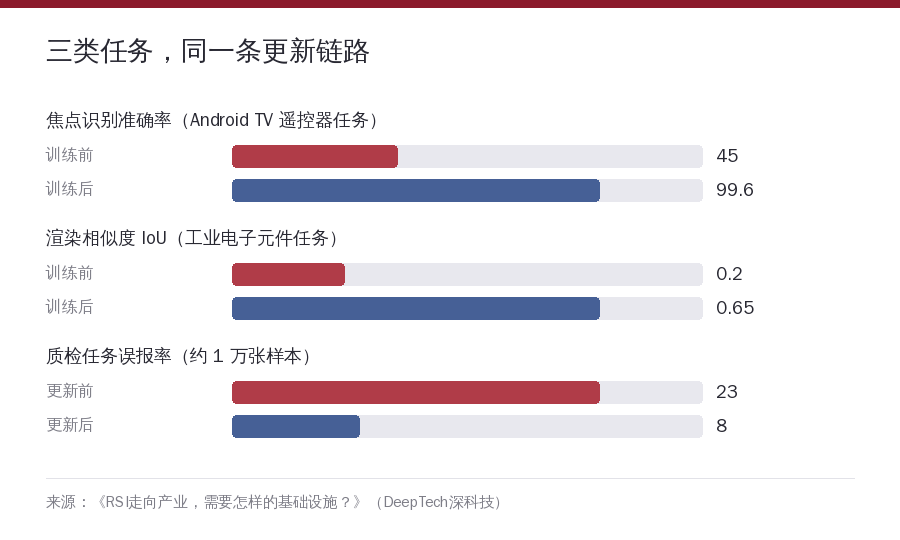
图注:三组数字来自三类不同任务,验的却是同一条更新链路
但跨场景复用的边界同样清楚:训练调度、数据处理、实验管理可以复用,行业知识、奖励函数和合规要求得重新适配。电视界面的操作反馈,迁移不到工程图纸里。
另一条路:主战场可能不在权重
关于 RSI 往哪走,行业里有个不同的判断值得摆出来。
前 OpenAI 科学家翁荔的观点是,递归自我改进的主战场不在权重,而在 Harness——也就是模型和真实世界之间那一层编排执行、调用工具、管理记忆与评测的系统。她的推演是,近期路径不太可能是一个模型直接重写自己的权重,更现实的方向是模型改进训练流水线和部署系统(来源:《前OpenAI科学家翁荔:递归自我改进RSI的主战场不在权重而在Harness》)。
两条路不冲突,但取向不同。走权重那条,经验沉淀在参数里,代价是每次更新都要动模型、都要重新验证;走 Harness 那条,经验沉淀在流程和工具里,改起来轻,天花板受限于基座。
翁荔也点了一个硬约束:智能仍是天花板。同一套递归结构,放在强模型上随迭代进步,放在弱模型上反而退化。递归结构本身不够。
源势AI怎么看
持续学习这件事,最容易被做错的地方是把它当项目做:上线时投一波数据、训一次模型、交一份报告,然后收工。环境一变,前面攒的东西全部作废。
我们的判断是,企业真正该建的是一套机制,而不是一次训练。三层要拆清楚:哪些判断必须由人给(质量风险和人力成本之间怎么权衡,这是业务决策,通用模型猜不出来);哪些环节必须自动化(数据清洗、训练调度、评估回归、版本比对);哪些资产必须留下来(任务定义、奖励标准、评估口径、版本记录)。
还有一条容易被忽略:不是所有任务都值得训。流程稳定、异常有限的标准工作,用提示词、知识检索和固定工作流就已经经济。真正需要持续训练基础设施的,是业务环境经常变化、专业反馈持续产生、人工维护成本已经压不住的那类场景。
判断投入是否划算,看一个指标就够了——随着项目数量和更新轮次增加,每次新增交付需要的专家时间,是在下降,还是原地不动。
