一次跨部门评审会上,隔壁团队展示他们的 AI 平台:一张巨大的 DAG 图铺满整面墙,二十多个 Agent 节点用箭头串成流水线——意图识别、路由分发、知识检索、代码生成、内容审核,每个节点都是独立 Agent,全部听命于一个中心的 Orchestrator(来源:《90% 的人在堆 Agent 编排,但终极形态是 Swarm》)。架构师说,我们用编排解决了所有问题。有人问了一句:Orchestrator 挂了怎么办。会议室安静了几秒。
这不是编排不好,而是当 Agent 数量过了十几个,中心化调度的天花板就压下来了。
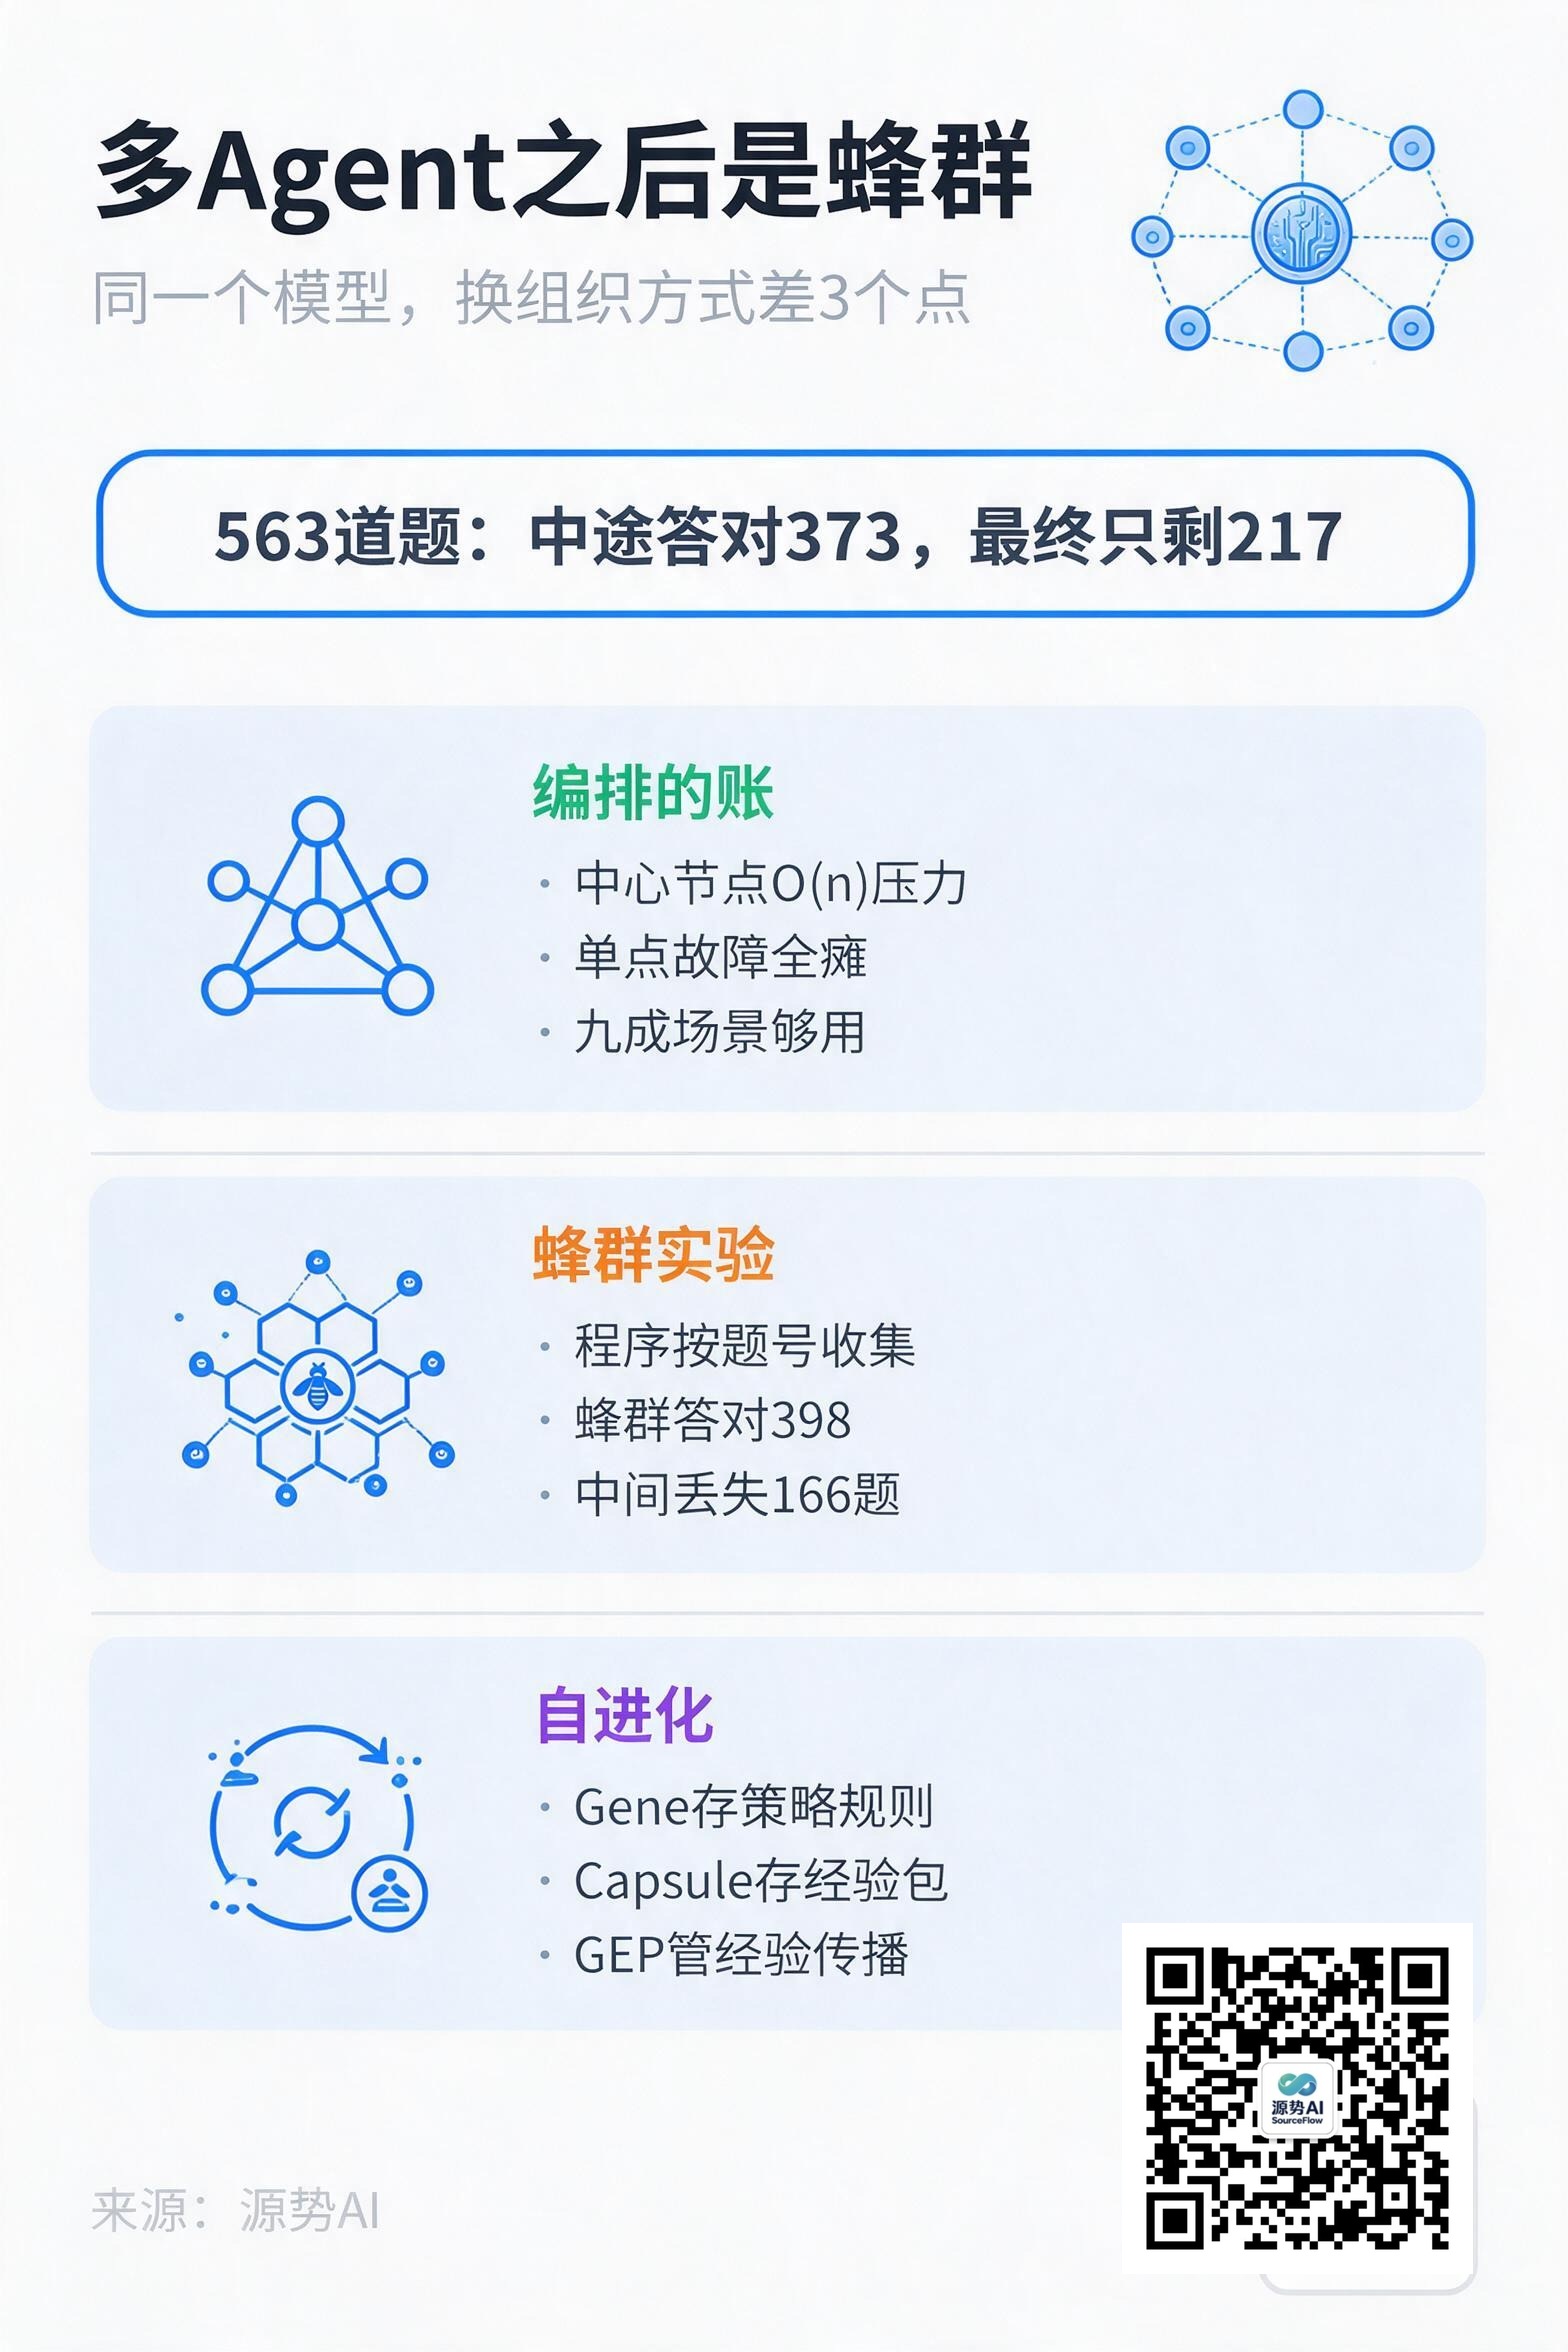
现在主流的两种多 Agent 做法,Orchestrator/Worker 和 Supervisor/Worker,底色是同一个:中心化。中央调度器分发任务给子 Agent,子 Agent 干完再交回来。麻烦出在两处:调度压力随节点数线性增长,中心节点的负担按 O(n) 走;中心节点本身是单点故障,它一挂,整条流水线停摆(来源:同上)。
Swarm 换了思路。它借的是一个叫 Stigmergy 的概念:蚂蚁留信息素,蜜蜂跳八字舞,鸟群没有领头的,每只鸟只跟相邻几只保持规则,整体却飞出了秩序。落到 Agent 系统,就是去掉调度中心,让 Agent 通过共享消息空间自组织和协商。四个维度的差别摆在一起是这样的:控制流从中心化 DAG 变成去中心化 P2P,决策从集中调度变成自治协商,扩展性从 O(n) 瓶颈变成理论上 O(1),容错从单点故障变成天然高可用。代价写在最后一栏——复杂度上去,行为更不可预测。
把话说清楚:Swarm 不是编排的替代。九成场景里一个 Orchestrator 就够了,硬上蜂群只是给自己找麻烦。它真正对的场景,是需要高弹性、高容错、任务边界动态变化的那一类。
563 道题:中途答对 373,最后只剩 217
蜂群到底比编排强多少,得看实验。
EvoMap 团队在 2026 年 7 月 25 日公布了一组蜂群实验:563 道题,三种模式用的是同一个 Claude Haiku 4.5,题目和评分标准完全相同,只改任务怎么拆、怎么执行、怎么汇总(来源:《EvoX——一个会积累经验、自主组队的蜂群多智能体平台》)。
Sub-Agent 模式在中间结果里答对了 373 道题。但经过报告传递和主 Agent 汇总,最终只保留 217 道正确答案——166 道一度正确的题,在最终交付里变错或消失,中间正确答案的保留率 55.50%。
蜂群路径没有让另一个模型去重新总结所有答案,而是让程序从约定位置按题号收集结果,最终答对 398 道,成功率落在 70.69% 到 70.87% 区间(有一道题网络请求超时,所以给了个区间)。
这组数字真正说明的,不是「Agent 越多越强」,而是三件工程问题:任务能不能完整拆开;每个 Agent 能不能在隔离上下文里专心处理一小块;已经正确的结果,能不能无损抵达交付。
图注:蜂群与编排的根本差别在最后一步——汇总交给确定性程序,而不是再交给一个模型重新理解
同一个模型,换组织方式,差 3 个点
华为支持的开源 Agent 平台 openJiuwen 发布的蜂群智能体 JiuwenSwarm,给了另一个任务集上的对照。它按四个问题组织体系:Agent 怎么组队、协作经验怎么沉淀、沉淀的能力怎么流通、系统怎么越用越强,对应 Leader+Teammate 分级架构、Swarm Skills、Skills Hub 和自演进引擎(来源:《华为openJiuwen的范式跃迁:从龙虾到蜂群》)。
结果放在 PinchBench 上:JiuwenSwarm 综合得分 94.2% 拿到 SOTA,此前单智能体路线的代表 OpenClaw 是 91.6%,同时平均 token 消耗降低 34.8%。办公场景开启算力亲和后,响应速度提升近 16%,关键存储资源消耗下降两到三成。
值得注意的是,这 3 个百分点不来自更强的模型。同一个大脑,换一套组织方式,结果就变了——这才是蜂群范式值钱的地方。
openJiuwen 还改了一件事:人机关系。过去的默认模式是人站在蜂群之外当管理者,审批关键操作、调优先级;新方案把人作为 Human Agent 放进会话里,与 AI 成员同流程协作。这一步把协作粒度从「人指挥 AI」推进到「人机共同决策」,但也对实时协商、身份管理、信息隔离提出了更高的工程要求。
自进化,进化的不是权重
看到「自进化」三个字,很多人的第一反应是模型是不是在偷偷改自己。
至少在 EvoX 这条线上不是。它的自进化发生在三层:长期记忆、经验资产、协作关系。Evolver 引擎会把一次成功的协作转成可复用的资产,项目里用了两个生物学名字——Gene 偏可复用的策略和规则,Capsule 偏经过验证、能迁移的经验包。Evolver 本身是个 Prompt 生成器,不是自动改代码的工具:它扫描日志和错误信号,选出匹配的 Gene/Capsule,生成受协议约束的提示,留下可审计的 EvolutionEvent 记录。
经验怎么在 Agent 之间流通,EvoX 用 GEP(Genome Evolution Protocol)来定义。这个对照有意思:MCP 解决的是 Agent 怎么连工具,GEP 想解决的是经验资产怎么表达、验证、继承和传播。工具的接口标准打得差不多了,经验的接口标准才刚有人提。
先泼一盆冷水
70.69% 这个数字不能外推。
那 563 道题天然容易拆成互不依赖的单题,完整拆分由脚本保证;而真实的软件项目、市场研究、产品方案,任务之间存在依赖、冲突和动态变化。官方文章自己也承认,自主拆解、自主认领任务、Agent 之间的信息交换,还需要后续实验继续验证。EvoX 目前还在 Beta。
另一件容易被忽略的事是成本口径。token 消耗降低 34.8% 是在特定评测、特定配置下测出来的,不等于在你的业务里同样成立。蜂群把复杂度从「一个 Agent 够不够聪明」搬到了「一群 Agent 怎么对齐」,这份复杂度不会凭空消失,只会换个人承担。
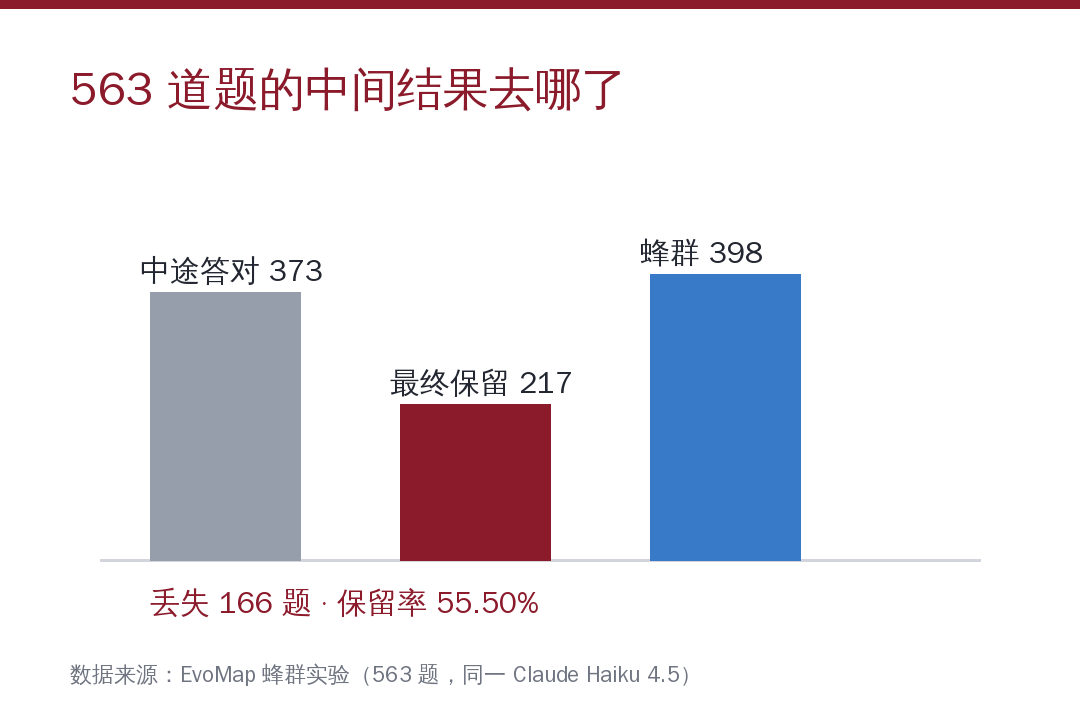
图注:同一批题、同一个模型,差别只在结果怎么汇总——166 道掉在了传递环节
源势AI观点
做 Agent 落地,我们越来越倾向于把「协作」当成一件独立工程,而不是选个框架就完事。
判断该不该上蜂群,先回答两个问题:任务能不能在开工前完整拆成互不依赖的单元;结果能不能用确定性程序合并,而不是靠再跑一遍模型。这两条都过,蜂群才轮到出场;任何一条不过,老实做编排。
我们自己在多 Agent 项目里踩过最贵的一脚,就在汇总环节——中间结果一路正确,最后一轮自然语言转述把关键字段改没了。后来把汇总从模型手里拿回来交给程序,这个问题才消失。EvoX 的 166 道题,说的就是同一件事。
编排解决的是流程,蜂群解决的是组织。流程能画出来,组织只能跑出来。
