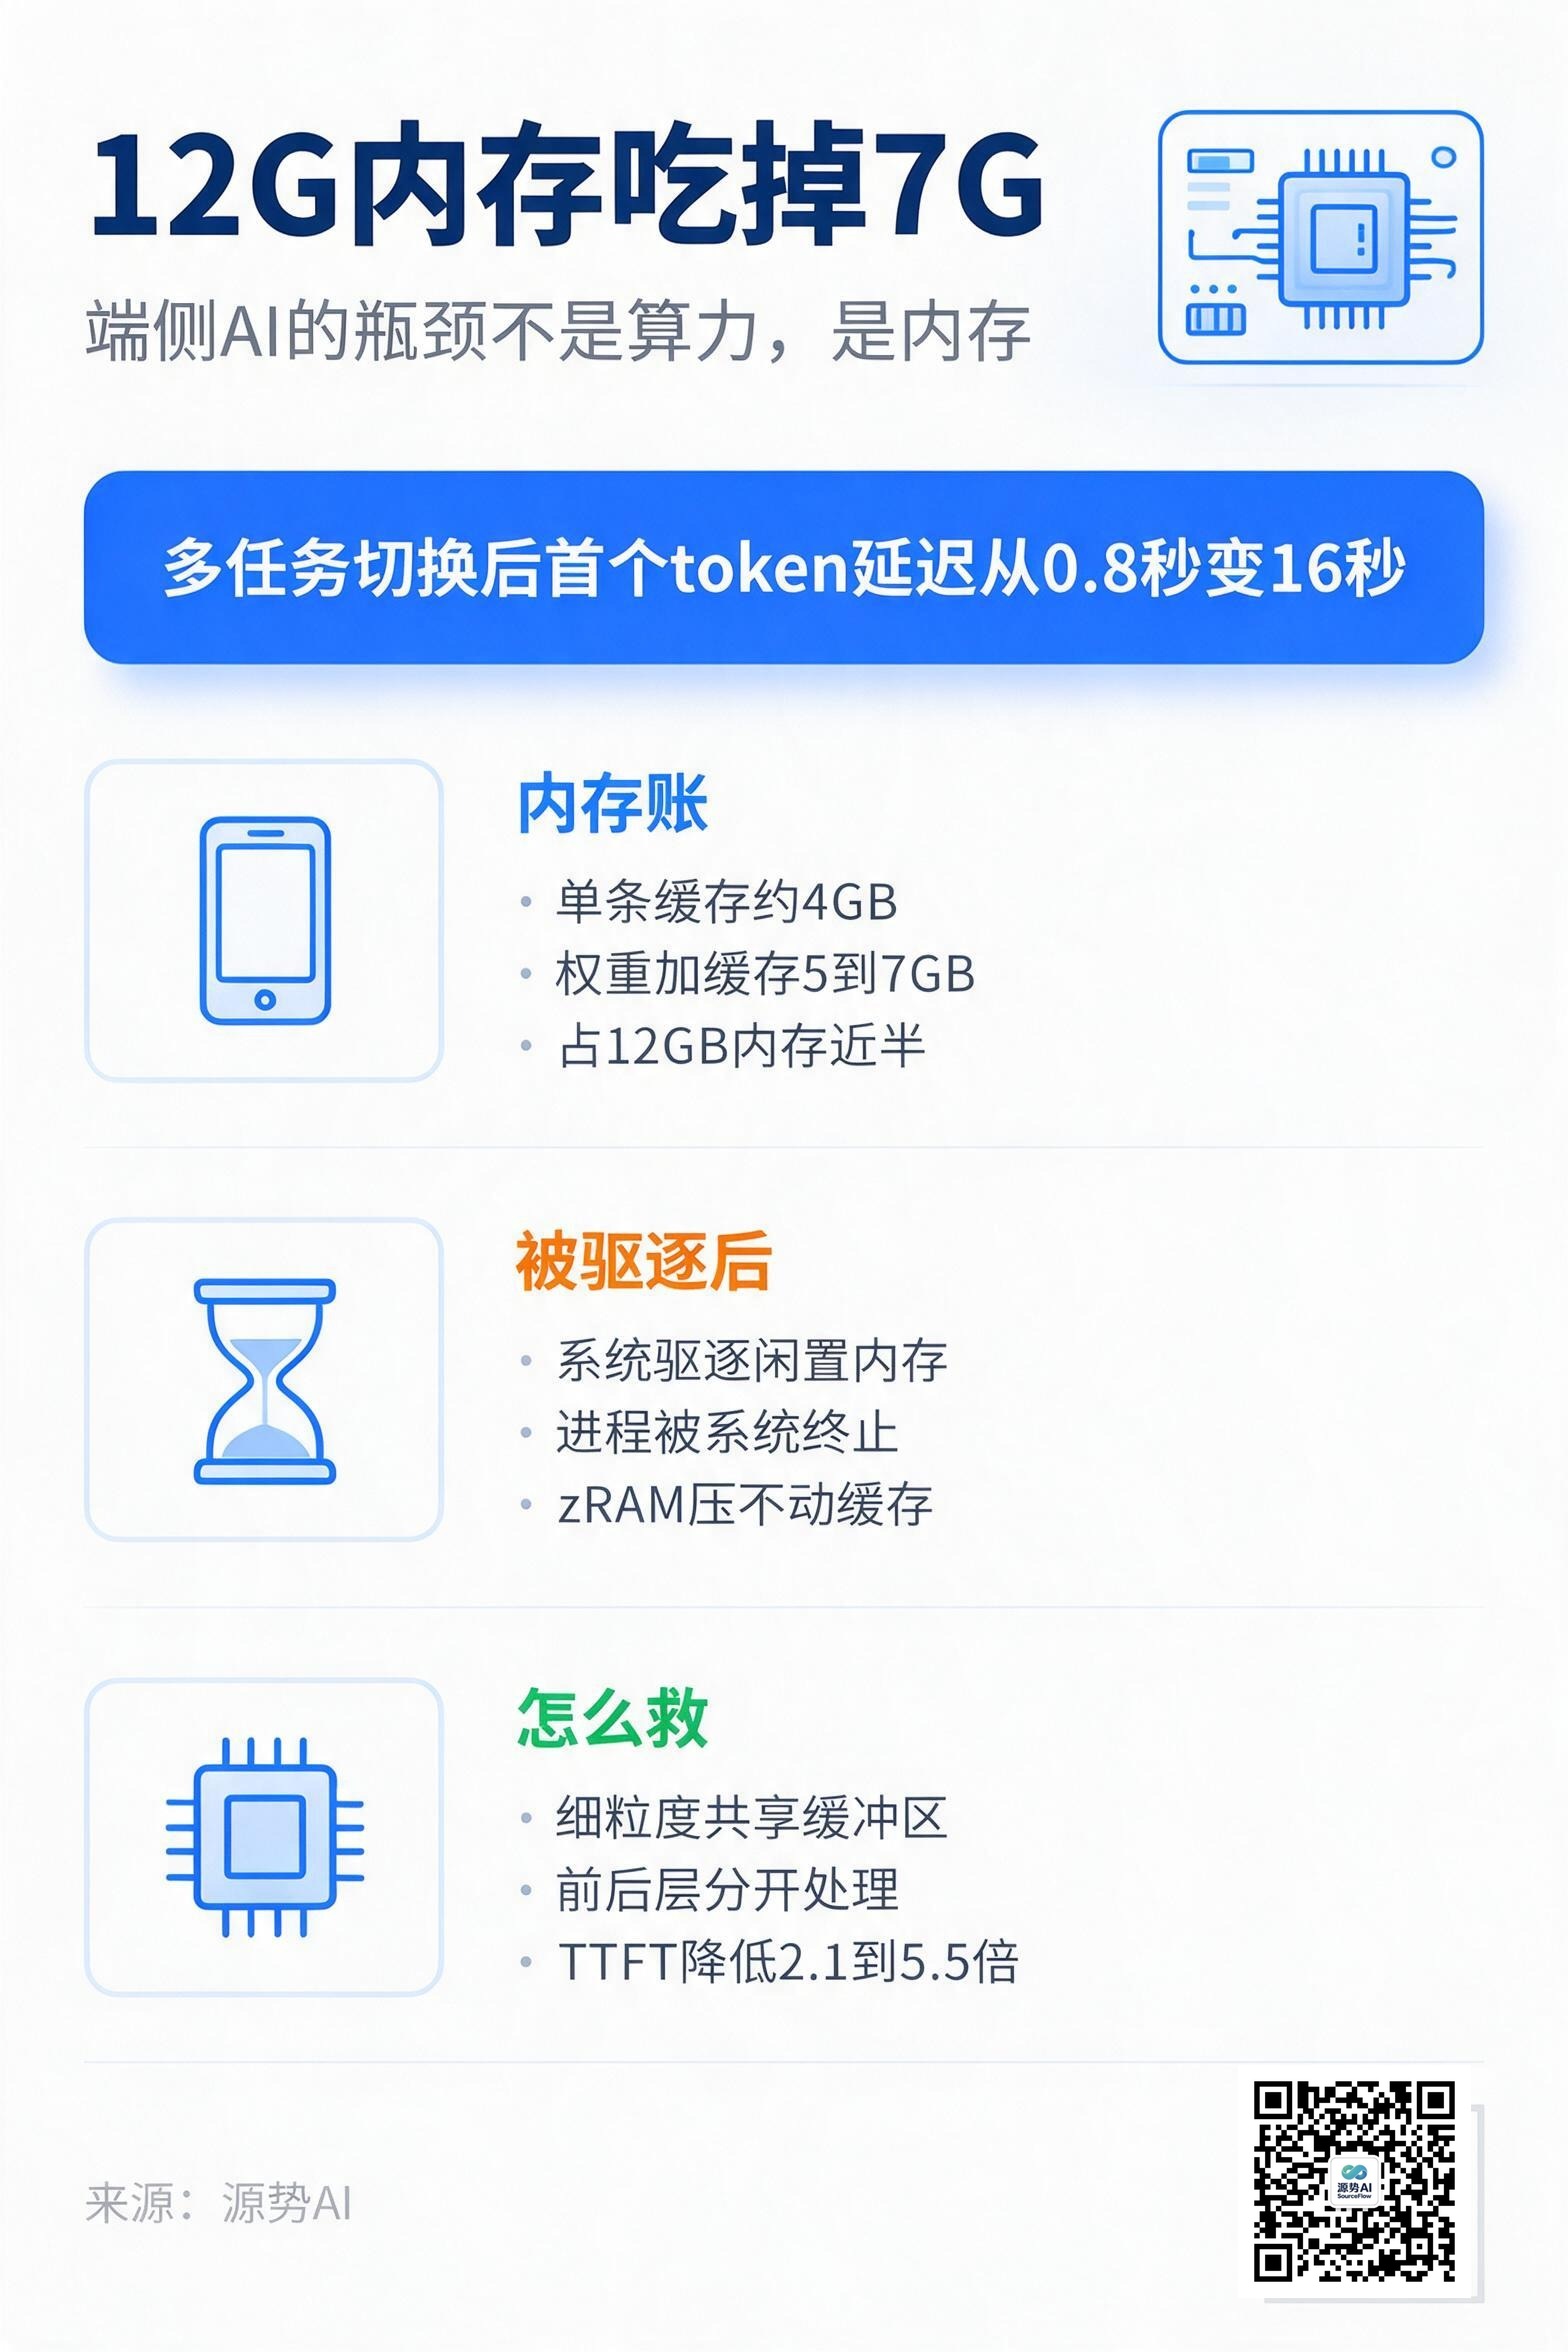
首尔大学和 UC Berkeley 在 MobiCom '26 发表的论文给出一组端侧推理的实测:移动端一条上下文的 KV cache 可以涨到约 4GB,加上模型权重,整体占用达到 5 到 7GB,接近主流智能手机 12GB 内存的一半(来源:arXiv 2609.01338《mzCache: On-Device LLM Memory Management under Multitasking》,首尔大学、UC Berkeley)。
论文的表 1 列了几个常见小模型的最大占用:EXAONE-4.0-1.2B 是 6.4GB,Gemma2-2B 是 5.7GB,Llama3.2-1B 是 6.5GB,Qwen3-0.6B 是 4.7GB,Qwen3-1.7B 是 7.0GB(来源:同上)。这些模型参数都不到 30 亿。
手机上的 AI,卡的不是算力,是内存。
一条会话,4G 缓存
KV cache 是模型记住上下文的方式。每轮对话的 key、value 向量都存下来,下次生成时直接引用,避免重算。问题在于它会累积:论文指出,即使是移动端优化过的小模型,单条长上下文也能让 KV cache 涨到约 4GB(来源:同上)。
手机厂商给 AI 功能留的内存预算本来就不宽裕。当用户一边聊天一边切到相机、游戏或视频,系统内存压力上来,操作系统会把闲置的 LLM 内存驱逐出去,腾给活跃的应用(来源:同上)。
这不是配置问题,是机制问题。
切个应用回来,从 0.8 秒变 16 秒
论文用 Galaxy S25+ 做了实测追踪,还把内存轨迹画了出来:随着内存压力上升,LLM 进程被系统的 Low-Memory Killer 直接终止(来源:同上)。进程被杀之后,用户再回到这个应用,模型要重新从存储加载权重、重算整个 KV cache。
论文给出的时间是:多任务切换后,首个 token 的生成时间(TTFT)从 0.8 秒恶化到 16 秒(来源:同上)。20 倍的差距,用户感知得到。
安卓本来有一套应对方案。zRAM 是一个基于压缩的内存交换空间,把被驱逐的页压缩后留在 RAM 里。但论文的测试结论是,zRAM 用的通用压缩算法(lz4、zstd)对 KV cache 几乎没有压缩效果,内存压力基本没被缓解(来源:同上)。
原因在数据本身:KV cache 是模型算出来的稠密向量,没有通用压缩算法能利用的结构冗余。要用它,就得有专门为它设计的压缩和调度方法。论文的结论很直接——通用的操作系统内存管理机制,对 LLM 这类负载基本不适用(来源:同上)。
图注:端侧模型的小不是问题,问题是它要一直待在内存里才有上下文记忆
端和云在分工,分工线在内存
电信终端产业协会今年 6 月发布的《手机智能体技术研究报告》,从产品侧给出了同一件事的另一面。报告把端云协同的分工写得很明确:端侧负责低延迟、高敏感和离线场景,典型任务包括简单意图理解、翻译、通话摘要、本地搜索、密码和生物特征等敏感信息处理;云侧负责深度意图理解、复杂指令拆解、跨设备协同和内容创作(来源:电信终端产业协会 R/TAF 015—2026《手机智能体技术研究报告》,中国信通院牵头,华为、OPPO、荣耀、vivo、蚂蚁参编)。
报告在同一张表里直接把端侧的挑战写成了三个词:算力、内存、功耗受限,模型能力相对较弱(来源:同上)。三个约束里,内存是最刚性的——功耗可以靠调度省,算力可以靠 NPU 补,内存不够就是进程被终止。
轻量化技术这两年进步很快。报告引用斯坦福大学的研究:2022 到 2024 两年间,在 MMLU 基准上达到同等性能的模型参数规模缩减了 142 倍(来源:同上)。端侧能力密度的提升是真的。
但这个进步有个方向性问题:参数变小,省的主要是权重。上下文越长,KV cache 占比越高,而端侧智能体恰恰要求跨应用、长链路、持续上下文保持——小米 miclaw、华为小艺 claw 这类产品的核心能力,就是"在多轮对话中维持上下文"(来源:同上)。能力越往这个方向走,KV cache 越重。
报告还提到一个细节:小米 miclaw 对核心敏感数据"用完即弃",或者优先存在本地私有目录;敏感操作要求显式确认(来源:同上)。"用完即弃"本身就是一种内存策略——用不保留缓存来换内存安全。
2.1 到 5.5 倍是怎么来的
mzCache 的解法是把内存管理从"能不能留在内存里"改成"驱逐之后多快能回来"。
具体做法有三层。第一层是把权重和 KV cache 切成细粒度的共享缓冲区,挂在手机 SoC 的统一内存上——这样可以只驱逐必要的那部分,同时让 CPU 做恢复、GPU 直接执行推理,处理器之间不需要来回搬数据(来源:arXiv 2609.01338)。第二层是路径选择:被驱逐的 KV cache 同时走"压缩后留在内存"和"写存储"两条恢复路径,两条都在用,不浪费带宽。第三层是顺序:先驱逐靠后的层,保留靠前的层,因为推理是从前向后执行的;恢复时 GPU 可以在保留下来的前几层上立刻开始算,CPU 同时按同样顺序恢复后面的层,把恢复时间和推理时间叠在一起(来源:同上)。
这三层叠起来的效果是,在基于 llama.cpp 实现并部署为安卓应用的测试中,TTFT 相比存储后端的部分卸载方案降低了 2.1 到 5.5 倍(来源:同上)。
论文里有一句话点出了整件事的性质:现有移动端 LLM 服务主要关注运行时推理优化,内存管理完全依赖系统机制(来源:同上)。也就是说,优化了半天算子,最后被一个"切应用"打败了。
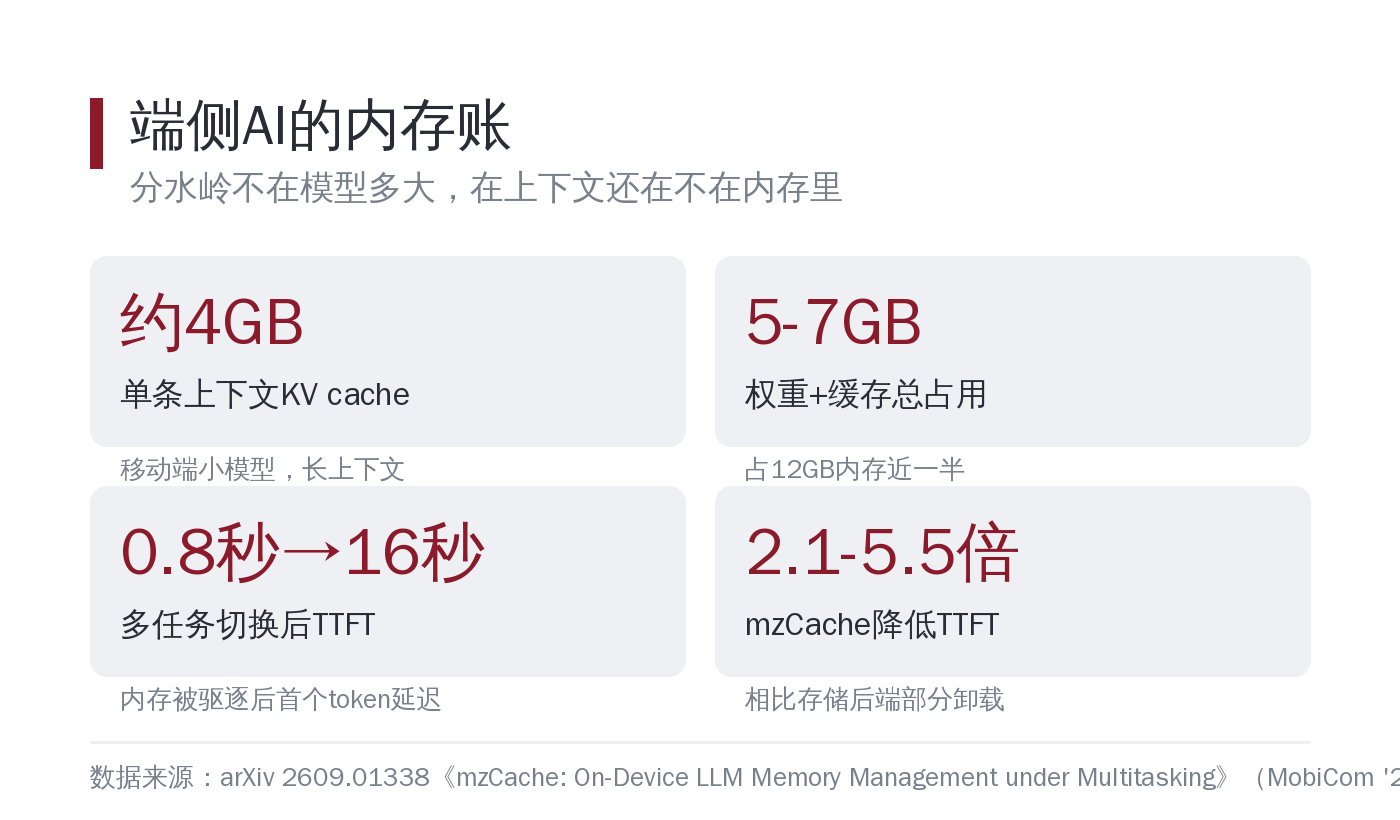
图注:端侧体验的分水岭不在模型多大,而在上下文还在不在内存里
源势AI观点
我们给客户做端侧和边缘侧部署时,内存是最常被漏掉的一行。
第一,端侧方案的容量测算要把 KV cache 算进去。很多评估只比模型参数和跑分,忽略了上下文长度对应的缓存开销。一个不到 30 亿参数的模型,长上下文时缓存能超过权重——按 4GB 这个量级预留,比按参数量估算更接近实际。
第二,把"上下文能不能保住"当成一项产品指标来测。方法很简单:跑一轮长对话,切出去打开相机和游戏,再切回来,量一下首个 token 的延迟。这个数字比平均响应时间更能反映真实体验,也直接决定了这个功能用户会不会第二次打开。
第三,内存管理层的改造优先级不低于模型优化。模型压缩收益是渐进的,而一次内存驱逐造成的体验断崖是瞬时的。安卓体系的 zRAM 和 Low-Memory Killer 都在,怎么与它们协作,是端侧 AI 工程化的必答题。
端侧 AI 的胜负手,正在从"模型能不能跑"转到"跑完之后还在不在"。
话题标签:#端侧AI #手机智能体 #内存管理
