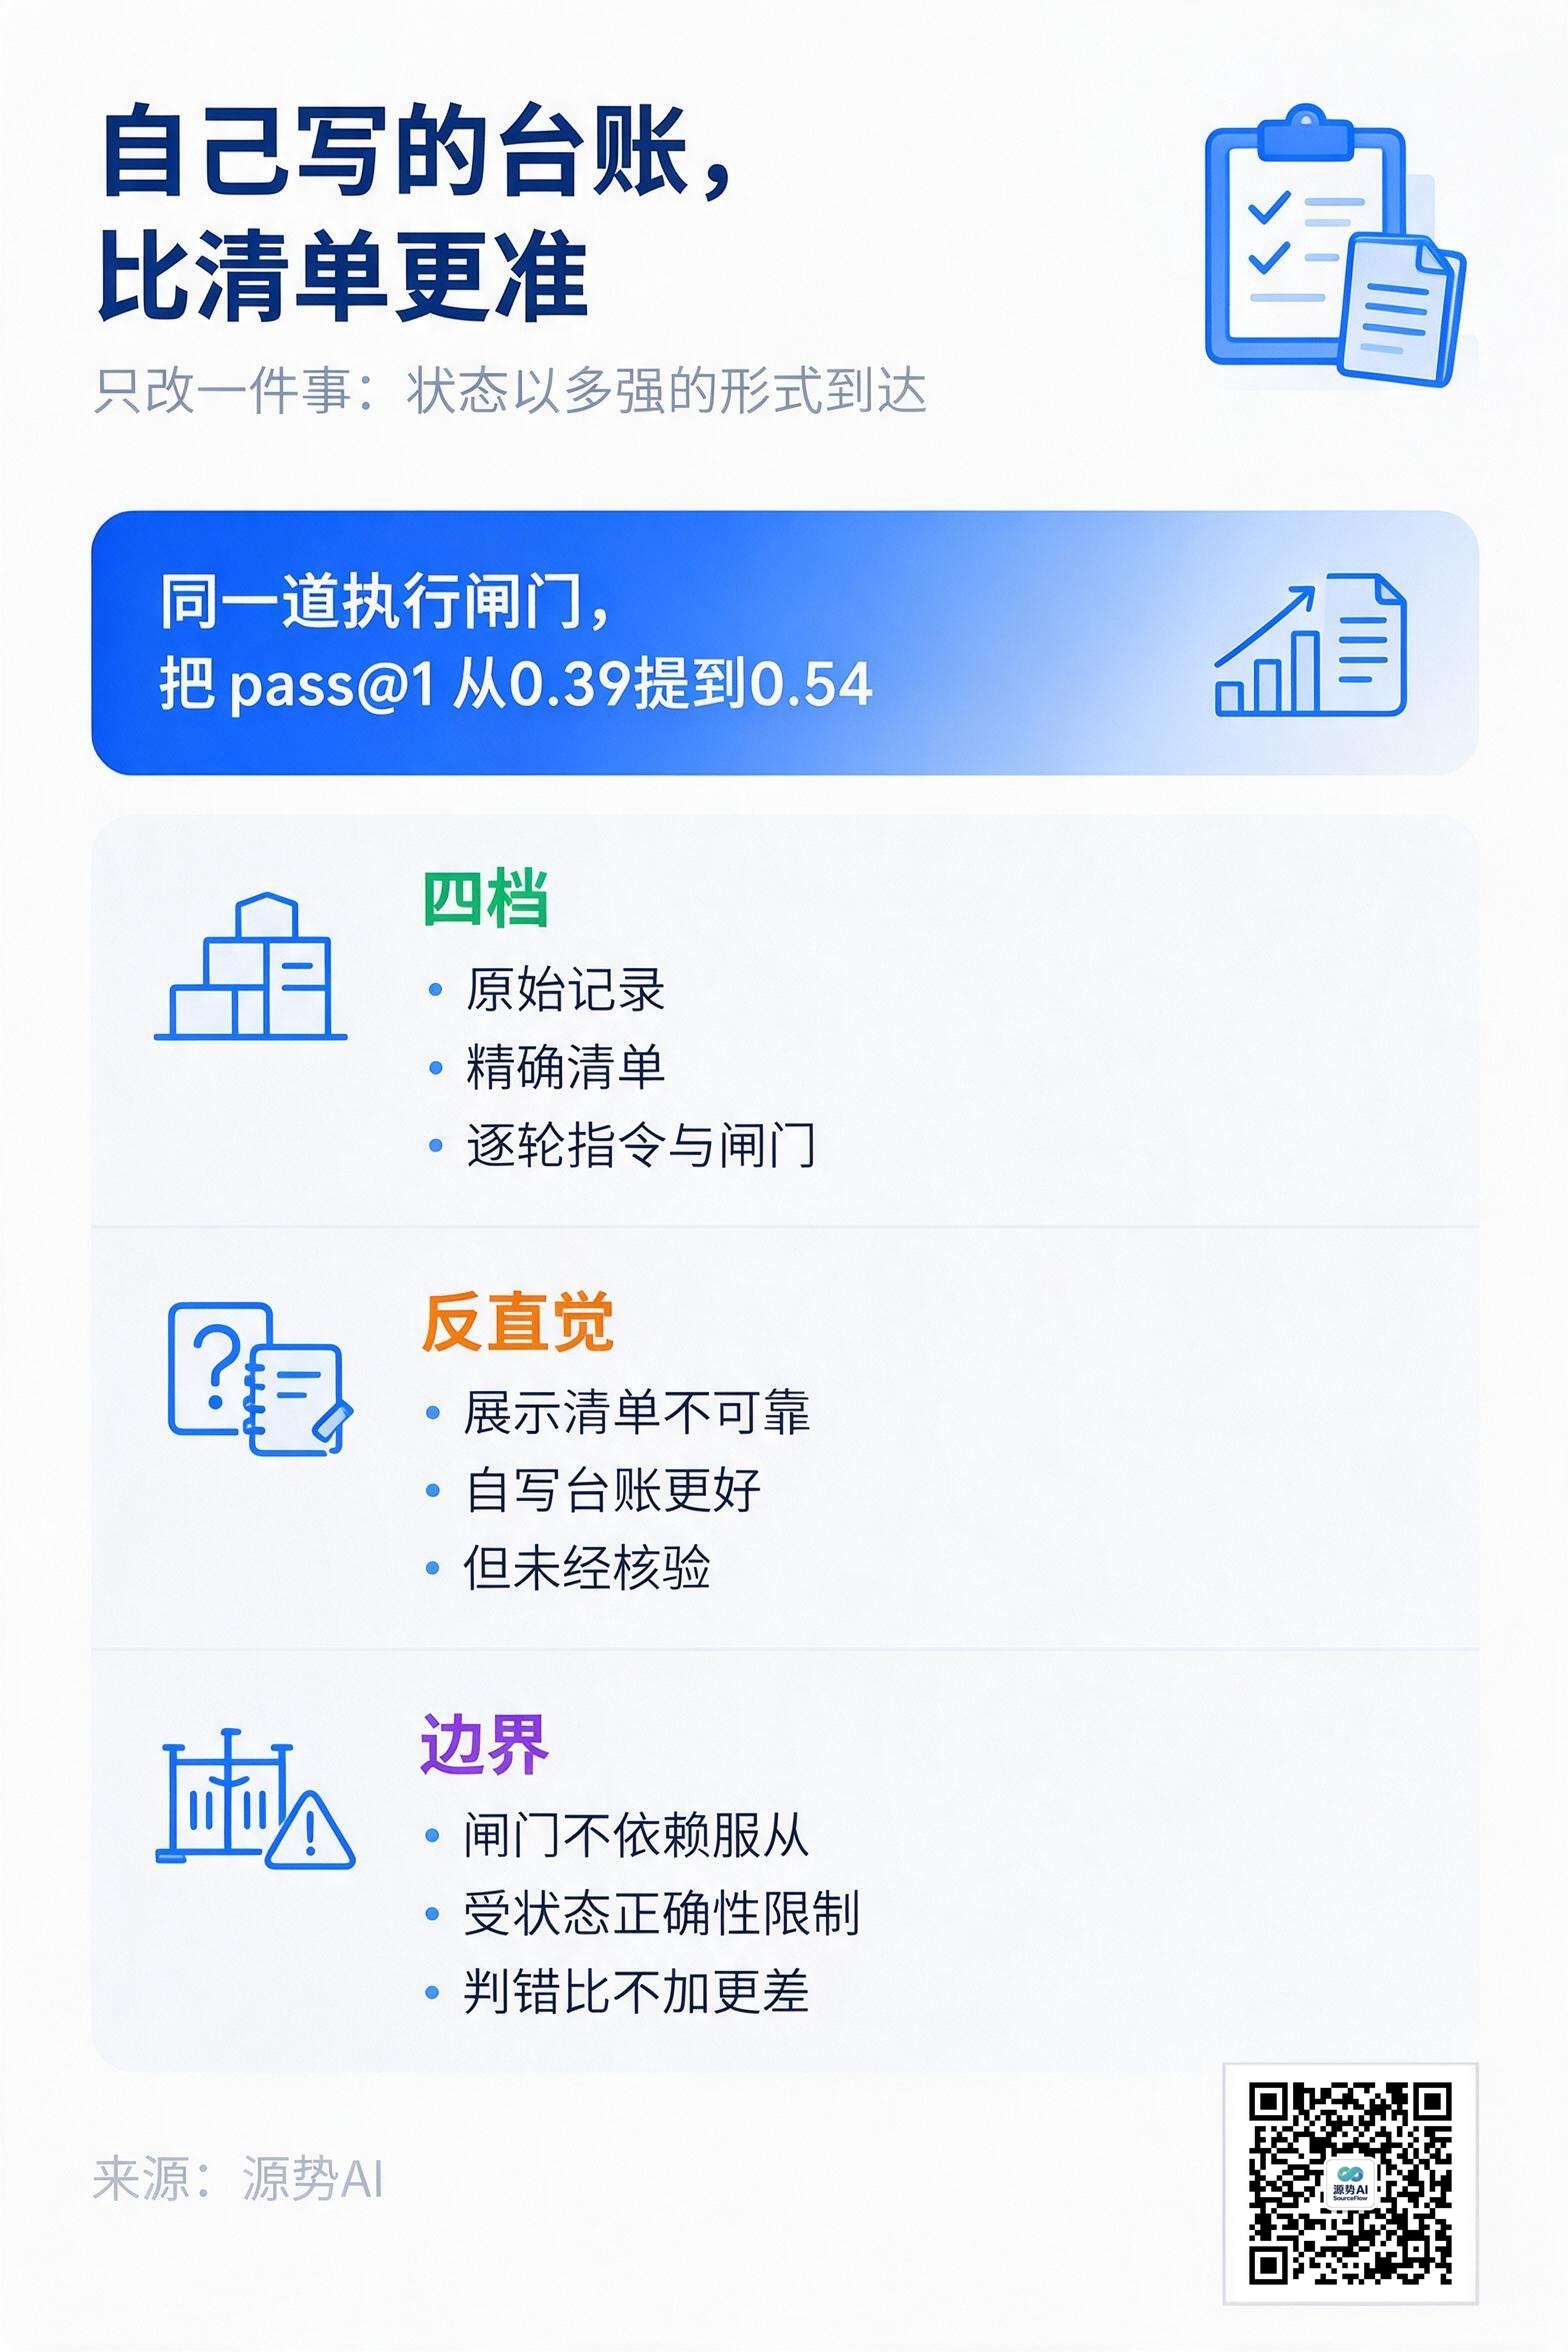
一篇 9 月 25 日上传 arXiv 的论文,把一个系统设计问题拆成了可比较的档位:任务状态该以多强的形式约束 agent(来源:arXiv:2609.25686《How Strongly Should Task State Influence an LLM Agent?》,论文速递 2026-09-25)。
作者来自滑铁卢大学、成均馆大学与伊利诺伊大学厄巴纳-香槟分校。实验设计很干净:固定任务规则、模型与配对场景,只改变任务状态抵达 agent 的方式,并按精确载荷匹配评分(来源:同上)。
所谓精确载荷匹配,是指评分只看 agent 的动作有没有带上真实状态里的具体字段——订单号、日期、金额、舱位等级这类,不看它把话说得多顺。措辞像对不算对,字段错了就是错。
四种方式分别是:原始记录、精确清单、由状态机产生的逐轮指令、以及拒绝违规动作的执行闸门。
结论在三个模型、两个领域上一致:仅仅展示准确的状态并不可靠(来源:同上)。
台账赢过清单
最反直觉的一条是:agent 自己写的、未经核验的台账,反而胜过被展示给它的清单(来源:arXiv:2609.25686)。
也就是说,把状态整理得漂漂亮亮贴给它看,效果不如让它自己边做边记。前者的风险是清单成了一份静态文档,agent 照着读,读错了没人发现;后者至少让状态跟着任务推进走,一旦中途出现新事实,记录会同步更新。
这个结果和企业里已经形成的经验吻合。源势AI 此前梳理过,企业 Agent 的分水岭已经从 Prompt 挪到了 Loop——真正决定表现的是一次次循环里状态怎么被维护,而不是开场那段提示词写得多好(来源:《企业 Agent 的分水岭,已经从 Prompt 进入 Loop》,笔记同步助手,2026-08-24)。
另一篇同期论文从反面印证了同一件事:agent 真正的病是任务状态污染,未被支持的假设和过期计划留在对话历史里,会持续扭曲后续决策(来源:arXiv:2609.28416《Agent-Editing World Model》,论文速递 2026-09-25)。
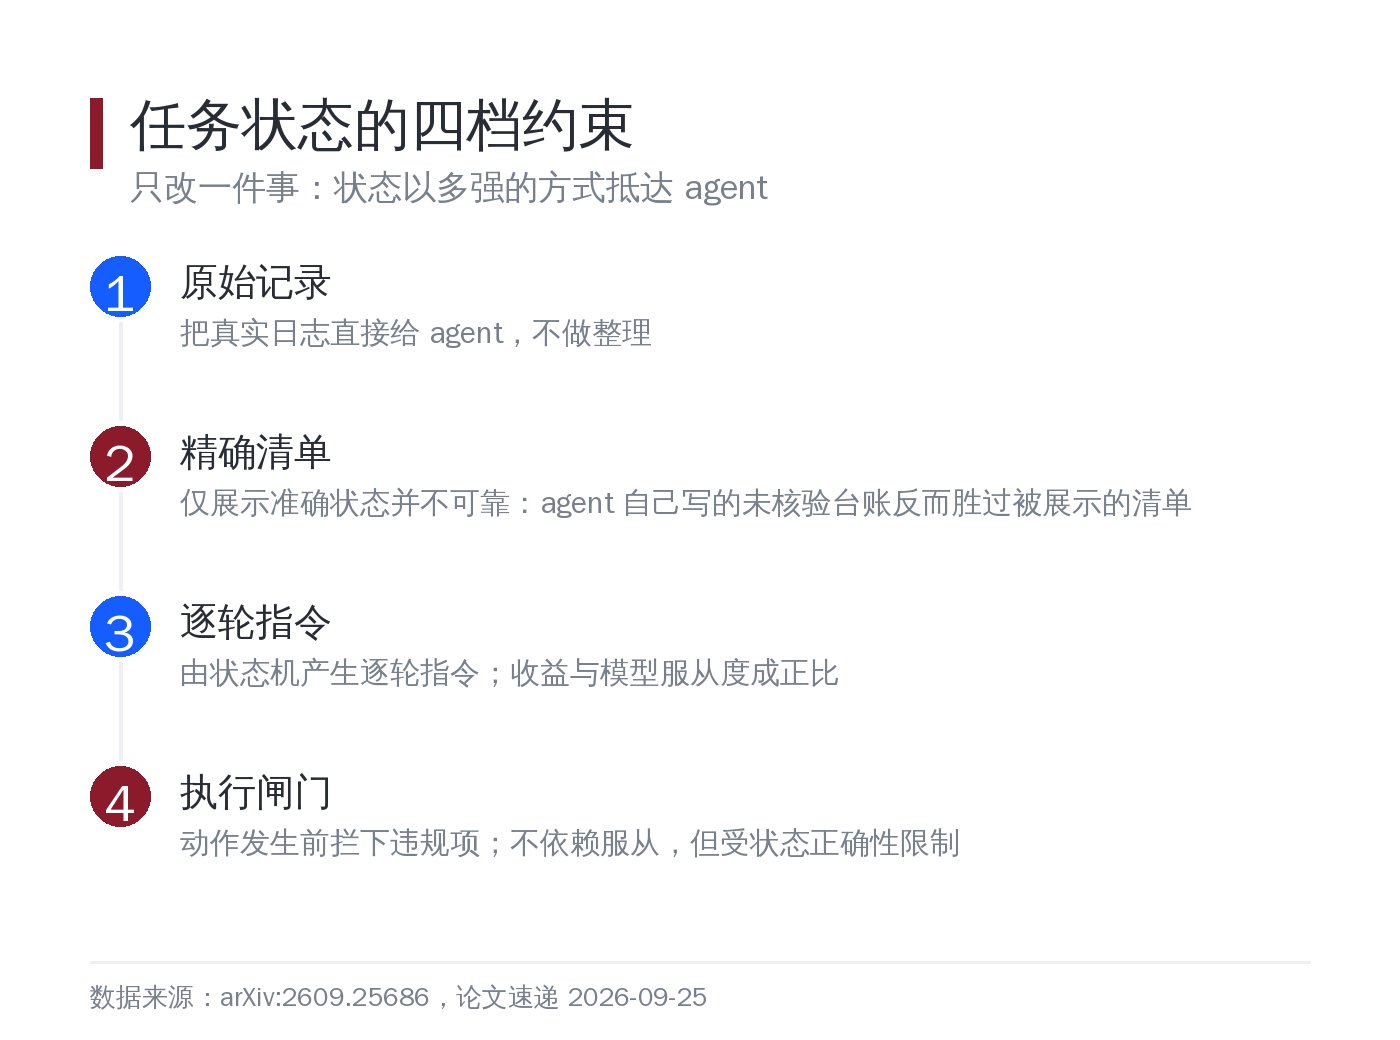
图注:四档依次加码,但前三档的收益都挂在模型服从度上,只有闸门不依赖它
闸门把 0.39 提到 0.54
第四档的收益是四档里最硬的。同一道执行闸门,把 τ²-bench 航空政策场景下 235B agent 的 pass@1 从 0.39 提到 0.54(来源:arXiv:2609.25686)。
τ²-bench 是一套带政策约束的对话式任务基准,航空政策只是其中一类场景,题目会要求 agent 在多轮对话里守住退款、改签、舱位这些规则。0.39 到 0.54 是同一模型、同一批场景下的对照结果,不是跨模型比较。
逐轮指令和闸门的差别在依赖关系上。逐轮指令的收益与模型服从度成正比——模型愿意听,指令才起作用;执行闸门不依赖服从,因为它不由模型决定是否执行,而是由外部在动作发生前拦下违规项(来源:同上)。
对工程团队来说,这个区别意味着选择依据不同:如果追求稳定,选闸门;如果追求灵活,选指令,但要接受收益随模型表现波动。同一份研究没有给出闸门在生产规模下的故障率,这一点部署前要自己压测。
状态污染那条线也有可量化的对应。AEWM 的做法是不去预测工具返回什么(高熵且依赖真实执行,重建价值有限),改为建模「推理与动作如何改变任务进展」:Action Judge 区分关键、探索与噪声决策,State Revision 编辑同一段历史里被污染的推理-动作片段。在三域训练后,Action Judge 基准的 macro-F1 达 70.5%,超出最强前沿基线 10.6 分(来源:arXiv:2609.28416)。
图注:State Revision 要做的事是改同一段历史里被污染的推理-动作片段,而不是重写整份对话
闸门判错时,比不加还差
论文给出了一条边界:执行闸门受状态正确性的限制。闸门本身不判断对错,它执行的是状态里的规则——如果状态写错了,闸门会稳定地拦下正确的动作(来源:arXiv:2609.25686)。
这和企业里上线过审批流的人踩过的坑是同一个:强制的门禁把错误也一起强制了。收益来自状态正确,不是来自闸门本身。
所以论文的落点不是「加个闸门就安全了」,而是把「加个状态模块」这类模糊的系统决策,拆成有对照、有效果差、有适用条件的几档(来源:同上)。这比一句「要多加约束」有用得多。
前端校验的研究也朝同一个方向走:智能体动手前先做确定性校验,把判断放在动作发生之前,而不是事后归因(来源:arXiv:2609.11957《智能体动手前的确定性校验》,论文速递 2026-09-23)。
需要留一句边界:这套结论来自受控实验,规模是三个模型、两个领域,评的是带明确规则的任务。开放式任务、多 agent 交叉写入状态的场景不在覆盖范围内,直接外推到全部生产环境并不稳妥。
源势AI观点
下面三条里,前两条有论文数据支撑,第三条的对照机制是源势AI 按工程实践补的做法。
第一,状态模块要按档位选,不要按感觉选。先问两个问题:这个场景能不能接受模型不服从(不能就用闸门),状态本身有没有可靠的写入方(没有就先修状态源,闸门会放大错误)。
第二,让 agent 自己维护台账,但要加一本外部对照账。论文验证了自写台账的有效性,同时也说明它未经核验。做法是让 agent 记账,同时用工具回执或数据库状态做一次外部比对,两者不一致时把控制权交回人类。
第三,把「状态正确率」当成一线指标。状态错了,闸门与指令都会把错误执行得更彻底。监控里加一项:关键字段与外部系统的比对一致率,比看任务成功率更早发现问题。
参考材料
- arXiv:2609.25686《How Strongly Should Task State Influence an LLM Agent?》(滑铁卢大学、成均馆大学、伊利诺伊大学厄巴纳-香槟分校)
- arXiv:2609.28416《Agent-Editing World Model: Rethinking World Modeling for LLM Agents》
- arXiv:2609.11957《智能体动手前的确定性校验》
- 笔记同步助手《企业 Agent 的分水岭,已经从 Prompt 进入 Loop》,2026-08-24
话题标签:#Agent工程 #任务状态 #执行闸门
