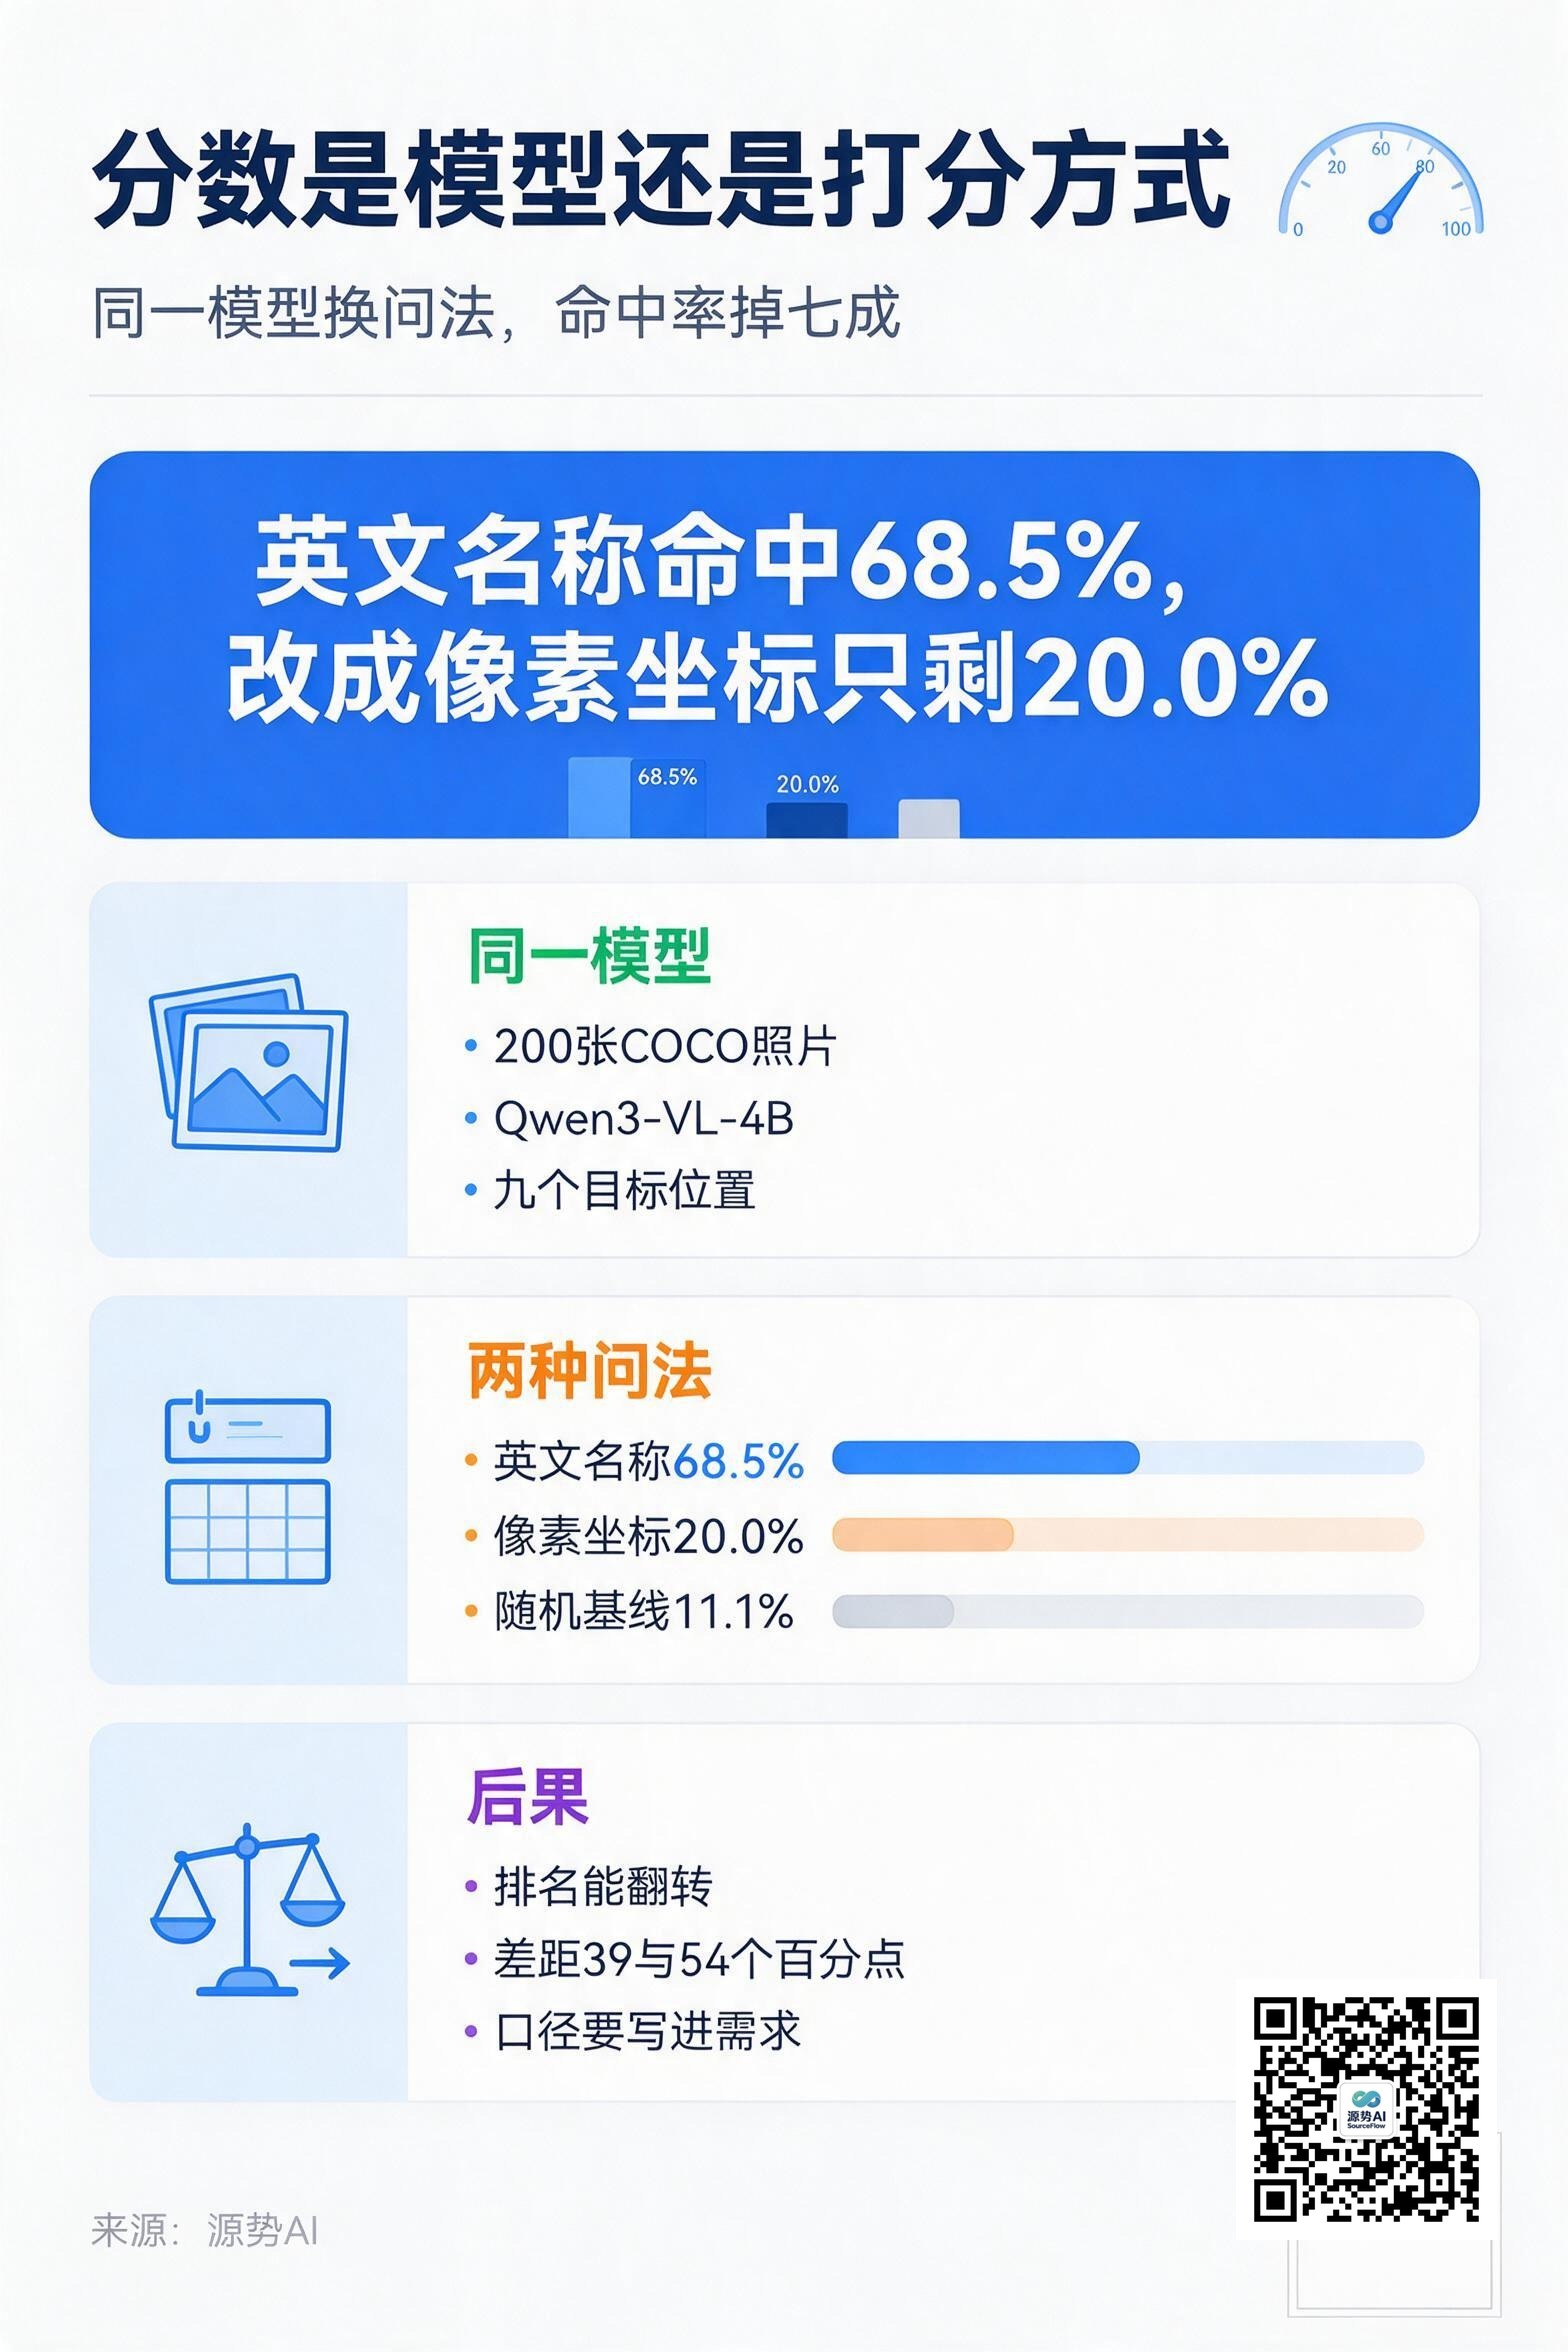
同一批 200 张照片、同一个模型,问法一换,分数掉到原来的三成。
哥伦比亚大学的一项研究把 Qwen3-VL-4B 拉到这个测试上:要求模型用英文名称指出九个目标位置时,定位命中率 68.5%;把同样九个位置改写成像素坐标,命中率只剩 20.0%,而随机基线是 11.1%(来源:arXiv:2609.27408)。
两者之差不是噪声。它在 4×4 网格、8bit 量化以及各种目标尺寸切片里稳定存在——也就是说,基准报出的"能力上限",有一块属于读出方式,不属于模型(来源:同上)。
研究逐项排除了替代解释:换成 4×4 的目标网格、加 8bit 量化、把图像切成不同尺寸,差距都在;它来自答案的表示方式,而不是图像预处理或数值精度(来源:arXiv:2609.27408)。按 68.5% 与 20.0% 相差 48.5 个百分点算,这块差距以前全被算进了模型的账上。
换一个坐标系,排名能翻个方向
真正影响选型的是下一步:这个差距直接改写排名。两个在英文名称下打平的模型,在不同坐标系下相差 39 与 54 个百分点,而且方向相反——A 在这种问法下更强,B 在另一种问法下更强(来源:arXiv:2609.27408)。
颜色任务上也有同类惩罚:Gemini 在颜色命名上要付 11.1 个百分点(p=1e-4),GPT-4o 没有这个损失(来源:同上)。同一类任务,答案约定不同,代价就不一样。
麻烦的是这类差距不易被发现:评测跑完只给一个总分,很少有人会去检查"把名字换成坐标会怎样"。选型团队能拿到手的,通常只有那张榜。
图注:把位置说成名字还是说成坐标,决定的是分数归属,不是模型能力
压成一个数字,会抹掉行为差异
口径问题不止在读出方式。NAVER Cloud AI 与韩国科学技术院做的 PRISM-VLM,把每条样本沿七条轴打分(任务质量、行为鲁棒性、能力瓶颈等),再用调和平均合成一个 PScore。在近两年的紧凑 VLM 上,它比单轴基准更可靠地区分模型对,同时暴露出被平均值抹平的行为差异:PScore 上统计难分高下的两个模型,在谄媚性这类单轴剖面上差异极大(来源:arXiv:2609.27395)。
选型结论往往取决于你压成一个数还是看七条轴。压成一个数看起来更干净,代价是把部署风险一起压没了。
PRISM-VLM 的样本取自 15 个公开基准,用逐样本配对自助检验来判断两个模型的差异是否统计显著。这个方法的价值,是让"打平"和"有差距"两个结论各自都有依据,而不是靠一条平均分的先后顺序(来源:arXiv:2609.27395)。
榜单上的分差,要带误差意识看
这不是孤例。同一时期的一组实验给出了更直观的数字:同一个模型、同一批代码任务,只改模型外面那层"外壳"的配置——工具怎么给、上下文怎么组织、失败怎么重试——完成的题目数从 43 涨到 72,平均修复率从 28% 提到 49%(来源:《AI·排行榜,可能骗了你》,源势AI,2026-08-31)。
换句话说,排行榜第一,可能只是壳配得好。企业买的是壳加模型的组合,而榜单测的也只是一次组合,两者未必对应。
另一篇给出的对应做法是换考题:Agent 类评测如果只看最终答案对不对,会漏掉它怎么走到答案、路上有没有作弊(来源:《Agent的考卷,得换一套》,源势AI,2026-08-24)。
两条合起来是一个读榜姿势:先看这个分数是怎么被读出来的,再看分差够不够大。对企业采购而言,可比性也在这里——两份评测报告口径不同,逐行对比没有意义;把口径写进需求文档,两家的报价才能放在同一张表上。
这也解释了同一个模型为什么会在不同评测里"忽强忽弱":多数时候不是模型变了,而是评测把它的强项和弱项放进了不同的权重里。
更实际的影响在验收环节。企业自己做测试时,如果题面形态和真实业务差得远,测出来的强弱关系迁移不过去——业务里进来的输入是表格、截图还是长文档,要的答案是分类、坐标还是自由文本,每一项都会改变结论。做法不复杂:把业务里真实出现过的二三十条样本抽出来做成一套自己的小评测,跑一遍比看十张榜有用。
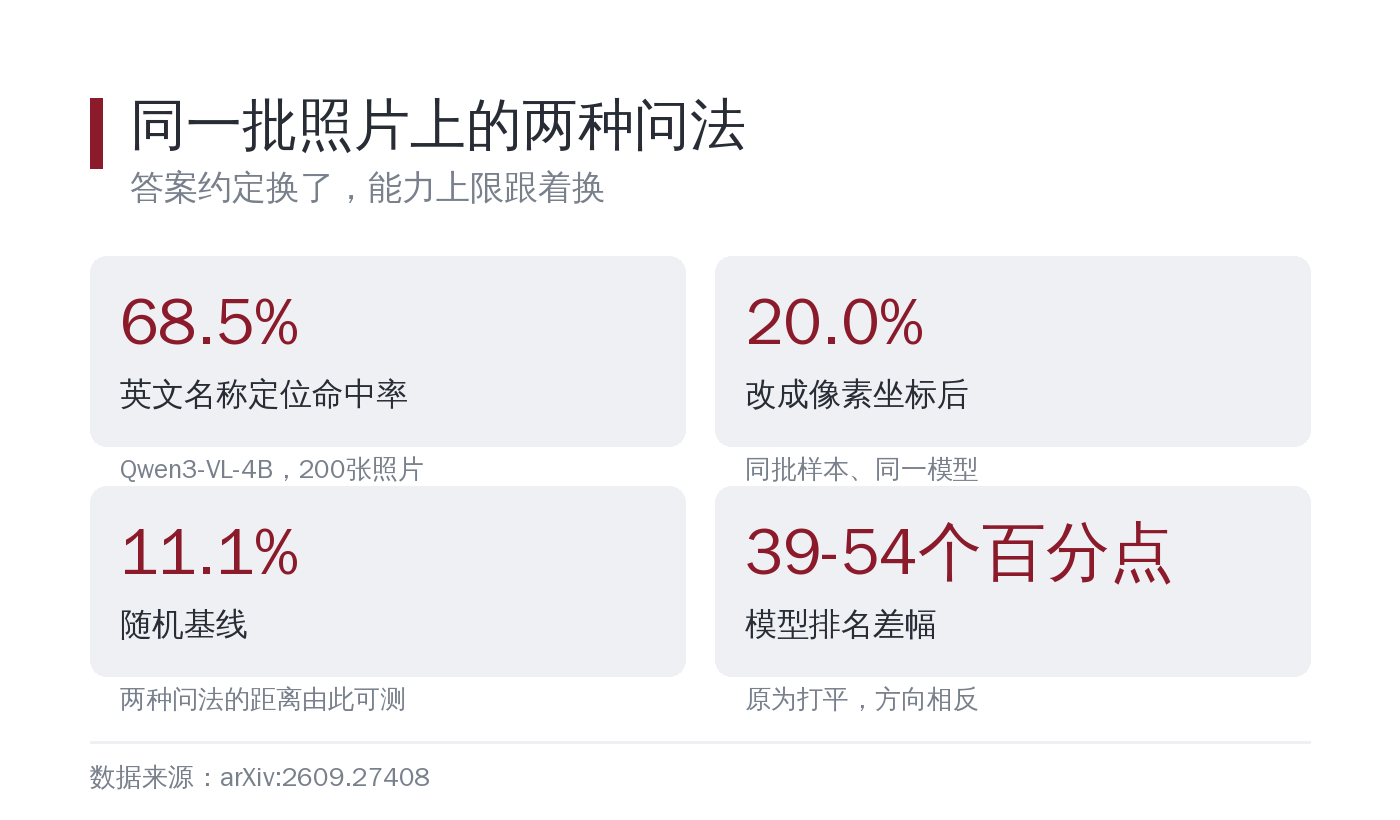
图注:11.1% 的随机基线摆在那里——20.0% 和 68.5% 之间的距离,一半是模型,一半是打分方式
源势AI观点
第一,选型时把评测脚本一起要过来。同一批样本,问法、答案格式、判分器三样东西任意一样变了,结论都可能翻转;采购对比表里加一列"评测口径",比多跑两个榜单有用。
第二,给结论留误差带。榜单差 2 分以内的模型按同一档处理,把资源投到能拿自己真实业务样本跑的那套评测上。
第三,行为轴比总分更接近部署风险。谄媚性、拒答率、越权倾向这类单轴剖面,才是上线后出事的来源;向厂商要分轴数据,不要只要一个总分。榜单可以看,但要把它当成一条线索,而不是结论。
参考材料
- arXiv:2609.27408《What Looks Like a Capability Limit in Vision-Language Models Is a Readout Limit》
- arXiv:2609.27395《PRISM-VLM: A Multi-Axis Discriminative Benchmark for Compact Vision-Language Models》
- 源势AI《AI·排行榜,可能骗了你》,2026-08-31
- 源势AI《Agent的考卷,得换一套》,2026-08-24
话题标签:#模型评测 #基准测试 #选型口径
