9 月 25 日,苹果在 Jamf 用户大会(JNUC)的"IT 行业最新动态"环节公布了一张端侧 AI 推理能力对比图,第一次把旗下产品线能本地跑多大的模型完整摊开(来源:IT之家,2026-09-25)。
苹果给的口径是"可承载的最大激活参数"。这个说法很讲究:它不承诺速度,只承诺装得下。而装得下的门槛不是别的,是统一内存的容量和带宽。
一张表把天花板摊开
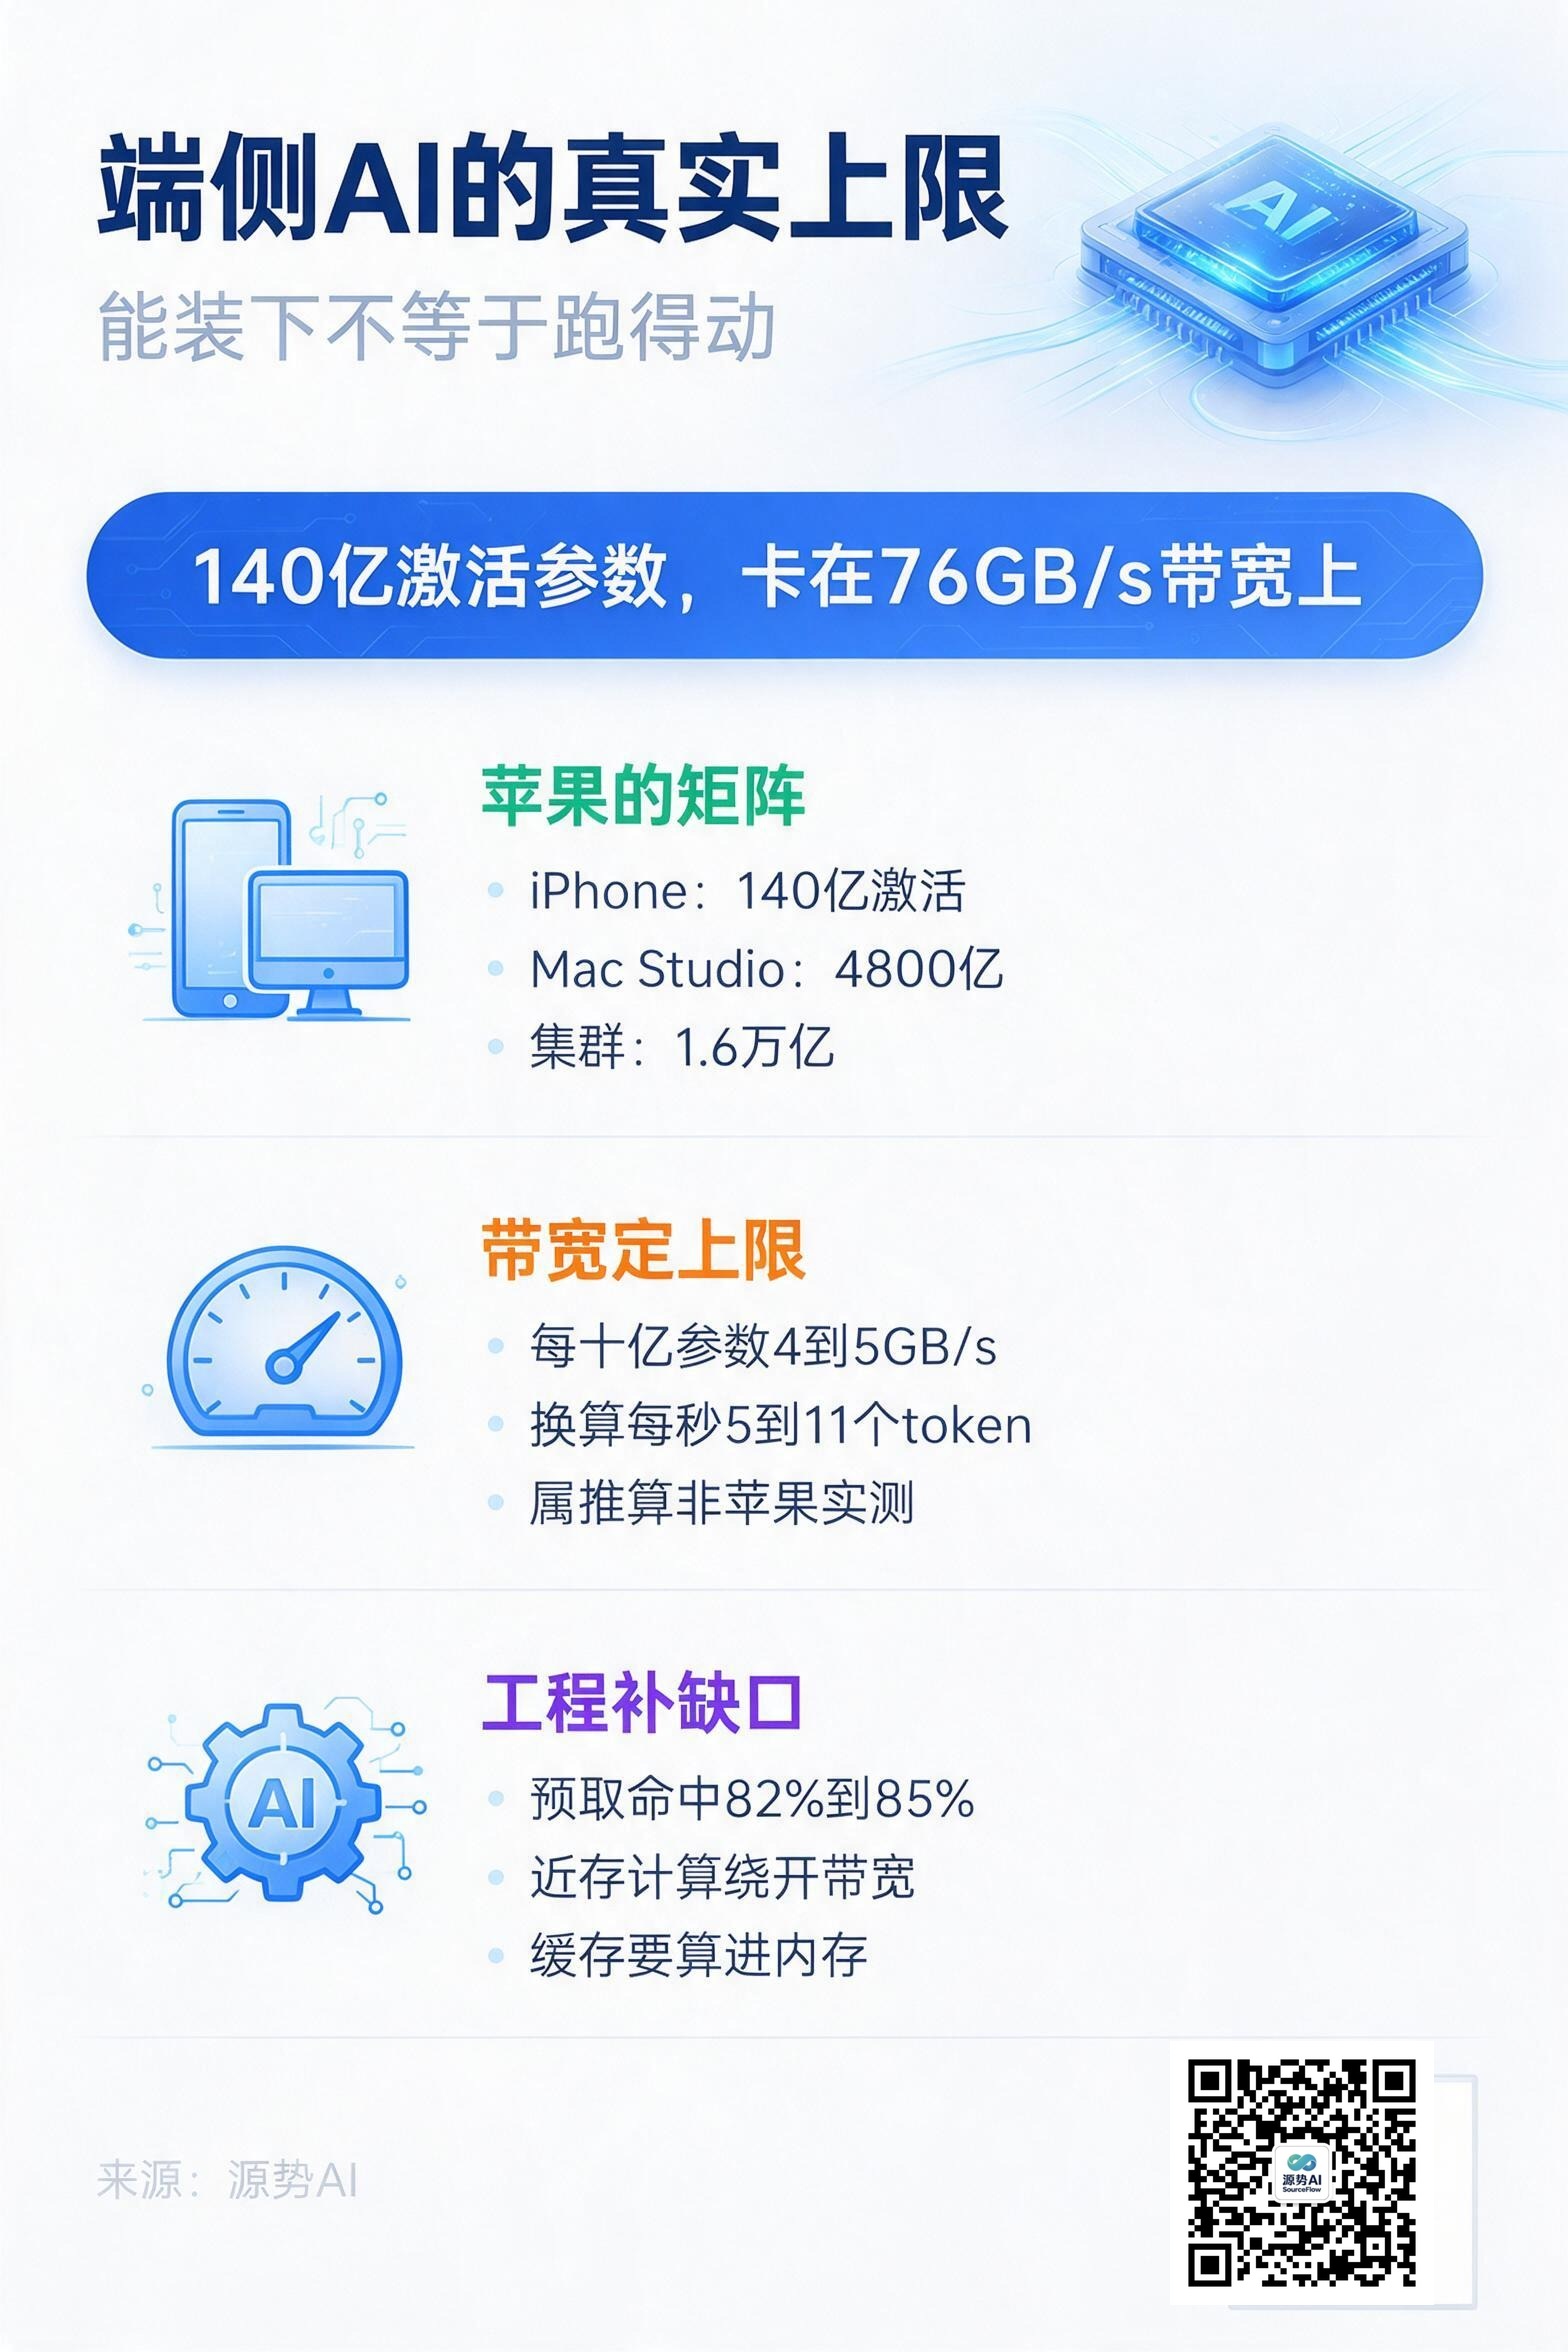
按官方图表,iPhone 与 iPad 是 16GB 统一内存、76GB/s 带宽,最高承载 140 亿激活参数,对应 Siri、文字润色、图片处理这类日常任务;MacBook Air 32GB / 153GB/s 对应 350 亿;Mac mini 64GB / 307GB/s 对应 700 亿;MacBook Pro 128GB / 614GB/s 对应 1200 亿;Mac Studio 512GB / 1.2TB/s 对应 4800 亿;Mac Studio 集群 2TB 内存,对应 1.6 万亿(来源:IT之家,2026-09-25)。
把每一行的带宽除以激活参数,会得到一个大致恒定的比值:每十亿激活参数对应 4 到 5GB/s 的带宽。也就是说,苹果这张表画出来的其实是同一根线——内存带宽与模型规模按固定比例同步放大。
这个比值还能反推出一个更实用的数字。按 4 比特权重估算,每生成一个 token 需要读一遍全部激活权重,140 亿参数约合 7GB,76GB/s 带宽对应的理论上限大约是每秒 11 个 token;表格里其他几行的推算值落在每秒 5 到 10 个 token 之间(此为按公开带宽与参数量做的估算,非苹果实测口径)。
这就是"能装下"和"好用"之间的距离。个位数到十位数的出字速度,写邮件够用,做实时对话和多步推理就不够。
上限不是跑得动
图表公布前后,还有一组实测数据流传得很广:iPhone 18 Pro 能在本地运行 270 亿参数的模型,速度比上一代翻倍(来源:IT之家)。
270 亿大于 140 亿,两句话放一起看像矛盾,其实不是。苹果图表写的是"激活参数",而 270 亿指的是模型总参数。如果那个模型是 MoE 架构,每次推理只点亮其中一部分专家,激活量完全可以落在 140 亿之内——两个数字说的是两件事,一个管"装得下多少",一个管"一次点亮多少"。
图注:粗细不同的两条光带对应同一套架构的两种带宽——参数能装下多少,取决于这条通道有多宽
真正会掉速的是另一类情况。同一批实测里提到,换成 2 比特量化的更大模型时,因为内存不足,速度明显下降(来源:同上)。量化能压住权重体积,压不住 KV cache:上下文越长,缓存越大。源势AI 在端侧部署复盘里给过一个量级参考——不到 30 亿参数的模型,长上下文时的缓存可以超过权重本身,按 4GB 这个量级预留比按参数量估算更接近实际(来源:《12G内存,AI先吃掉7G》,源势AI,2026-09-23)。
带宽不够时,工程顶上来
学术侧这两年在做的事,恰好都在补带宽的缺口。
首尔大学与 UC Berkeley 的 mzCache 研究的是多任务切换下的端侧内存管理:手机用户不会只开一个应用,权重和缓存被反复驱逐重建,体验断崖往往出现在这里(来源:arXiv:2609.01338,MobiCom '26)。肯尼索州立大学与三星半导体的 NeuroPrefetcher 走了另一个方向——他们发现解码时相邻 token 之间约有 82% 到 85% 的活跃神经元是重复的,于是用占参数 2.86% 的驻留预测器提前把权重从存储读进来,在受限内存预算下比 llama.cpp 快 7.9 到 12 倍(来源:arXiv:2608.22643)。
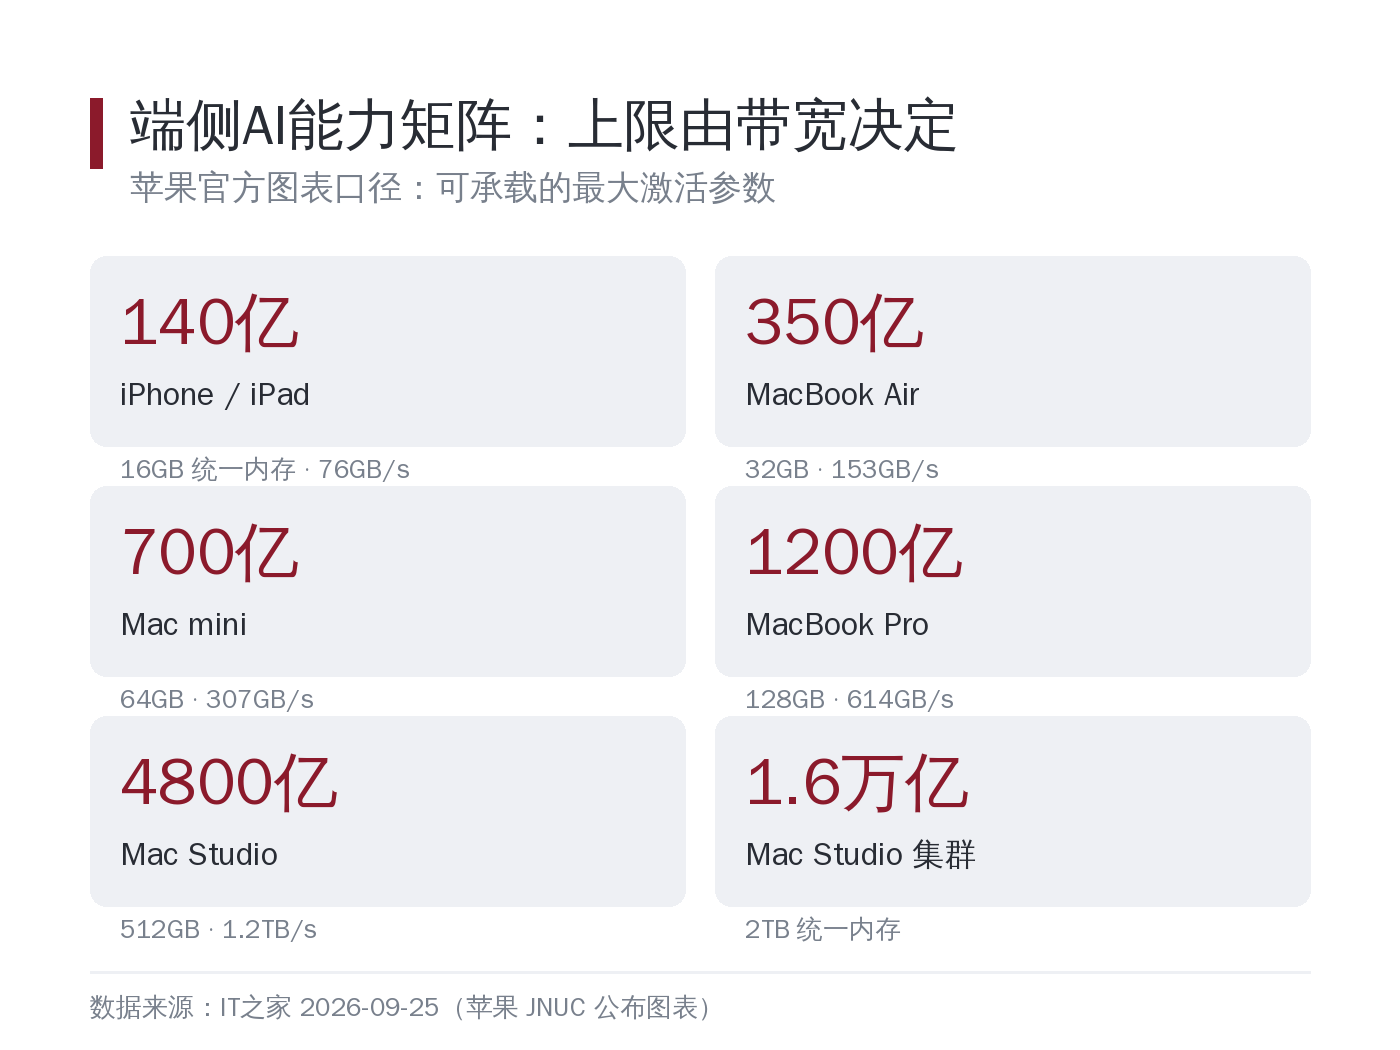
图注:把苹果图表里每行的带宽除以激活参数,六行数据落回同一根线上——端侧的上限是带宽的函数,不是内存容量的函数
还有一条更激进的路线是把推理搬进闪存做近存计算,绕开内存带宽这道墙(来源:arXiv:2609.16161)。这些工作指向同一个判断:端侧模型的规模竞赛已经接近硬件边界,接下来比的是谁能把内存用得更省。
源势AI观点
第一,看端侧方案先看带宽这一列。现在的硬件选型表普遍只列内存容量和算力 TOPS,带宽经常缺席,但它才是决定模型能跑多大的那一项。给客户做端侧评估时,我们第一步就是把 GB/s 和激活参数量放在一起算,而不是只看"支持多少亿参数"这个宣传口径。
第二,把"上下文还在不在"当成一项产品指标来测。方法很土但有效:跑一轮长对话,切出去打开相机和游戏,再切回来,量首个 token 的延迟。这个数字比平均响应时间更能说明真实体验,也直接决定用户会不会第二次打开这个功能。
第三,内存管理层的改造优先级不低于模型优化。模型压缩的收益是渐进的,一次内存驱逐造成的体验断崖是瞬时的。安卓体系的 zRAM 与 Low-Memory Killer 都在,怎么跟它们协作,是端侧工程化的必答题。
苹果这张表最值得记的一点,是它把上限公开成了可对照的规格。规格一旦公开,采购和验收就有了依据——也就意味着,"我们支持端侧大模型"这种模糊说法,接下来在技术评审会上越来越难过关。
参考材料
- IT之家《苹果公布全产品线端侧 AI 能力矩阵》,2026-09-25
- arXiv:2609.01338《mzCache: On-Device LLM Memory Management under Multitasking》
- arXiv:2608.22643《NeuroPrefetcher: Storage-Aware Sparse LLM Inference via Delta Prefetching》
- 源势AI《12G内存,AI先吃掉7G》,2026-09-23
话题标签:#端侧AI #内存带宽 #量化推理
