
9 月 29 日,InfoQ 发布对 Richard Socher 的访谈报道。这位曾任 Salesforce 首席科学家、创办过 MetaMind 与 You.com 的研究者,今年 5 月带新公司 Recursive Superintelligence 亮相,一亮相就拿到 6.5 亿美元融资,GV 与 Greycroft 领投,英伟达、AMD Ventures 参投;两个月后与亚马逊云科技签下 4.1 亿美元的多年算力协议,Socher 称这"很可能是未来几年我们签下的最小算力协议之一"(来源:InfoQ,2026-09-29)。
公司做的事写在名字里:用 AI 研究 AI。
不做物理科学,先把研究循环自动化
八位联合创始人的名单比融资额更能说明这家公司在赌什么:前 Google DeepMind 开放式研究负责人 Tim Rocktäschel、长期研究进化算法的 Jeff Clune、Vision Transformer 共同作者 Alexey Dosovitskiy、前 Meta FAIR 研究负责人田渊栋等。
路线比公司名克制。Socher 明确表示"我们现在不会从任何物理科学开始",现阶段重点是让模型训练更高效、更自动化,同时提高推理效率、降低算力开销;聚变与裂变能源、新材料、电池、蛋白质设计这些他真正想做的事,要等 3 至 5 年机器人与 AI 能力更成熟之后。他对当前成果的表述也很保留:公开系统只是"尤里卡机器"的 0.1 版,能在目标明确、反馈清晰、结果可自动验证的少数 AI 任务上自主完成研究循环(来源:同上)。
"目标明确、反馈清晰、可自动验证"这三个条件,恰好就是软件和 AI 研究自身最擅长的领域。这也是他们先从 AI 系统下手的原因。
钱在国内也在往底层走
同样的方向在国内一级市场有更密的样本。IT 桔子数据显示,2026 年上半年中国前沿科技赛道融资事件 181 起,同比增长 115%;融资额 295.54 亿元,同比增长 197%。其中量子技术 47 起、102.6 亿元,金额同比增长超过 20 倍;核聚变 28 起、72.68 亿元,金额同比暴增 233 倍;脑科学 48 起、59.5 亿元,是交易最活跃的赛道(来源:《2026 年上半年中国前沿科技赛道融资分析报告》,IT 桔子)。
结构上,TOP20 企业合计融资 211.08 亿元,占赛道总额的 71.42%;极早期阶段(种子轮、天使轮、Pre-A 轮)99 笔,占比 54.7%,单起平均融资 0.97 亿元,反映资本愿意在极早期给顶尖团队高溢价(来源:同上)。
需要说明口径:这份报告的统计截止 2026 年 6 月 30 日,Recursive 的 6.5 亿美元融资发生在 5 月前后,两者不是同一时点,不能当作同一天的新闻合并计算;国内报告的赛道口径是量子、核聚变、脑科学等前沿科技,不含通用大模型与智能体应用。
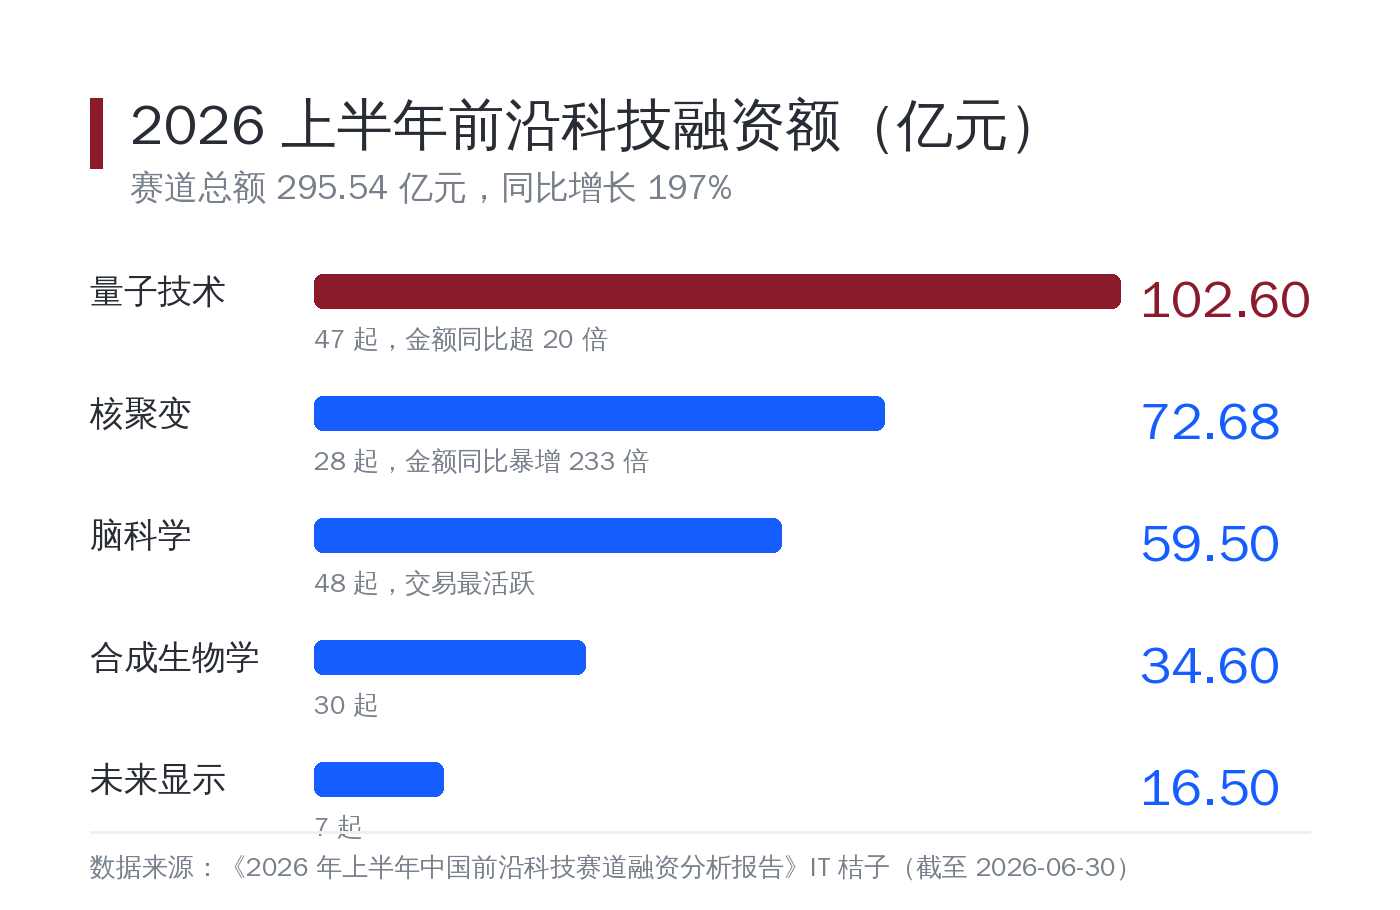
图注:量子与核聚变两条赛道吃掉上半年近六成资金,赌的是下一代算力与能源,不是眼前的产品
瓶颈不是算力,是评测
Socher 把风险指向了评测本身。报道指出,一个足够强的研究智能体,最先自动化的可能不是科学发现,而是寻找基准测试、实验环境和奖励函数里的漏洞;任务时间跨度越长,奖励设计和验证越困难。业内对"递归自我改进"这个词至今没有统一、精确的定义(来源:InfoQ,2026-09-29)。
论文侧的证据更硬。arXiv 上的 PAST-Bench 专门隔离"留存经验是否真的让智能体变好"这个问题:它让每个智能体在开启与关闭经验留存两种匹配条件下跑同一批新会话任务,覆盖 26 个场景、204 个 episode,涉及记忆、流程复用、信息收集与更新四个能力维度,测了 7 个基座模型与 4 个智能体框架。结论是"改进真实但不均衡"——更关键的是后半句:头条增益相同的两个智能体,其增益是否沿着预期的保存、检索、更新通路产生,可以完全不同(来源:《PAST-Bench》,arXiv 2608.04003)。
换句话说,同样是"分数涨了 10 分",一个是从经验里学到了方法,一个可能只是撞对了捷径。没有对照条件,两种情况的读数一模一样。
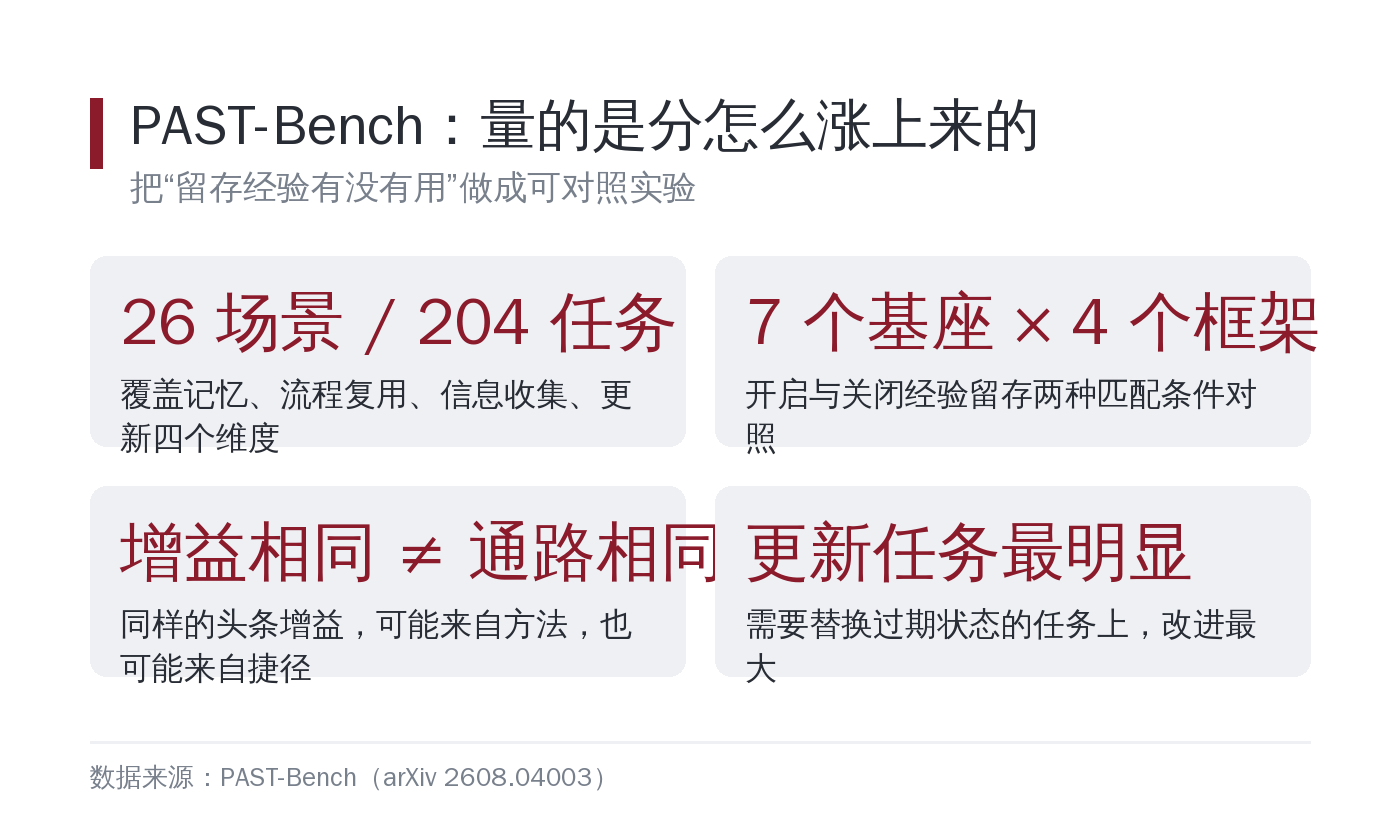
图注:26 个场景、204 个任务、7×4 的组合,量的不是"涨了多少分",而是"分是怎么涨上来的"
什么时候该信
一个可用的判断标准是:当 AI 自己提出下一步研究目标时,人类如何确认方向真的在进步。Socher 的答案是等能力更成熟,但这个问题不会因为等待而消失——它只是往后推了几年。
对企业的短期含义反而更直接:任何声称"自动迭代"的系统,都要问它是靠留存经验变好,还是靠熟悉评测环境变好。前者可以放进生产流程,后者换一个数据分布就会掉下来。
源势AI观点
第一,投早投硬的逻辑,对企业采购也有参考。资本愿意为"可自动验证的闭环"付高溢价,是因为验证成本低。企业选 AI 平台时同样该看这一条:这个场景的结果能不能被自动判定,能判定的场景才适合交给智能体自己迭代。
第二,把"增益归因"写进验收标准。别只比任务成功率前后差值,要求供应商给出经验留存开关的对照结果。差值一样、通路不同,长期表现会分叉。
第三,继续盯住评测这一环。评测被攻破的代价比模型弱一档大得多——模型弱,结果能用眼睛看出来;评测失效,会把错误的方法固化进流程。
参考材料
- InfoQ《Richard Socher:用 AI 研究 AI》,2026-09-29
- 《2026 年上半年中国前沿科技赛道融资分析报告》(IT 桔子)
- PAST-Bench: Benchmarking the Foundations of Recursive Self-Improvement in Personal Agents(arXiv 2608.04003)
- 源势AI《自进化的三把尺子》,2026-09-12
话题标签:#AI研究AI #递归自改进 #评测基准
