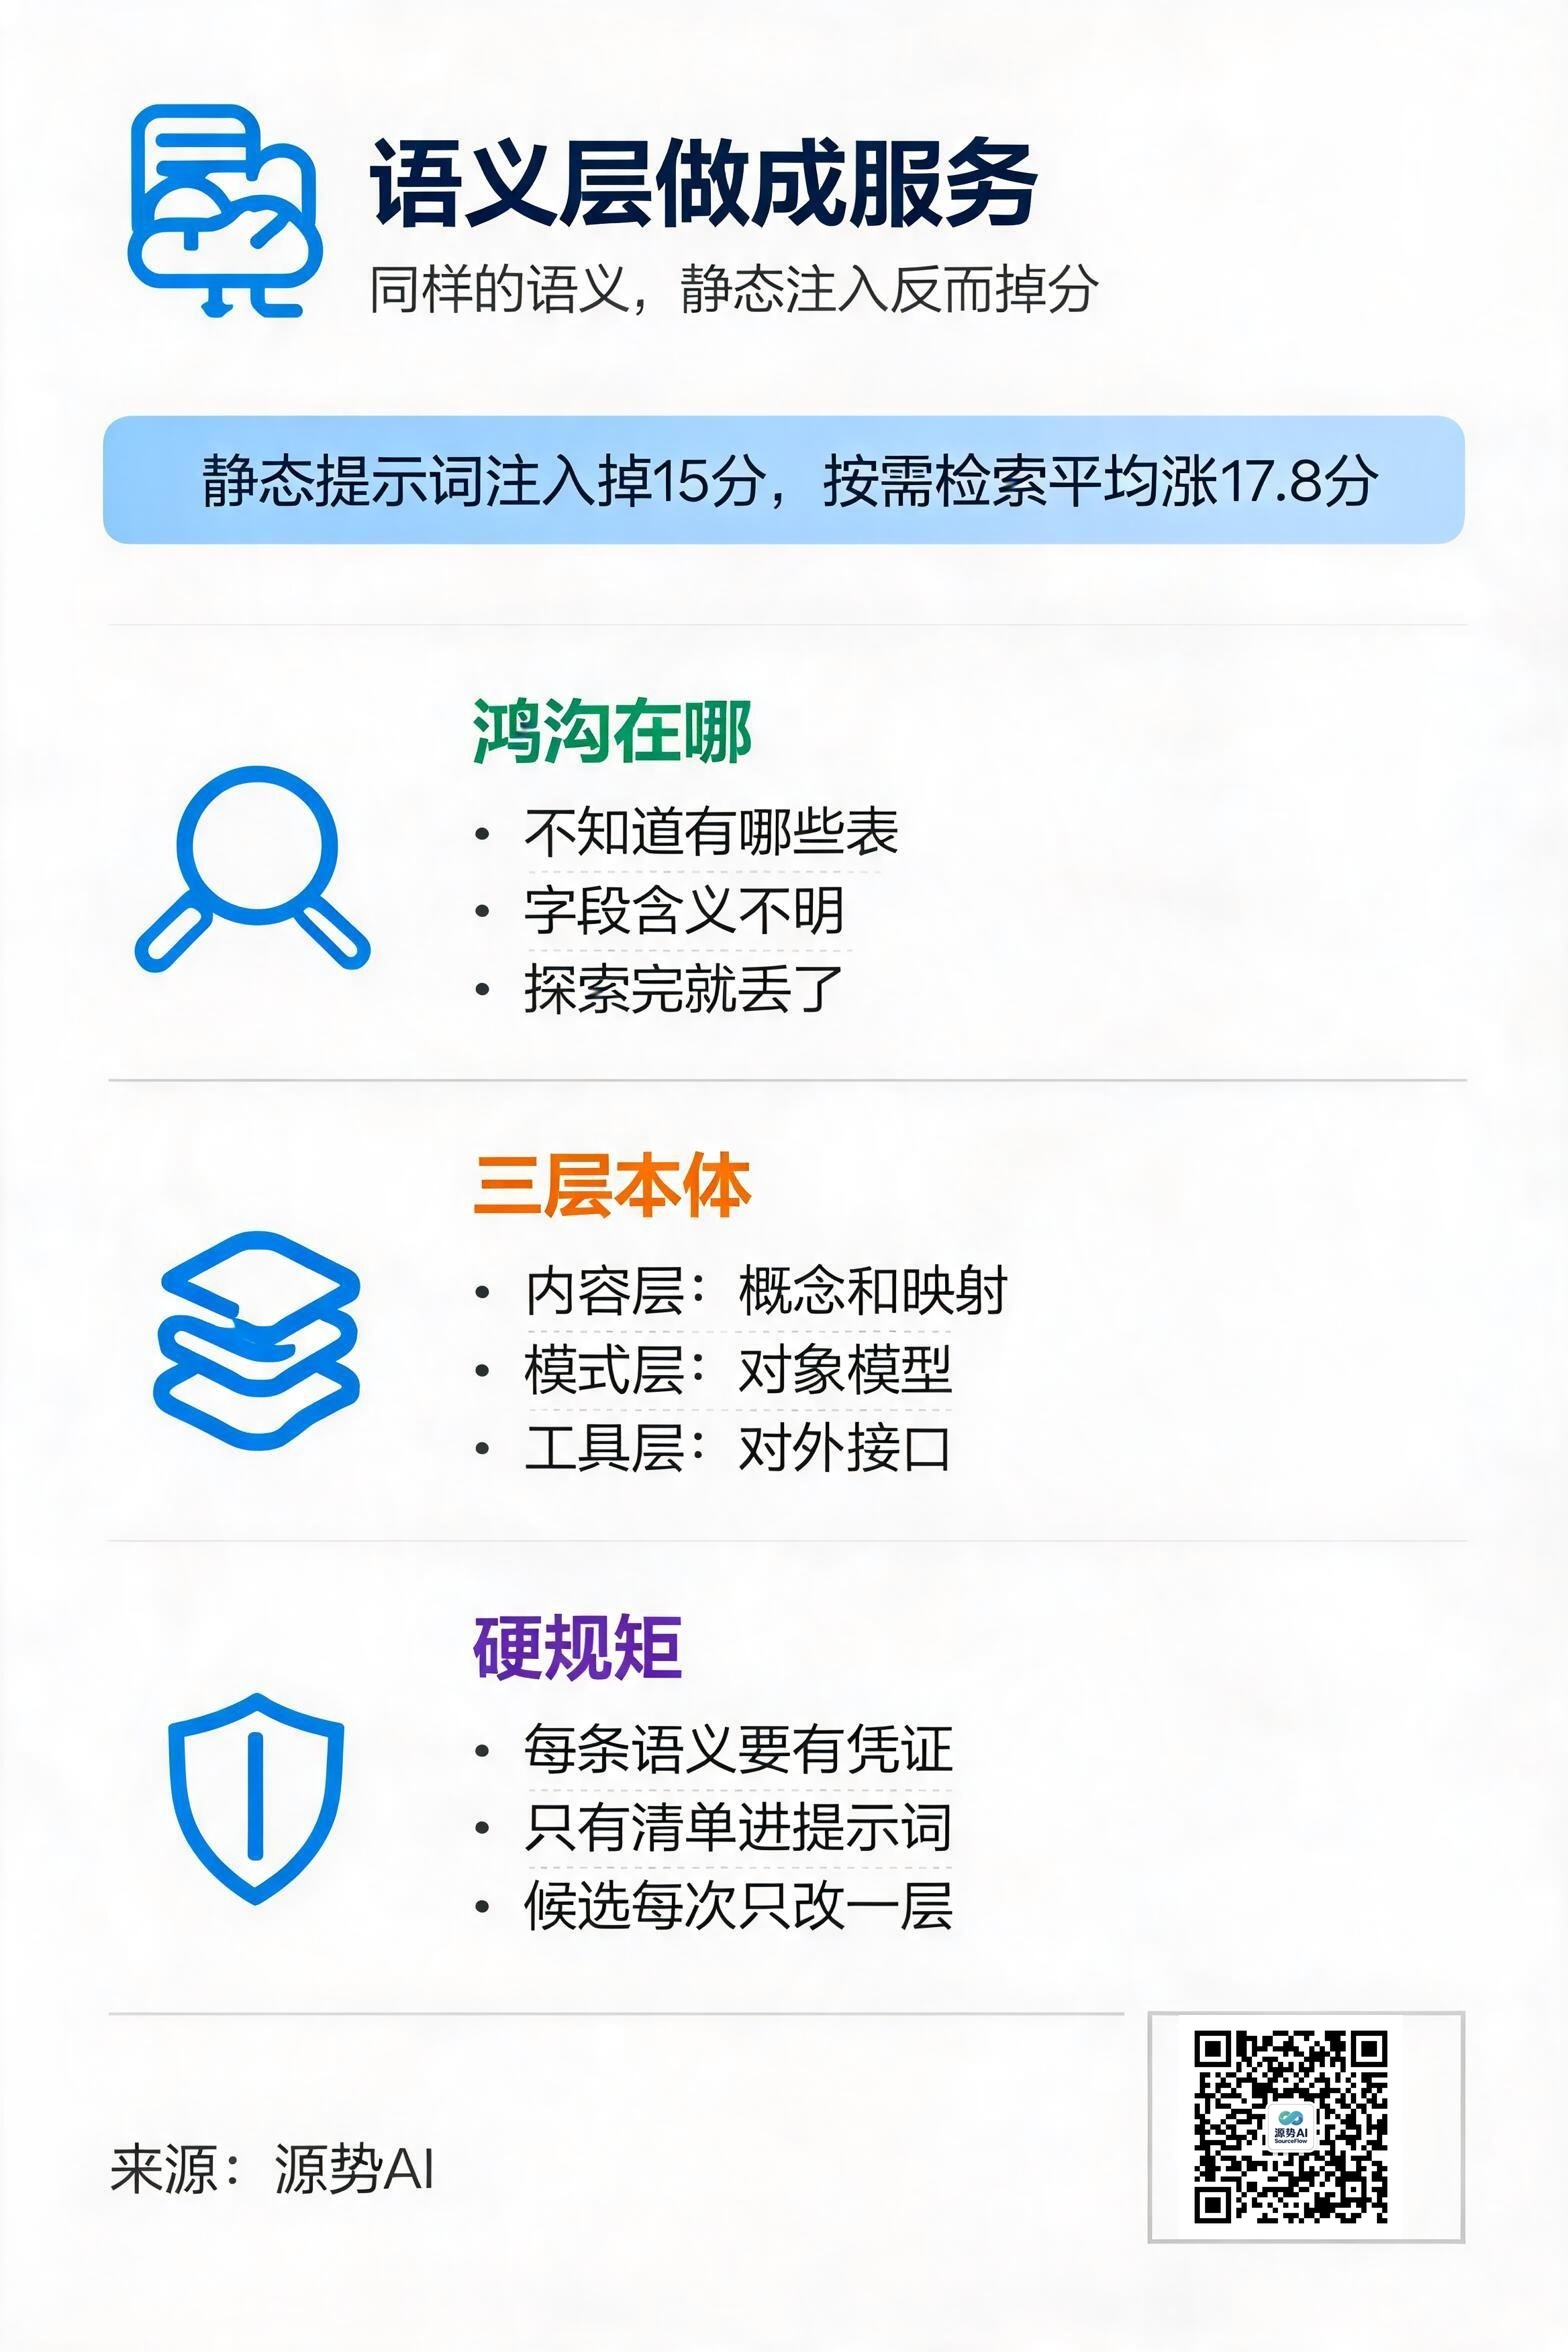
做企业数据智能体的人大多试过同一个动作:把公司的表结构、字段说明、业务口径整理成一大段文字,塞进系统提示词,然后盼着模型少绕几圈。中国人民大学的一篇新论文给了个不太舒服的结论——同一份语义内容,做成静态提示词前置,在四个骨干模型上是负收益,Claude-Sonnet-5 掉了 15 个点;改成按需检索的服务化形态,六个骨干全线涨分,长文档研究的轨迹级准确率平均提高 17.8 个点。
智能体—数据鸿沟
数据智能体要干的活,是听懂一句自然语言,然后跨结构化与非结构化数据把答案找出来:关系库、CSV、财报文件、日志、图表文档。
真实的部署场景里有个错位。数据躺在智能体外面,智能体只能通过 SQL 接口、文件读取器这些通用工具去访问它。表结构长什么样、字段名什么意思、哪些取值才算数,都不在先验知识里。于是它只能一遍遍发试探性查询,猜用户说的概念落在哪张表、哪个字段,顺手捞回一堆无关内容。
论文把这道错位命名为 agent–data gap(智能体—数据鸿沟)(来源:EvoOntology,arXiv 2609.15779)。填平它需要同时做到三件事:显式表达领域概念、把概念接地到真实数据、让智能体在语义层而不是物理层上操作数据。
这个描述对国内做集团数字化的团队并不陌生。袋鼠云的国央企白皮书把现状写得很直接:数据口径不一、指标体系分散、经营分析深度不足、AI 应用缺少高质量数据支撑,这些问题普遍存在(来源:袋鼠云《国央企集团 Data+AI 数智化转型白皮书》)。口径不统一,模型再强也只能猜。
两条老路都走不通
第一派是原始查询:给模型配好读模式、执行查询、检查文件的工具,让它自己摸。数据源小、结构简单时确实管用;数据一宽、一异构,就陷入重复且低效的探索。
第二派是语义层:提前准备好模式、实体、指标等领域语义给智能体导航。问题有三层。数据源一大,整个语义层塞不进上下文;语义层通常靠人手工维护,构造成本高,面对新数据源和新任务难适配;更根本的是,这类语义层是"静态提示词片段",跟智能体实际怎么用它是脱节的——没人知道是哪一条语义描述影响了后面哪一步决策,也就谈不上精细化维护。
论文补了一刀:一次探索里发现的接地知识,在原始查询范式里通常用完即弃,下一个任务重新摸一遍。
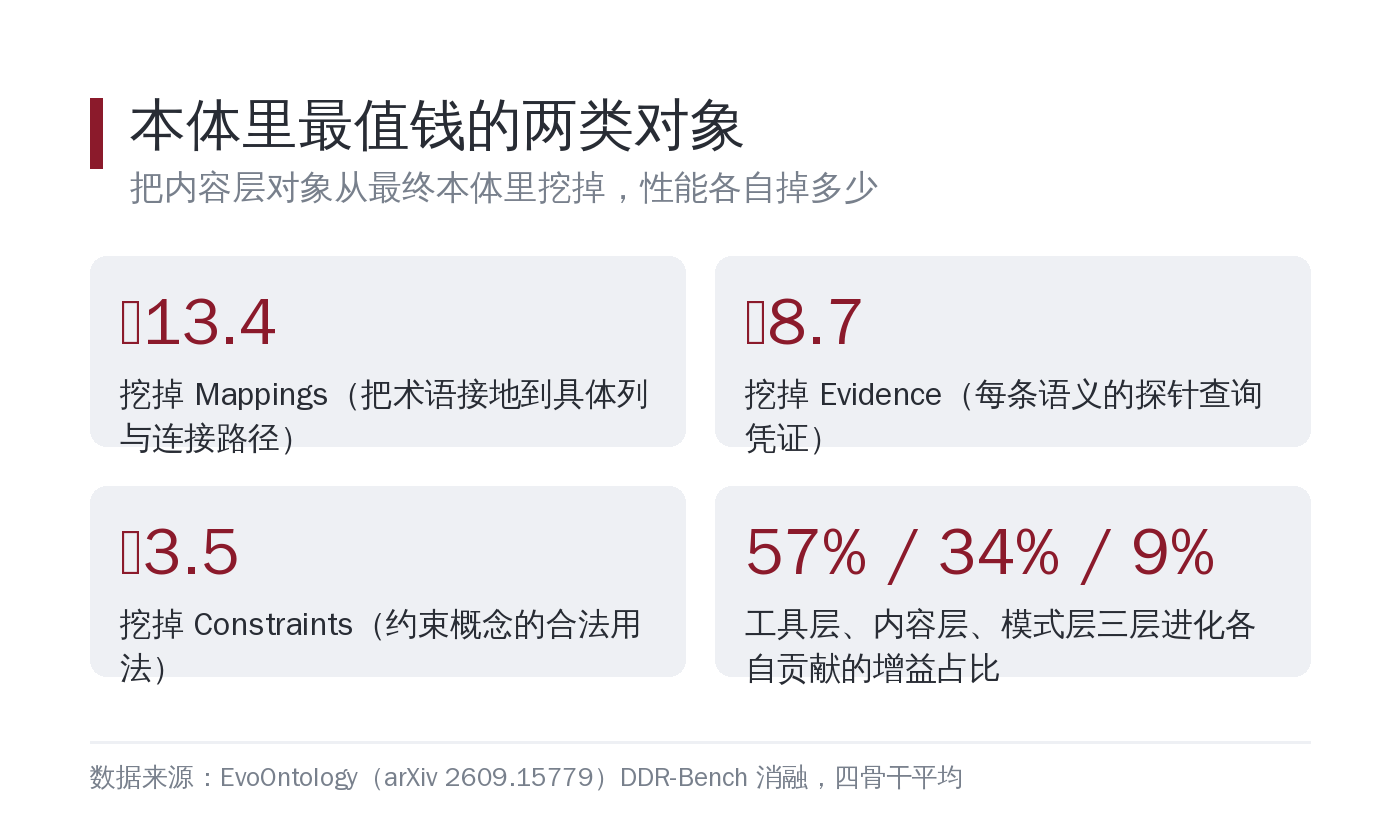
图注:内容层四类对象里,Mappings 与 Evidence 是承重墙——把它们从最终本体里挖掉,轨迹级准确率分别掉 13.4 和 8.7 个点,比删掉漂亮的术语名损失大得多。
把本体挂成 MCP 服务
EvoOntology 的做法,是把本体从一段文本改造成一个服务。本体状态记为三层:内容层是带类型的语义图,四类节点家族分别是 Terms(领域概念)、Mappings(把概念接地到字段和连接路径)、Constraints(约束概念的合法用法)、Evidence(支撑语义主张的证据);模式层定义四类节点的字段与允许的引用模式;工具层通过两个 MCP 工具加一份会话 manifest 把本体暴露出去——browse 返回相关的语义匹配,resolve 返回指定记录及其关联对象。
关键设计在这里:manifest 是唯一进入提示词的本体内容,只提供紧凑的来源与用法信息,详细记录全部按需检索。智能体只取当前这一步需要的语义。
构建阶段也有条硬规矩:每条承诺进本体的语义,都必须由一次可执行的探针查询作凭证,不能只是一句自然语言描述。消融实验证明这是整个系统里最承重的柱子之一。
静态注入掉分,按需检索涨分
先看最硬的一条。DDR-Bench 10-K 场景按轨迹级准确率计,六个骨干从 Qwen3.5-Flash 的 +4.8 到 GPT-5.5 的 +26.7,全部提升,平均涨 17.8 个点。
反过来,把构建者智能体的语义层当静态提示词直接前置(Baseline + SL),四个骨干上是负收益:GPT-5.5 63.9(−0.3)、GPT-5.6-sol 65.5(−3.0)、Claude-Sonnet-5 57.5(−15.0)、Claude-Opus-4.8 71.4(−1.6)。BIRD 基准上还有个分裂模式:Execution Accuracy 最多掉 5.6 个点,执行效率分却全线上升——静态语义层改善了 SQL 的"写法合规度",同时把注意力从"写对"上带偏了。
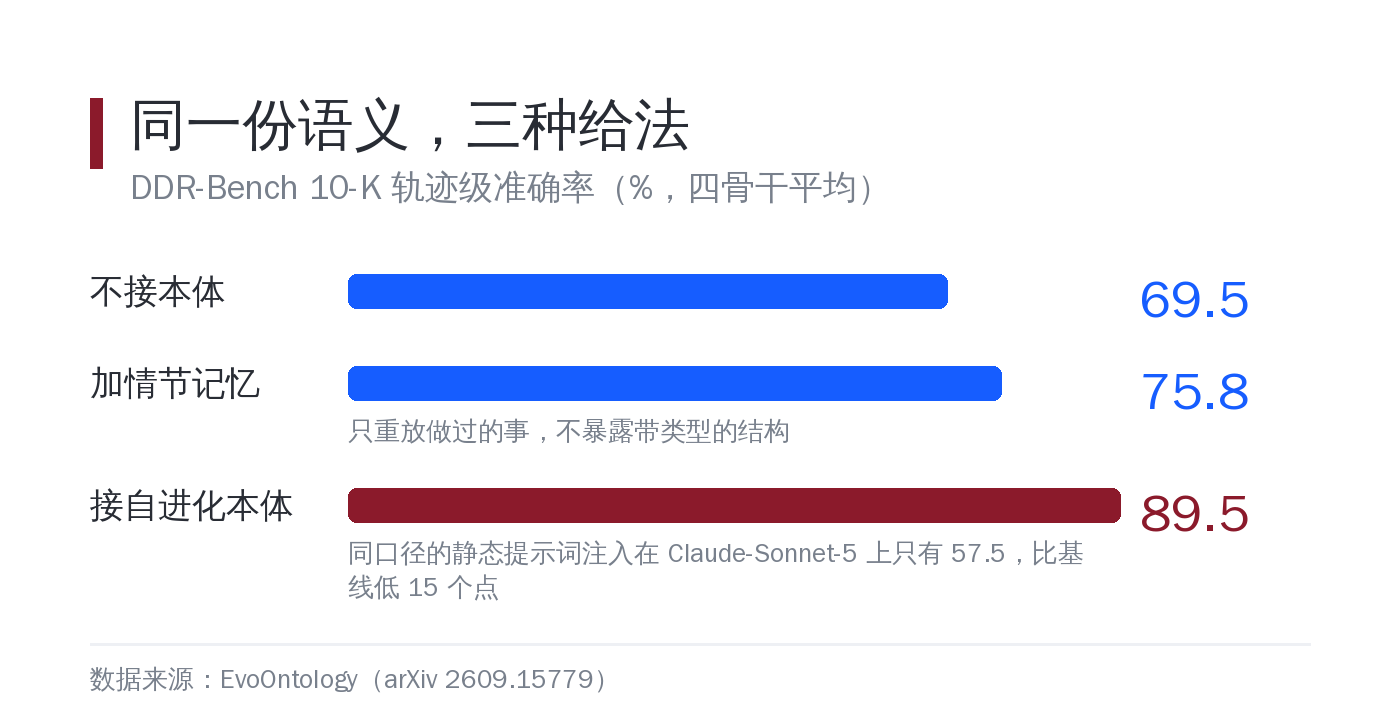
图注:DDR-Bench 10-K 轨迹级准确率(四骨干平均):不接本体 69.5、加情节记忆 75.8、接自进化本体 89.5——情节记忆只是重放做过的事,不暴露带类型、可组合的结构。
进化循环本身的消融也说明问题:去掉门控掉 11.2 个点,去掉归因掉 6.3,去掉诊断掉 4.8。这套循环的价值在"更挑剔",不在"更频繁"。成本账同样反直觉:manifest 加检索到的语义让每轮输入 token 从 3.2K 涨到 4.1K,但轨迹从 14.6 轮缩到 11.2 轮,每任务总成本反而略降到 50.4K;进化后轨迹压到 8.4 轮,总成本 42.0K,比不接本体低约 20%(来源:EvoOntology,arXiv 2609.15779)。
还有个工程上的账要提前算:不同骨干从同一初始状态出发会演化出不同的本体,跨骨干迁移至少掉 6.6 个点。标识符重叠度没有任何一对超过 0.62。多模型部署意味着要么接受人工的"本体运维",要么接受用共享本体换一部分性能。
源势AI观点
这几年企业买数据平台的逻辑正在变。CCSA 的《AI 原生数据平台研究报告(2026)》写得很明确:平台不再是传统架构的功能叠加,而是从计算、供给、治理、消费四个维度重构,从"为人服务"转向"为 AI 与 Agent 供给数据"(来源:CCSA《AI 原生数据平台研究报告(2026)》)。
EvoOntology 给了这条转向一个可验证的形态:语义资产不该是躺在提示词里的一段话,而该是能被查询、能被修订、有凭证的服务。源势AI 在给企业做数据智能体时会守住两条线。一是"每条语义都要有探针凭证"——本体里最值钱的不是漂亮的概念名,而是"这个概念对应哪一列"和"这个取值分布我亲眼看过"。二是先做语义确权再谈扩内容:口径不统一的时候堆再多知识,模型也只是更快地猜错。
话题标签:#语义层 #本体 #数据智能体
