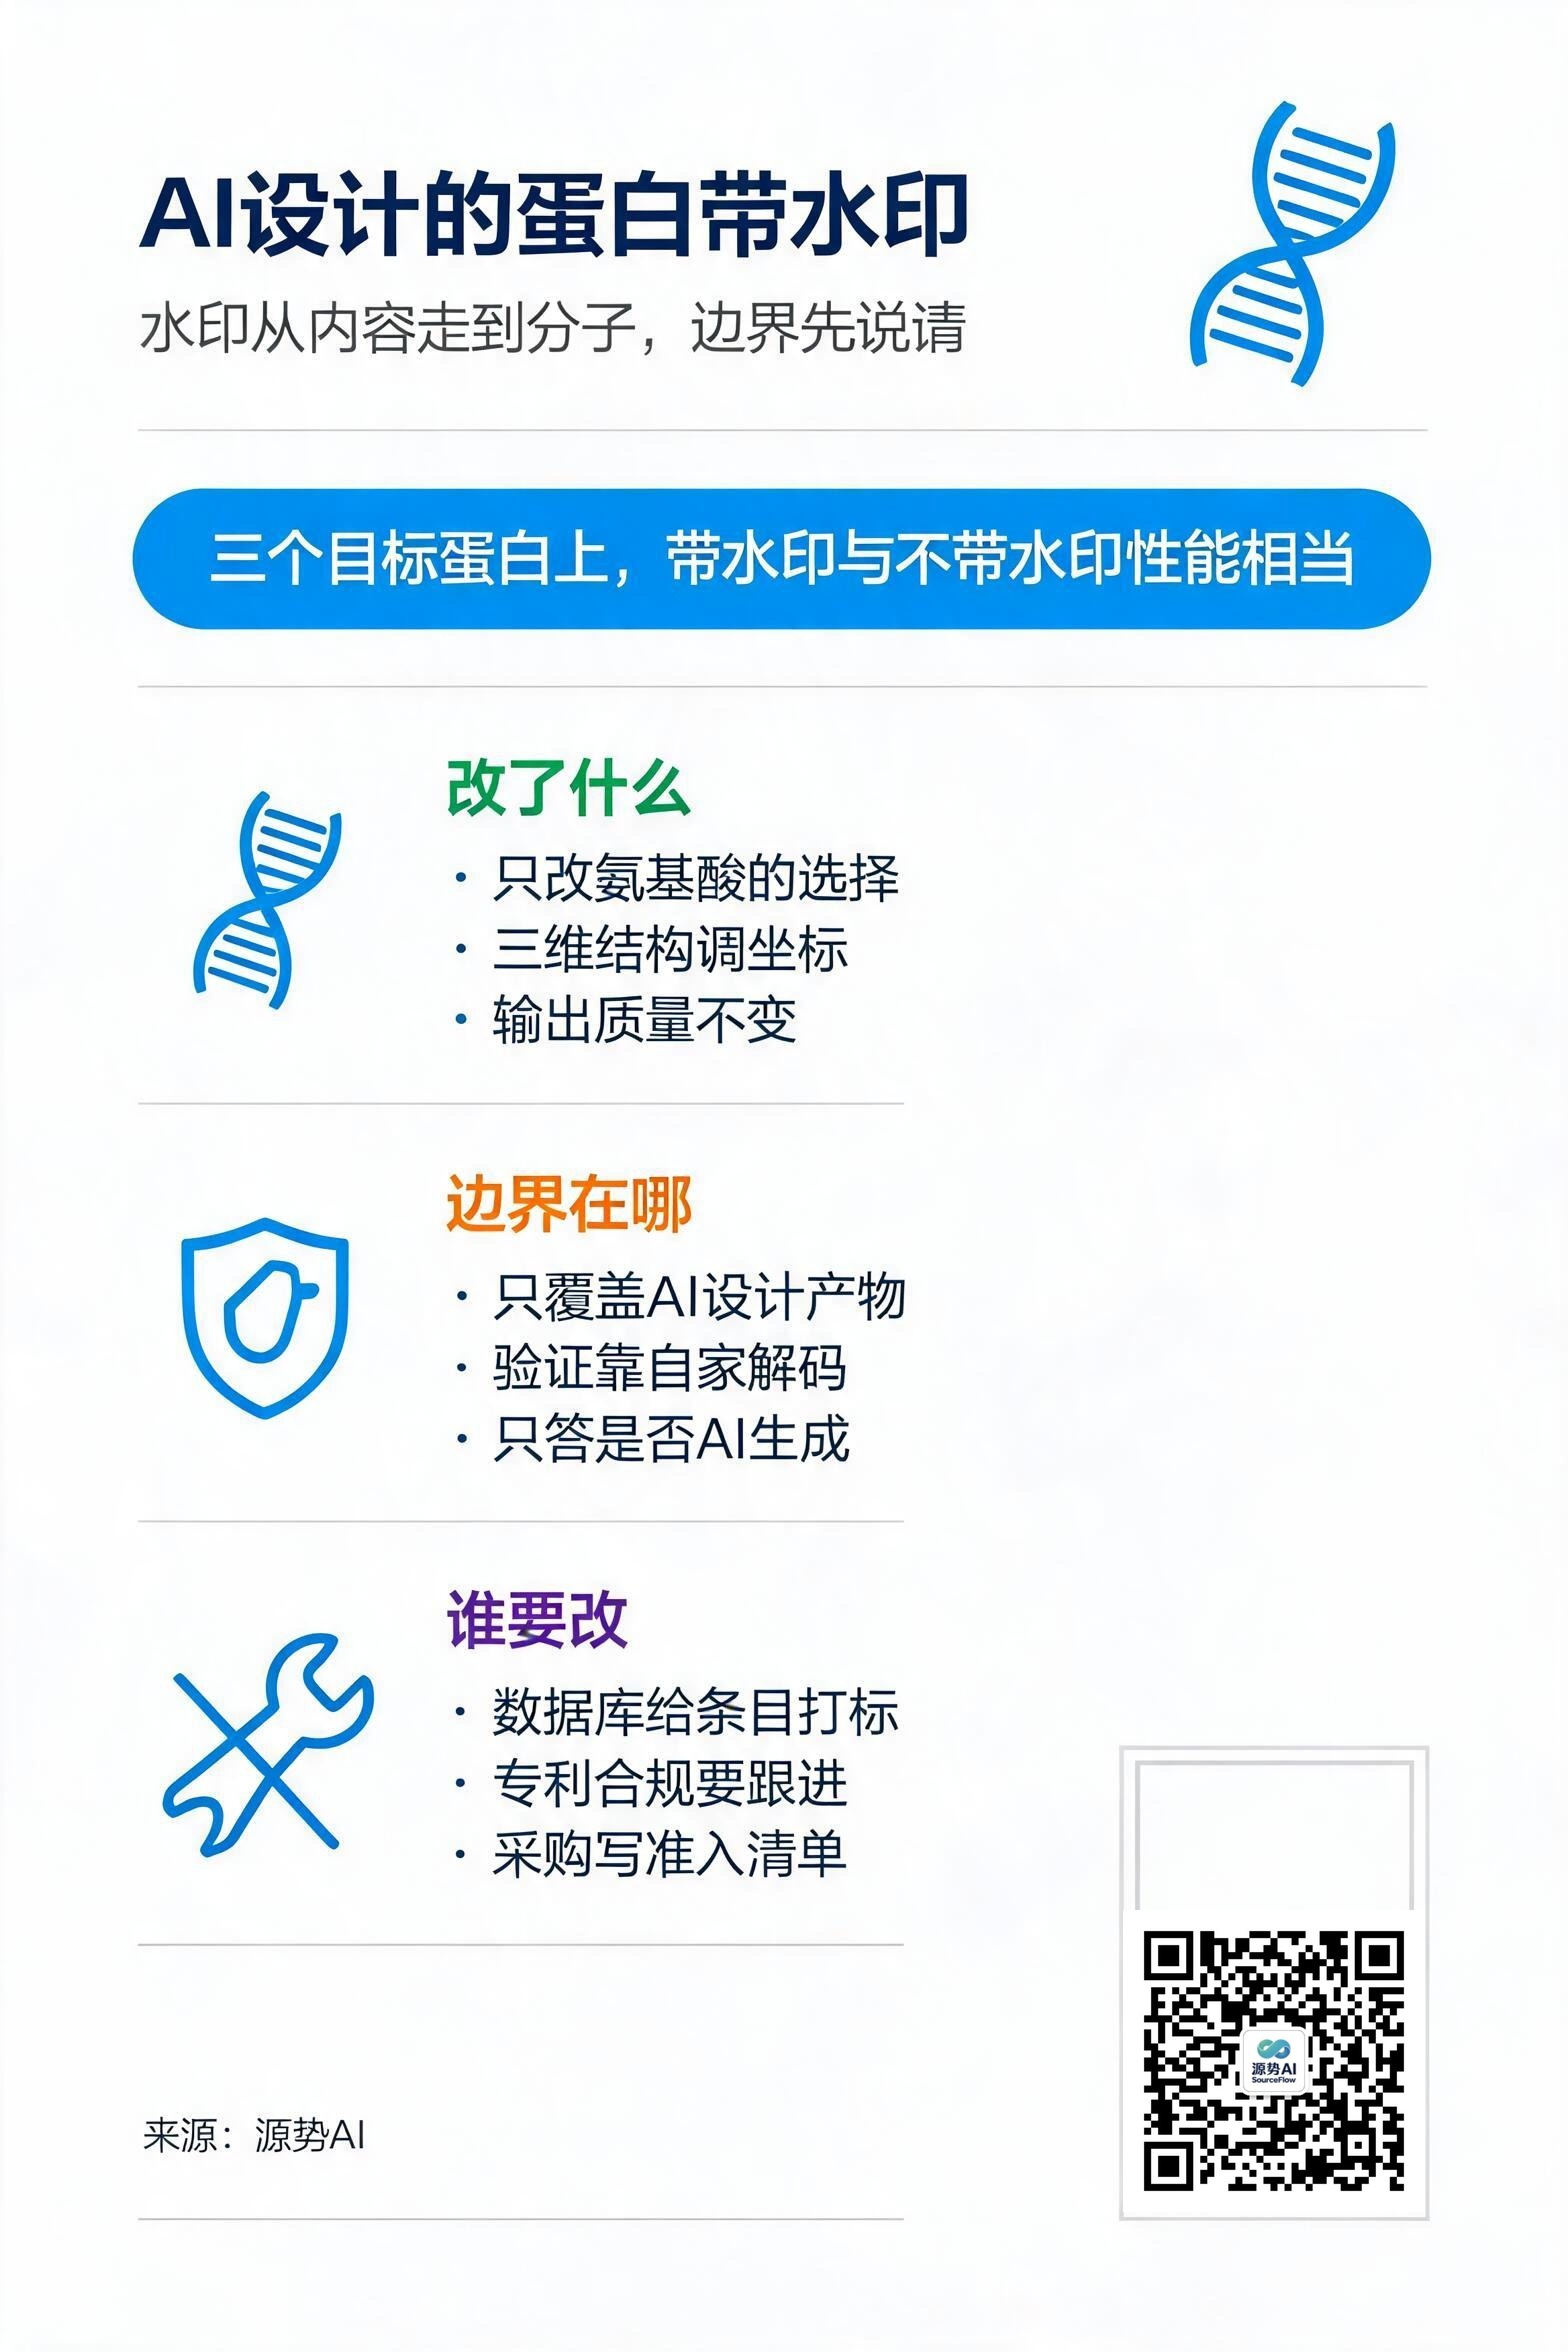
图注:SynthID Bio 在蛋白质序列与预测的三维结构两端分别嵌入标记,检测时不改变分子的化学性质
谷歌把数字水印从文字、图片、音频,搬到了合成生物学。
近日公布的 SynthID Bio,把不可感知、可验证的水印直接嵌进生物设计:AI 设计的蛋白质序列,以及它预测的三维结构,出厂就带一段机器能验、肉眼看不见的标记(来源:Unite.AI,转引自《AI行业24小时》,2026-10-01)。
过去两年,"AI 产出物带身份"这条线一直在内容行业里推进,标记对象是文本、图片、音频。这一次换成了分子——而分子是要进实验室、进数据库、进产业的。
改的是选词,也是选氨基酸
文本水印的原理不复杂。大模型生成文本时,有大量"选哪个词都行"的位置,水印只改这些位置的随机数来源:不再用任意随机数,改用密钥加前文算出来的数。输出质量不变,词序列本身变成一段可校验的签名(来源:Anthropic《Claude 文本水印的工作原理》,2026-08)。
SynthID Bio 走同一条路。对蛋白质序列,它轻微引导氨基酸的选择;对预测的三维结构,它调整原子坐标。
真正要看的限定词是"轻微"和"保持功能"。谷歌公布的湿实验验证里,团队用 AlphaProteo 做结合体设计,配上启用 SynthID Bio 的 ProteinMPNN,在 VEGF-A、SARS-CoV-2 刺突蛋白 RBD、PD-L1 三个目标蛋白上测试;带水印的设计在命中率、结合亲和力与自然序列多样性上,与不带水印的版本相当(来源:Unite.AI,转引自《AI行业24小时》,2026-10-01)。

图注:带水印与不带水印的设计在命中率、结合亲和力、序列多样性上表现相当,这是水印能被接受的前提
它先说清自己不是什么
比"能做什么"更该记住的是边界。
水印只覆盖"由 AI 设计"的蛋白序列与预测结构。实验室改造出来的分子、自然序列、传统计算方法产出的结构,都不在范围内。可验证性依赖谷歌自己的解码工具链,跨机构、跨国的验证机制没有公布。更要紧的一条:它首先回答"是否由 AI 生成",不是"谁生成"。
文本水印的软肋可以直接参照。短文本上效果差,可选词太少;事实性内容里水印稀疏,下一个词只有一个正确答案时水印无从介入;AI 校对人类文章的场景下,几乎所有词都是原作者的,水印几乎没有可附着的地方(来源:Anthropic《Claude 文本水印的工作原理》,2026-08)。
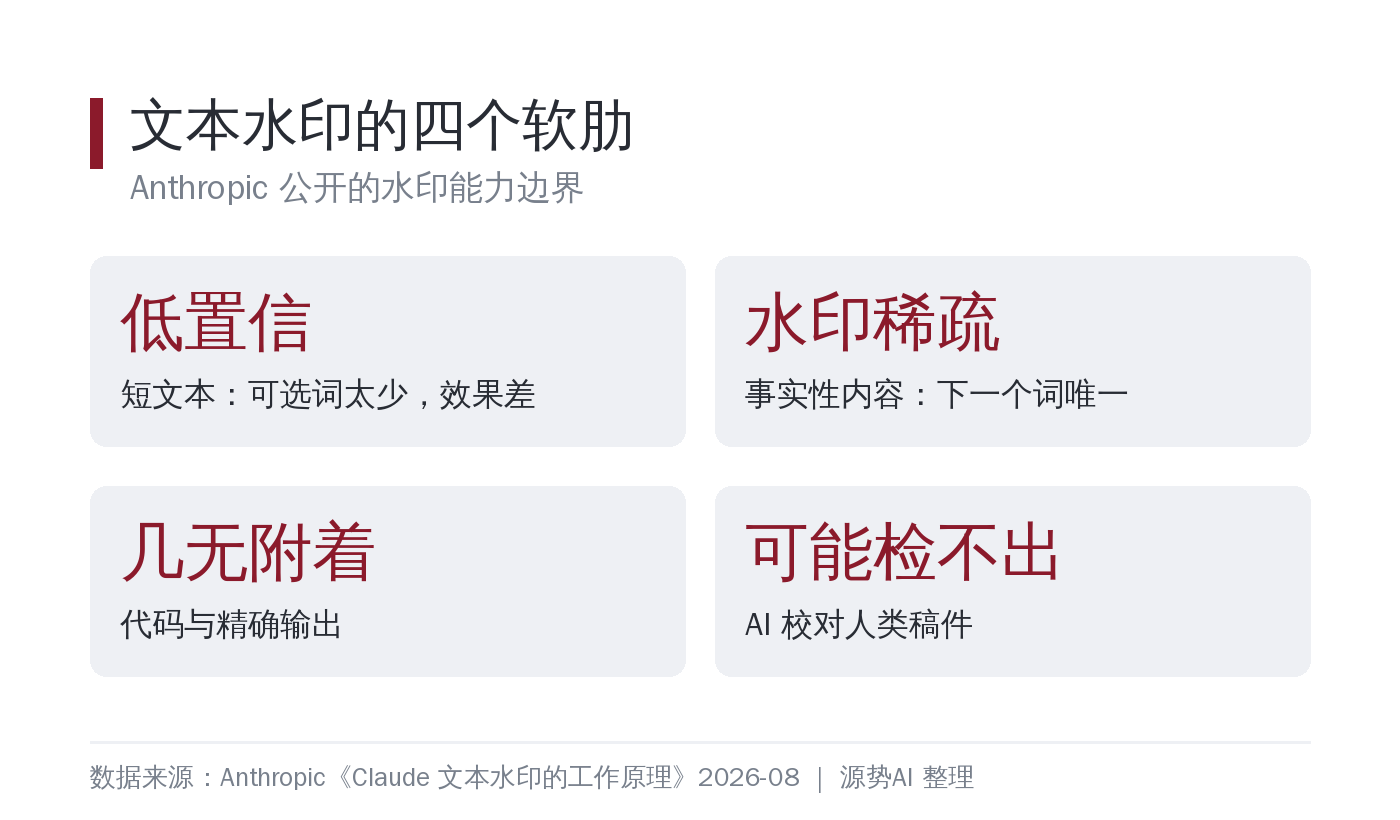
图注:长文本最可靠,代码、事实段落与轻度校对场景接近失效——生物设计里的"低自由度区"同理
为什么是生物设计先撞上这条线
水印搬进合成生物学,意味着模型开始直接参与设计能进实验室、进数据库、甚至进产业的生物分子。这类产出此前几乎没有可核验的来源标记。
把 AI 产出物当资产来管的地方,都会先撞上这个问题。攻防也在同步展开。Anthropic 公布文本水印细节的官方博客发布前三天,一个以"逐词重写"为核心的去水印仓库就已经把流程做成流水线;到第六天,它拿到一万一千多颗星。轻度修改洗不掉水印,逐词重写可以——这场攻防的研究记录已经走过四个回合,攻击面从文本一路铺到图像(来源:《AI水印攻防四回合:从隐形字符到像素重建》,AI-Fundamentals 研究报告)。溯源的另一条腿是可恢复语义指纹——在拿不到权重、只能黑盒调用的条件下,用扰动过的文本反推模型血统(来源:arXiv:2609.24084)。
水印回答"是不是 AI 生产的",指纹回答"出自哪个模型",交叉验证回答"这个来源可不可信"。三者在工程上落在不同位置:水印在生成端,指纹在模型端,交叉验证在调用端。
更直接的影响在数据侧。开放蛋白质数据库的完整性维护,长期依赖投稿方自证来源;一旦上游设计工具默认加水印,数据库可以用检测结果给条目打标,不再只听作者声明。合成的序列如果开始带标记,训练数据集的"成分表"也就有了落地办法——这对下一轮模型训练意味着能追溯来源、能筛掉污染样本。
平台侧的流程要重算
对做生物医药与合成生物的平台,问题很具体:上游模型如果默认给设计加标记,下游的筛选、专利与合规流程要不要跟着改。
数据库完整性维护、开放科学数据的来源标注、"这个设计是不是 AI 做的"这类核验,都要求在设计环节就埋好接口。等分子进了库、进了专利文本再回头补,成本要高一个量级。
筛选环节也一样。湿实验验证过的蛋白如果出自 AI 设计,实验记录的元数据要不要一并带上标识?这件事决定了几年后回看这批数据时,还能不能分清哪些是模型提的、哪些是人工改过的。
源势AI观点
我们的判断是,把这类标识当成产品需求,而不是合规负担。
第一,内容与设计两条产品线共用一套"标识中台"。里面是几件很具体的事:显式标识按平台细则在文本首尾或图片角标上落字形;隐式标识把服务商编码、内容编号写进文件元数据,导出时不能丢;导出链路保全是指每一道转格式、压缩、转存的工序都要带上上一层的标识,掉一层就等于没标。这些事在不同行业里长得不一样,工程上是同一套。
第二,别指望单一技术兜底。水印是概率证据,需要和来源凭证、平台声明、检测模型组合成多层验证。我们在 Token 聚合平台上跑着二十多个模型的调用,企业客户接下来的审计需求会很实际:这份交付物是哪个模型生成的、有没有经过标识核验。管道层留一个验真接口,比事后补救便宜得多。
第三,采购时把标识能力写进准入清单。水印出得越早,去水印的对抗也来得越快,指望"上线即安全"不现实。2026 到 2027 年,供应商能不能支持标识核验、能不能在导出链路上保全元数据,会成为一轮筛选的分水岭。
话题标签:#AI水印 #合成生物 #内容溯源
