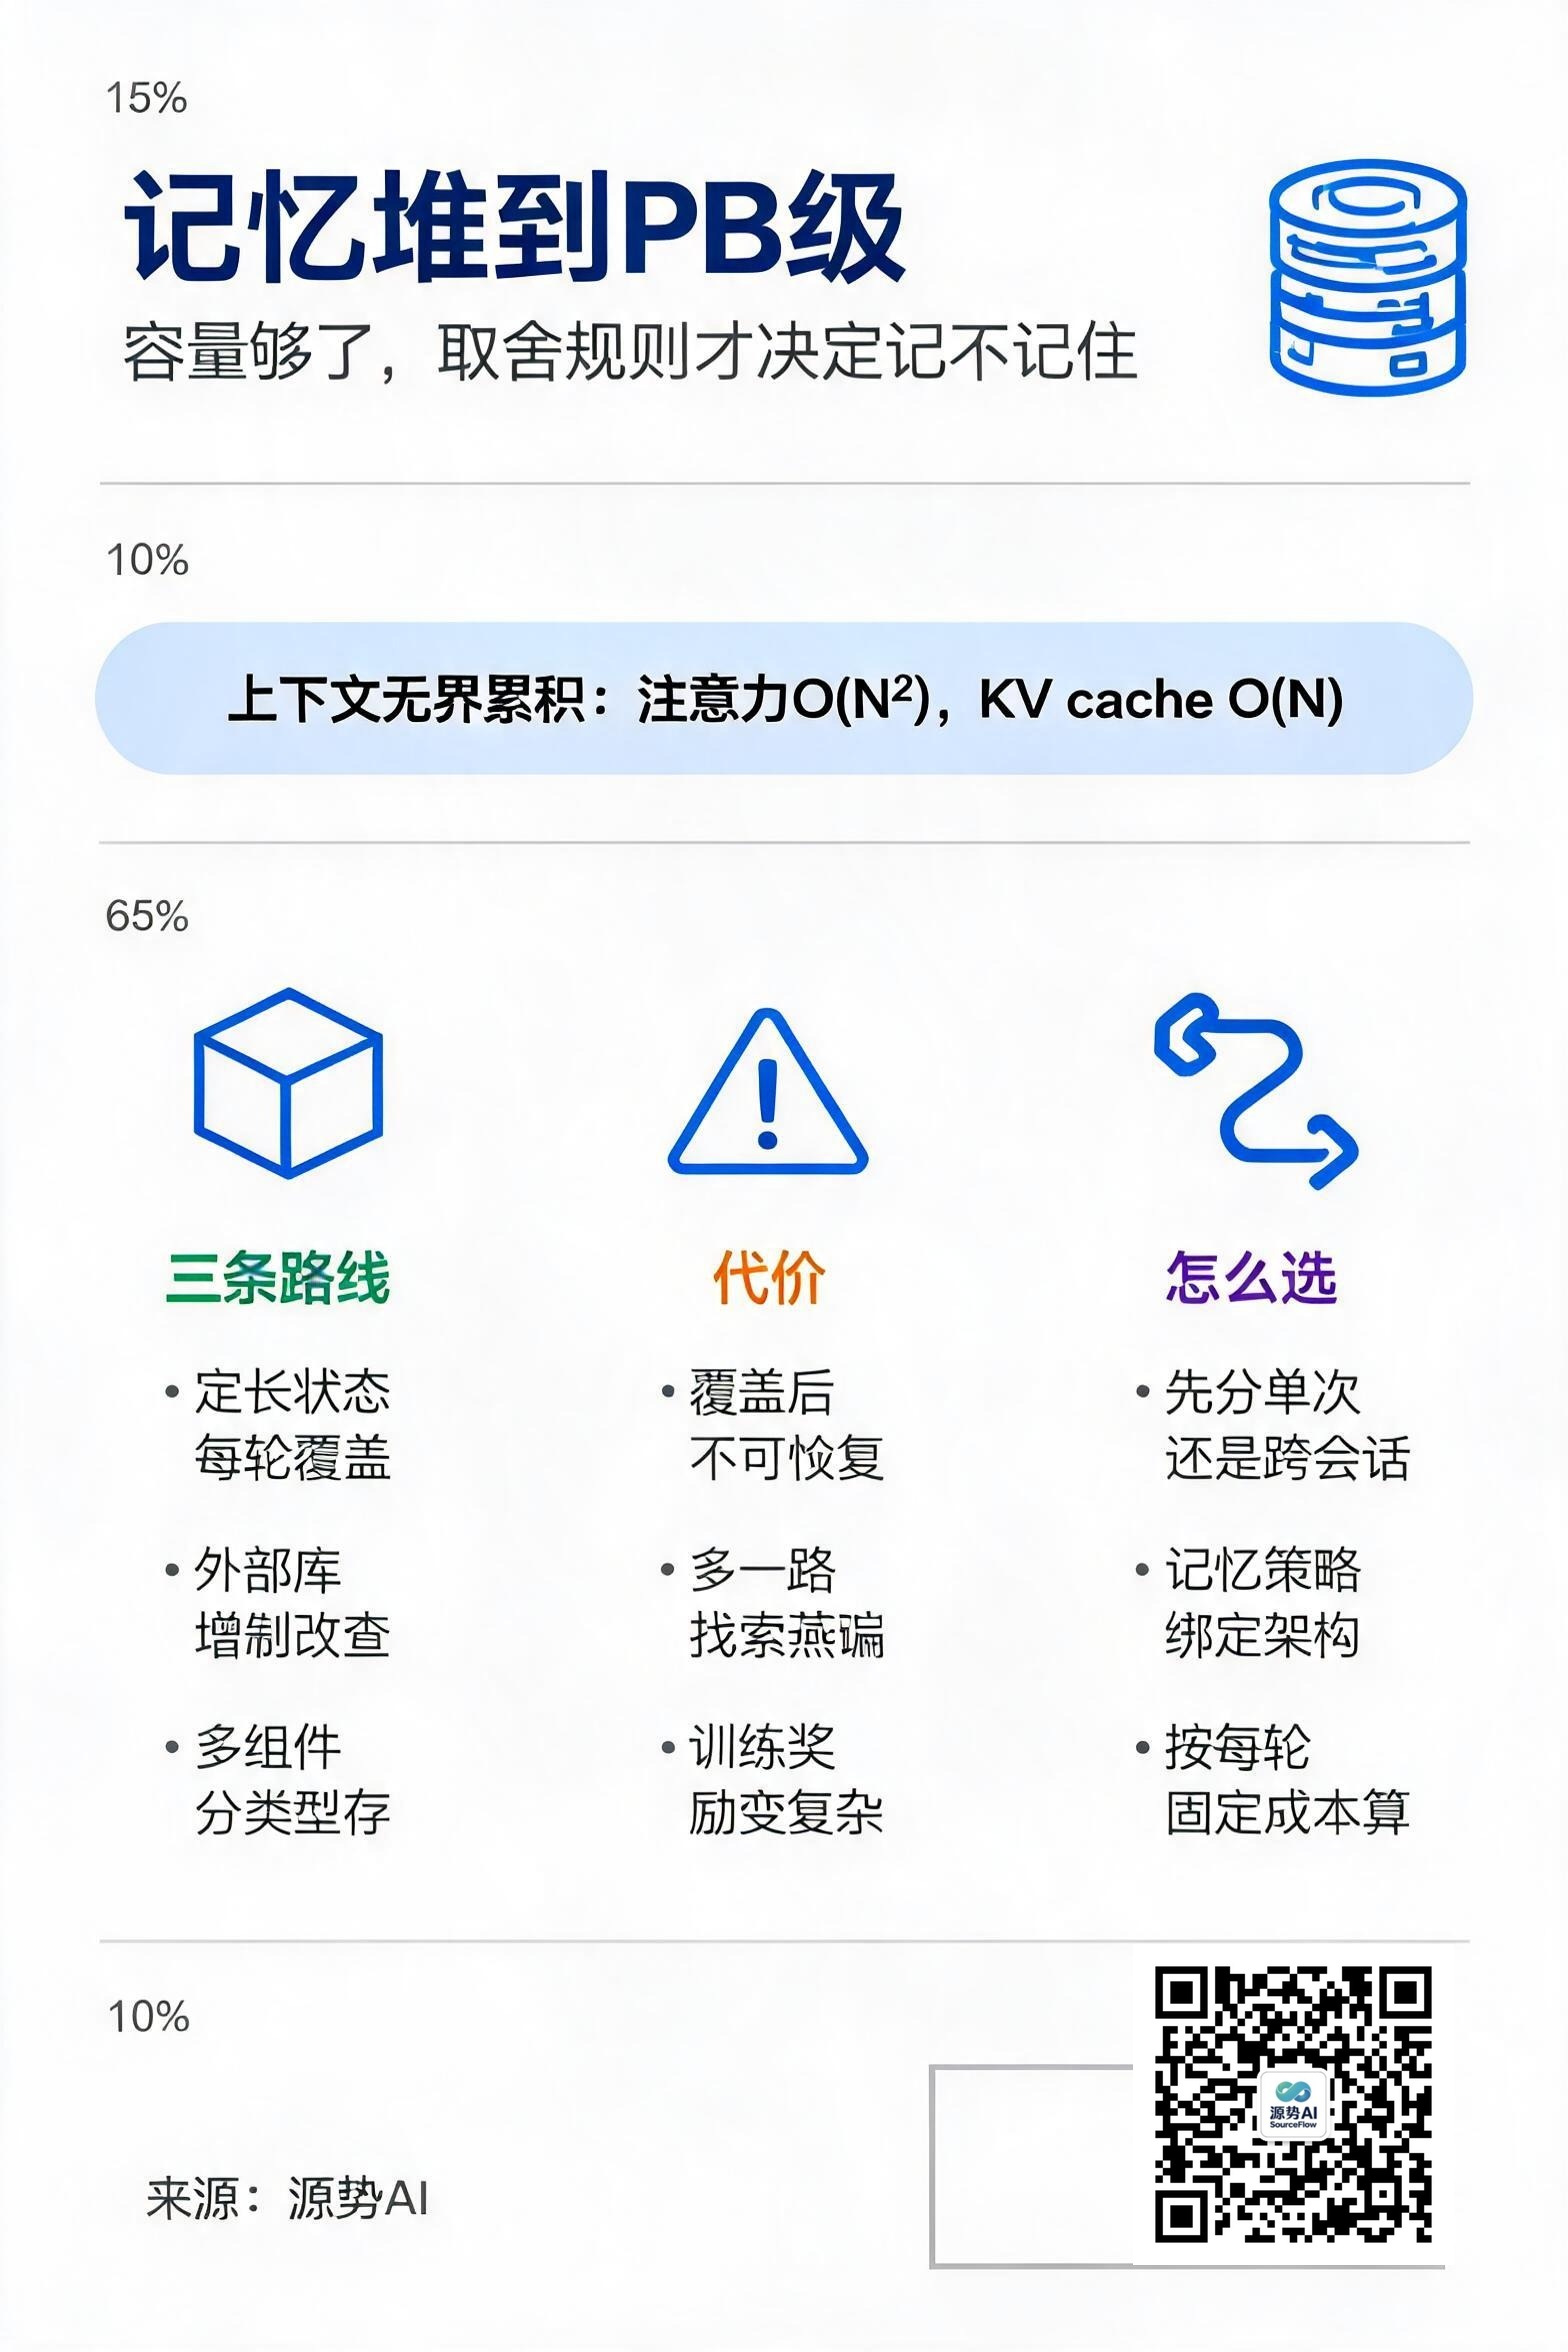
华为把智算集群的记忆存储推到了 PB 级。
按华为 9 月全联接大会公布的时间表,灵衢昇腾 950 智算集群服务自 9 月 30 日起在国内商用。硬件侧的配套是一块专为智能体准备的存储:CMS 记忆存储方案构建 PB 级记忆空间,存储容量较业界同类产品提升 1 倍,支持 TB 级记忆高速读取、性能较业界同类产品提升 50%;记忆模组具备 65T 性能,基于华为自研芯片,可按情况动态调整快慢 SSD 比例,并通过灵衢与 NPU 及 HBM 直连(来源:21世纪经济报道,转引自《AI行业24小时》,2026-10-01)。
同一批公布的集群指标是:云上训练 40 天稳定运行、10 分钟内故障恢复;通过调度、缓存与算法协同优化,Token 吞吐性能相比上一代算力提升 20%(来源:21世纪经济报道,转引自《AI行业24小时_20261001_10》,2026-10-01)。
硬件把记忆堆到 PB 级的同时,算法侧在说另一件事:记忆不是存得多就行。
记忆管理是决策问题
长程任务最朴素的解法,是把每一轮的思考、动作、观察都拼进上下文。于是上下文长度随交互轮次近乎线性增长。MEM1 把这种"无界累积"的代价列成三条:推理代价与显存随长度 N 上升(注意力是 O(N²),带 KV cache 是 O(N)),超出训练长度后输入落进分布外、泛化失效,冗余内容还会稀释注意力(来源:《强化学习驱动的 LLM 智能体记忆管理:六篇论文对比》,2026-07)。
难的地方在于,"记什么、改什么、丢什么"本身是个决策问题,写更复杂的 system prompt 解决不了。Memory-R1 给了个很直观的例子:用户先说"领养了一只叫 Buddy 的狗",又说"又领养了一只叫 Scout 的狗",未经学习的记忆系统会把后者误判为矛盾,发出 DELETE + ADD 把原记忆覆盖掉;学习过的系统发一条 UPDATE,把事实合并成"领养了两只狗"。
这六篇论文共享同一个直觉:用强化学习端到端学记忆管理,而不是硬编码它。分歧在于学的是什么样的记忆、用什么奖励学、把记忆写到哪里。
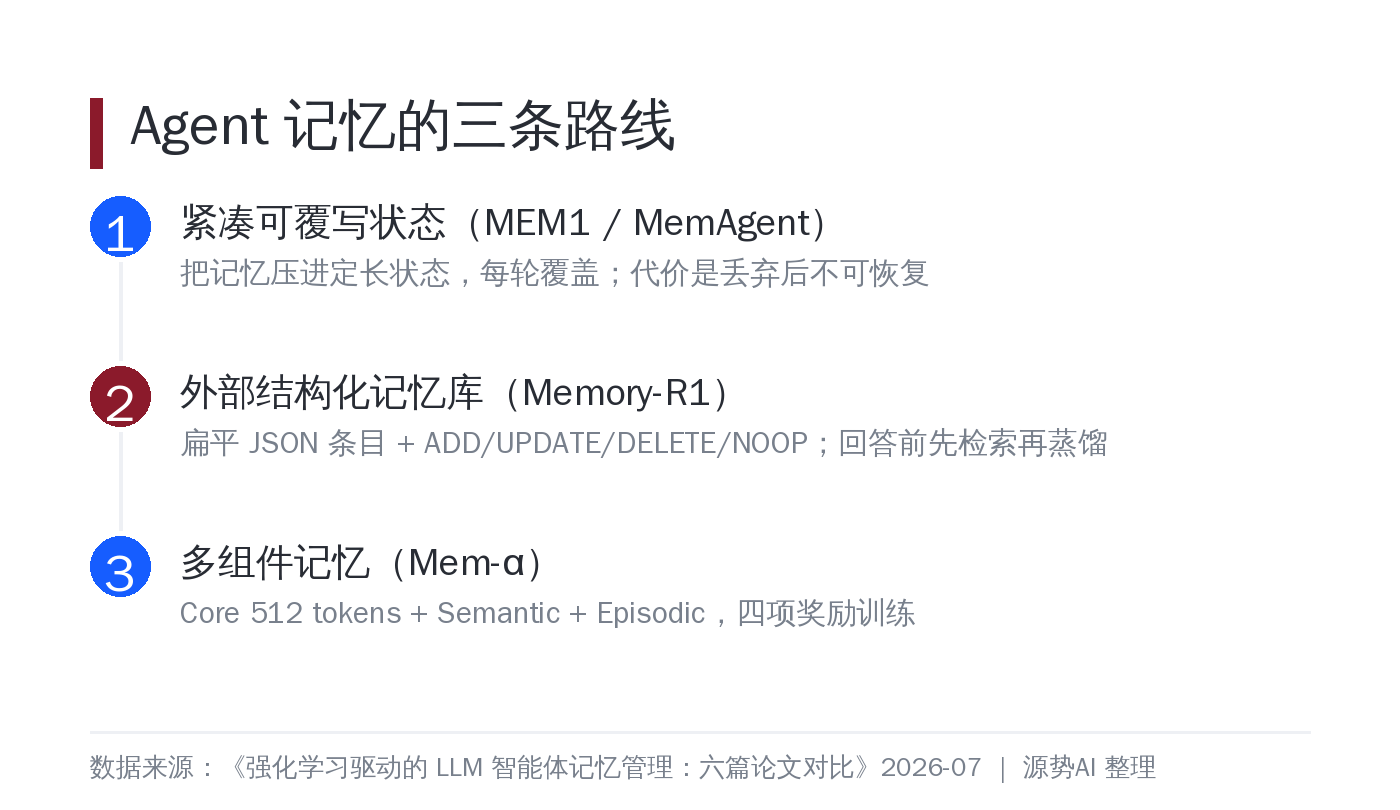
图注:从紧凑可覆写状态,到外部结构化记忆库,再到多组件记忆,路线分歧都在"记忆放在哪、由谁决定"
覆盖式记忆的代价
MEM1 和 MemAgent 各自独立选了同一条路:让策略每轮把记忆压进一个定长状态并覆盖旧值,使每步代价与总长度脱钩。MemAgent 把记忆建模为定长 token 序列,长度 1024;MEM1 用一个融合推理与记忆的状态块,每轮覆盖并剪枝上一轮的所有标签。
代价很清楚:容量被压在一个固定预算里,信息一旦被丢弃就不可恢复。Mem-α 的引言直接批评这类做法"采用相对简单的记忆结构(如记忆重写或维护一份事实列表),不足以处理长叙事、过程性规则、演化知识"。
于是有了第二条路线:把记忆搬出上下文,放进外部结构化记忆库。Memory-R1 用一个由 {id, text, event} 条目组成的扁平 JSON 列表承载记忆,由管理器对新信息发出 ADD / UPDATE / DELETE / NOOP 之一;回答时先经检索再推理,再由一个独立的 Answer Agent 把检索回的 60 条候选蒸馏到相关子集。
第三条路线在多组件上走得更远。Mem-α 搭了三层结构:持续留在上下文里的 Core Memory,上限 512 tokens;Semantic Memory 存放原子事实;Episodic Memory 存带时间戳的事件。训练上用了四项奖励,其中"记忆内容有效性"这一项由一个冻结的 Qwen3-32B 判官逐操作打分。
记忆也要垃圾回收
另一批同期工作从别的角度切同一块蛋糕。上海交大、OPPO 与新加坡国立大学的团队提出用检索反馈持续重组记忆,让记忆在每次被召回后重新巩固,而不是写完就不动(来源:《用检索反馈持续重组记忆》,arXiv:2609.16053)。
北京智源等机构的工作更具体:长期记忆里,临时信息会覆盖掉本该留下的内容。他们提出生命周期感知的状态融合,按信息的新鲜度与稳定性分配权重,抑制临时信息覆写(来源:《生命周期感知的长期记忆,抑制临时信息覆盖》,arXiv:2609.12436)。
还有一条路径把记忆当作推理期预算来在线分配,以及给长程智能体的记忆做垃圾回收。方向不同,落点一致:记忆系统的复杂度正在从"存"转向"管"。
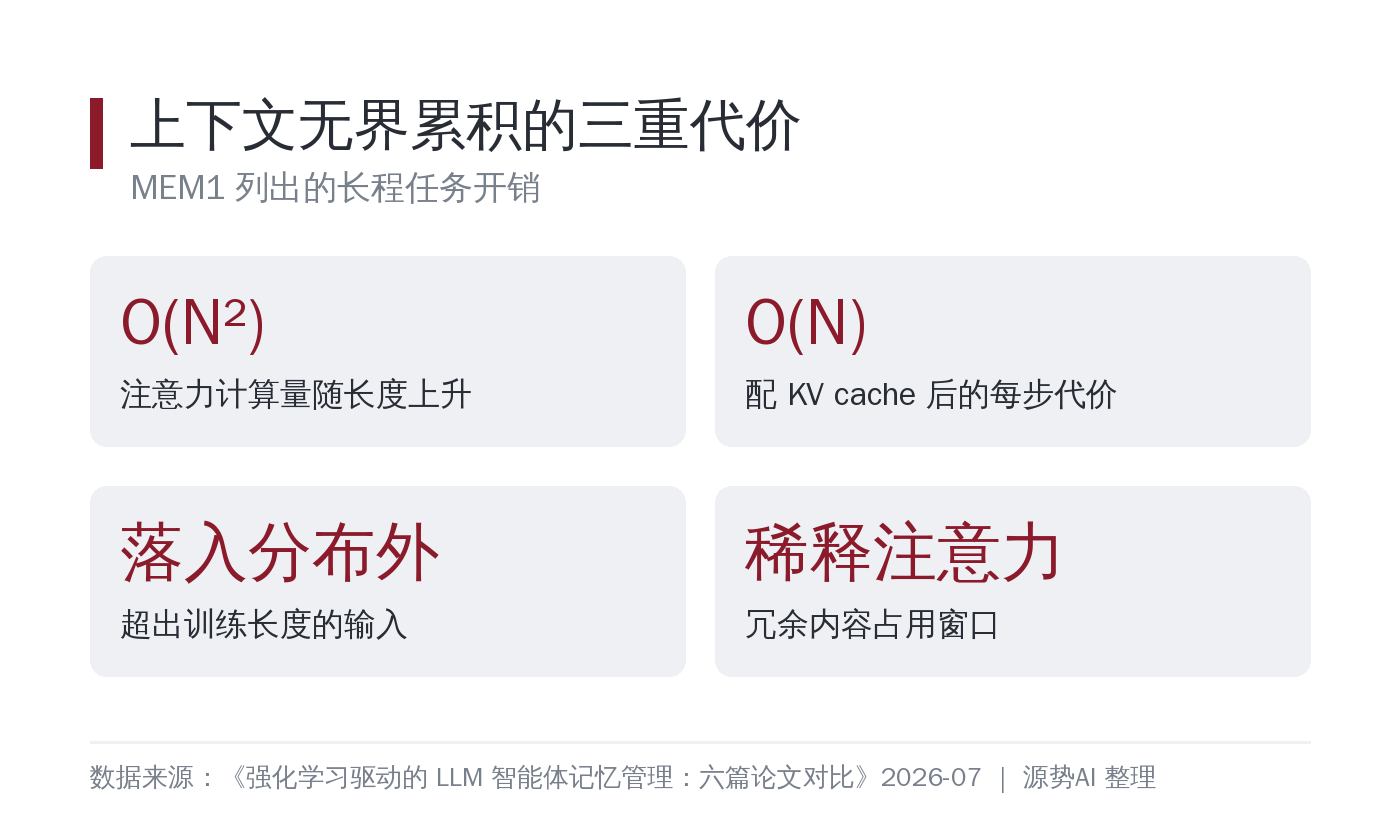
图注:左侧是上下文无界累积的三重代价,右侧是对应的三条工程路线;硬件给容量,算法给取舍规则
落到工程上是什么
给正在做落地的人三条可操作的判断。
第一,先量清楚任务是在"单次请求内多轮",还是"跨多次会话长期运行"。前者管的是工作上下文,后者管的是长期记忆,对应的技术选型完全不同。
第二,别把记忆策略和服务架构解耦。覆盖式状态省钱但有信息不可恢复的风险;外部记忆库可追溯但要多一跳检索和一次蒸馏。选哪条,取决于业务能不能接受"记错了无法回滚"。
第三,预算按"每轮固定成本"而不是"总算力"来编。定长状态的意义是让每步代价与总长度脱钩,这在多轮任务里省下的通常是数量级。
源势AI观点
我们的判断是,企业对智能体的预算,会从算力往记忆上挪。
现在多数企业的 Agent 项目预算表里,记忆是个附属项,写的是"数据库或向量库"。但长程任务一上来,瓶颈就暴露了:不是模型不够聪明,是它记不住前面发生过什么,于是每一步都在重复劳动。
我们给客户做落地时,把记忆拆成三层来报:工作上下文(当轮怎么压缩)、会话记忆(跨轮怎么存)、组织记忆(企业知识怎么沉淀)。三层各有各的指标,混在一起谈,最后一定超支。
硬件给出 PB 级容量是好事,但它只解决第三层的一半。真正的成本在取舍规则上——什么时候覆盖、什么时候合并、什么时候该丢。这套规则要跟着业务定义,抄不来。
话题标签:#智能体记忆 #长程任务 #AI基建
