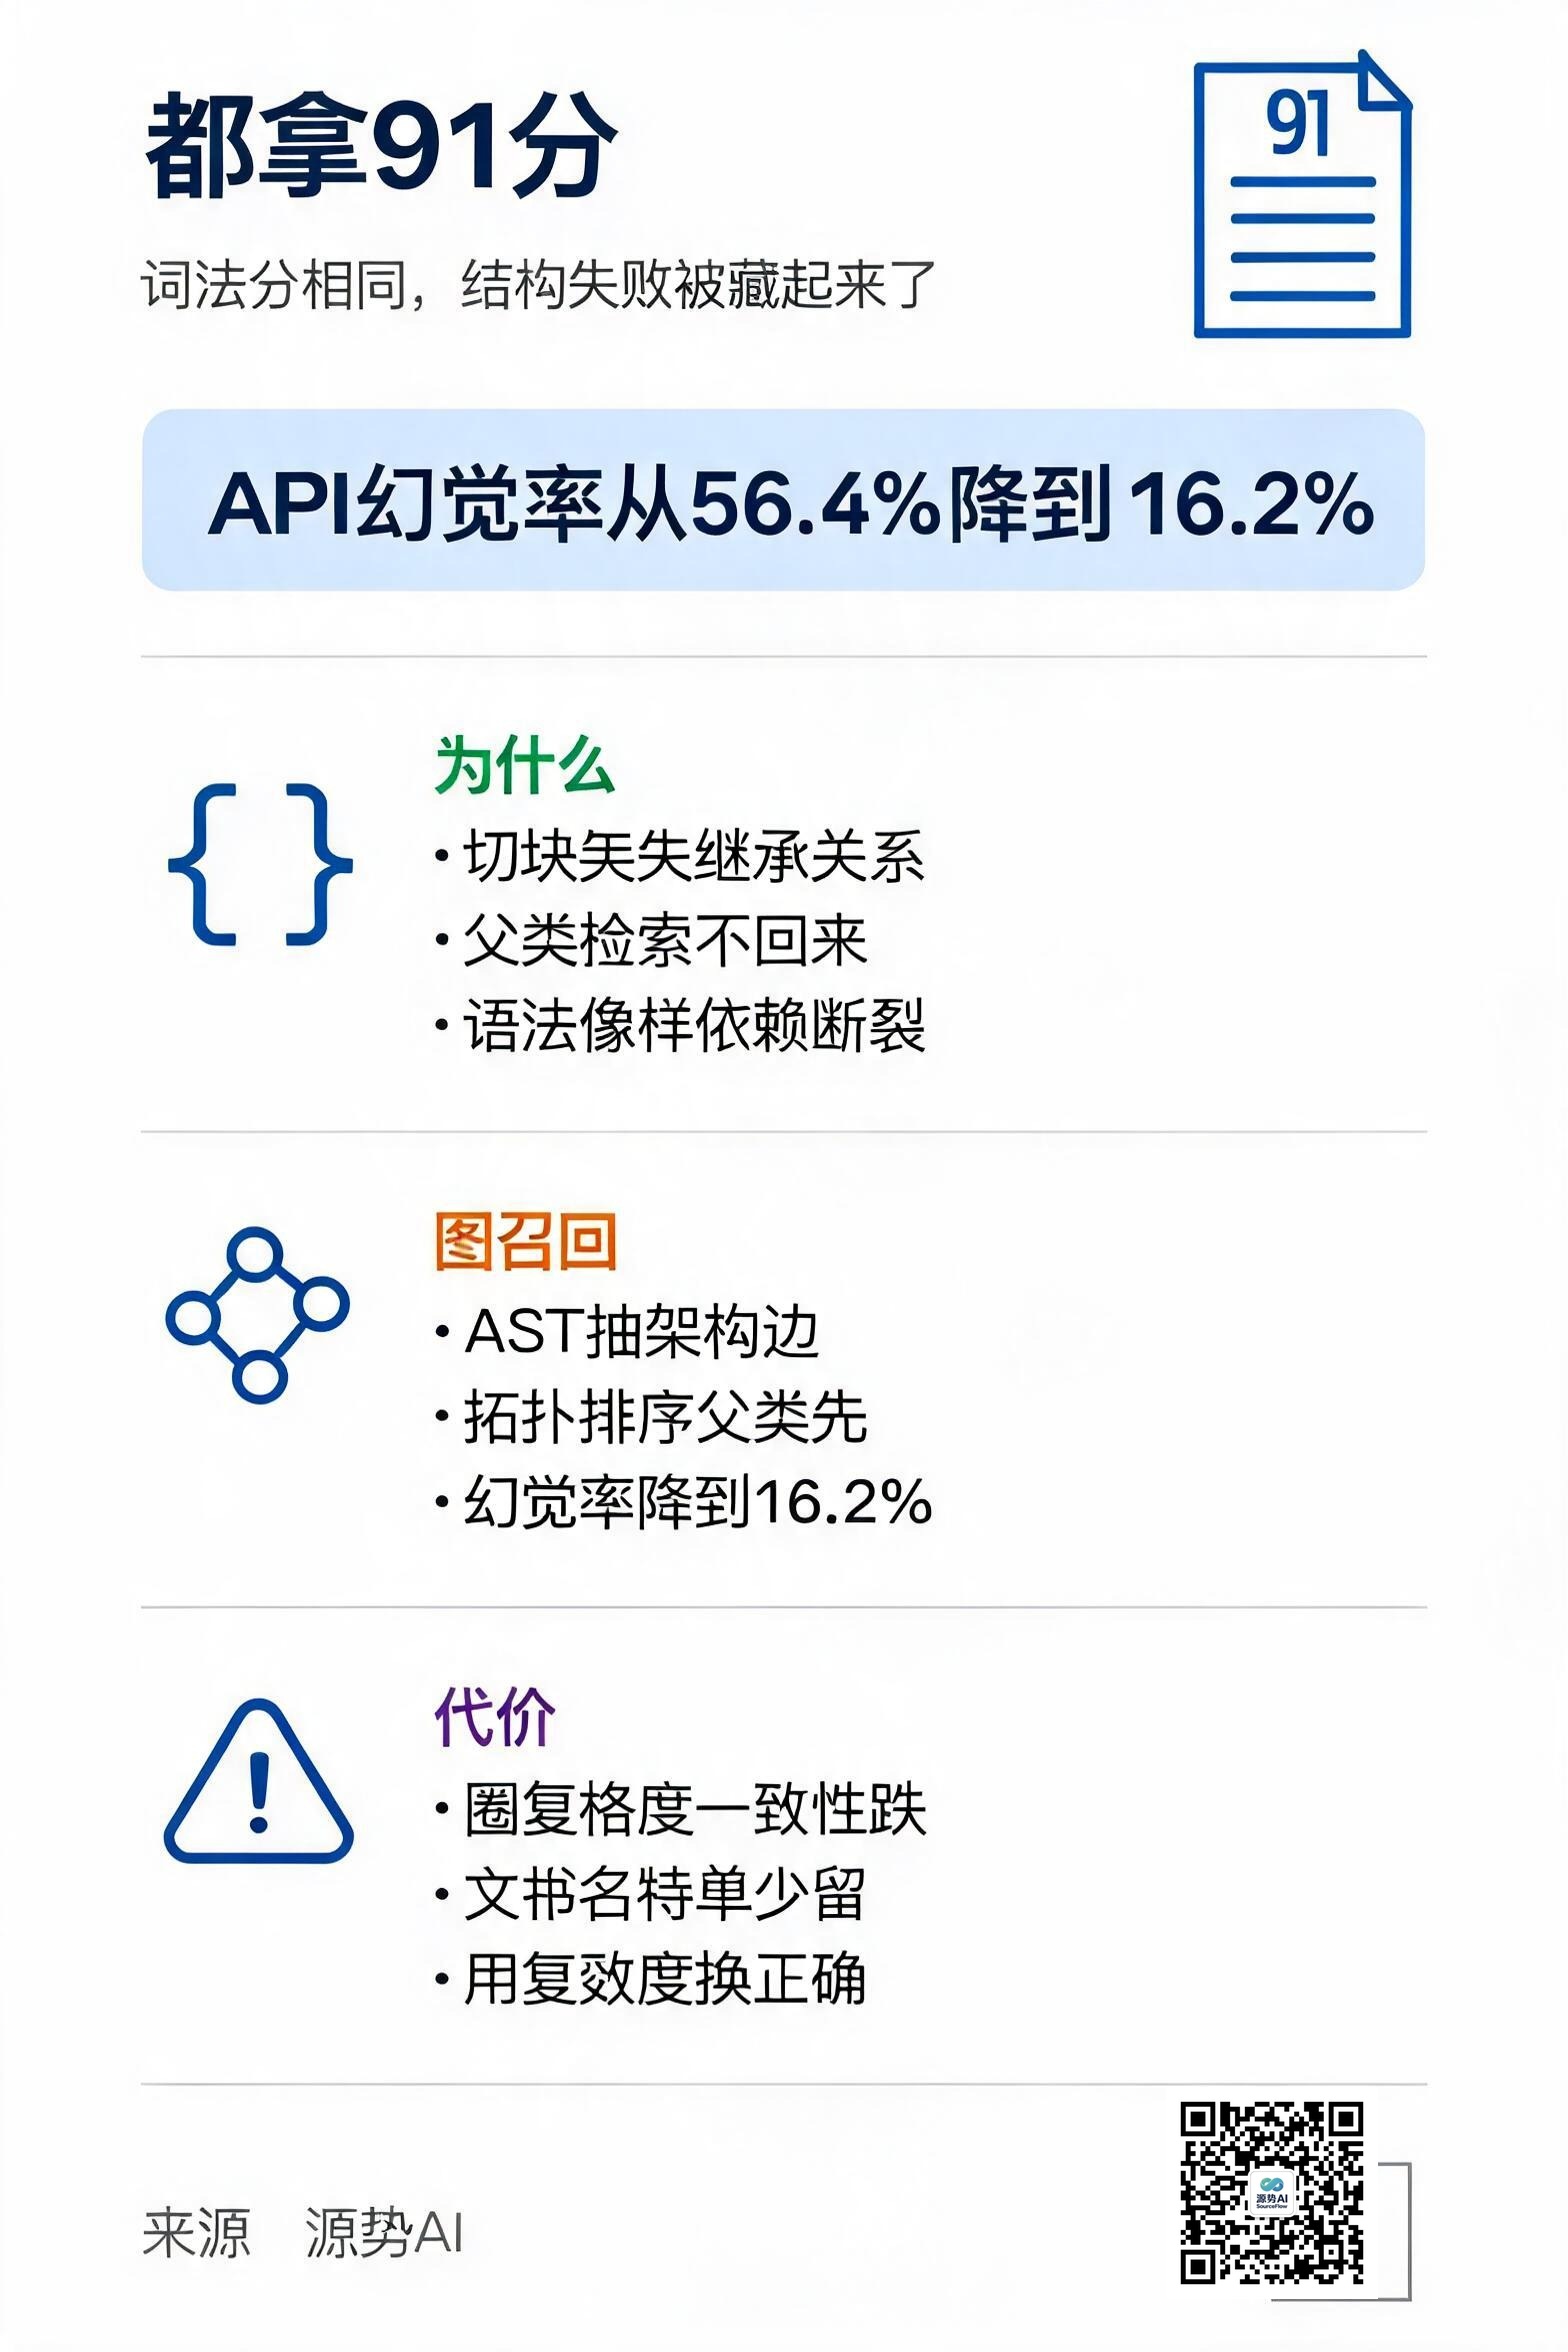
两个方案在企业代码迁移上都拿了 91 分,但一个的 API 幻觉率是 56.4%,另一个只有 16.2%——这组数字出自 Google Cloud 团队在 arXiv 上的一份对比研究(来源:《Graph RAG vs Standard RAG:企业代码迁移对比研究》,arXiv:2609.12464)。
论文把传统向量检索方案(Standard RAG)和分层上下文图方案(Graph RAG)放在同一个 Java 到 Python 的迁移任务上跑,目标仓库是耦合度很高的 spring-petclinic-genai。
词法指标把结构失败藏起来了
两个方法的平均 CodeBLEU 都是 91%(来源:《Graph RAG vs Standard RAG:企业代码迁移对比研究》,arXiv:2609.12464)。这个分数看起来说明水平相当,实际掩盖了结构差异:Standard RAG 生成的代码语法上像模像样,依赖关系却大面积断裂,超过一半的输出都在幻觉 API。
换成图召回,API 幻觉率降到 16.2%,依赖解析质量从 34.8% 提到 65.9%,父子一致性从 26.7% 提到 45.5%(来源:《Graph RAG vs Standard RAG:企业代码迁移对比研究》,arXiv:2609.12464)。
差异来自检索方式。Standard RAG 把代码切成块做向量检索,一个嵌套很深的子类,和它继承的接口之间可能零词法重叠,检索根本取不回父类,拓扑关系就断了。论文提出的 HCRG 方法用 tree-sitter 抽多语言 AST,把架构边(INHERITS、CALLS、IMPORTS)映射到属性图,再序列化进模型的上下文缓存,按拓扑排序做父类优先翻译。
论文的一个明确结论是:词法 N-gram 指标测不出这种差距,需要换成 7 项软件工程指标——迁移质量、父子一致性、类型提示完成度、Lint 状态、依赖解析质量、圈复杂度一致性、文档字符串保留率。
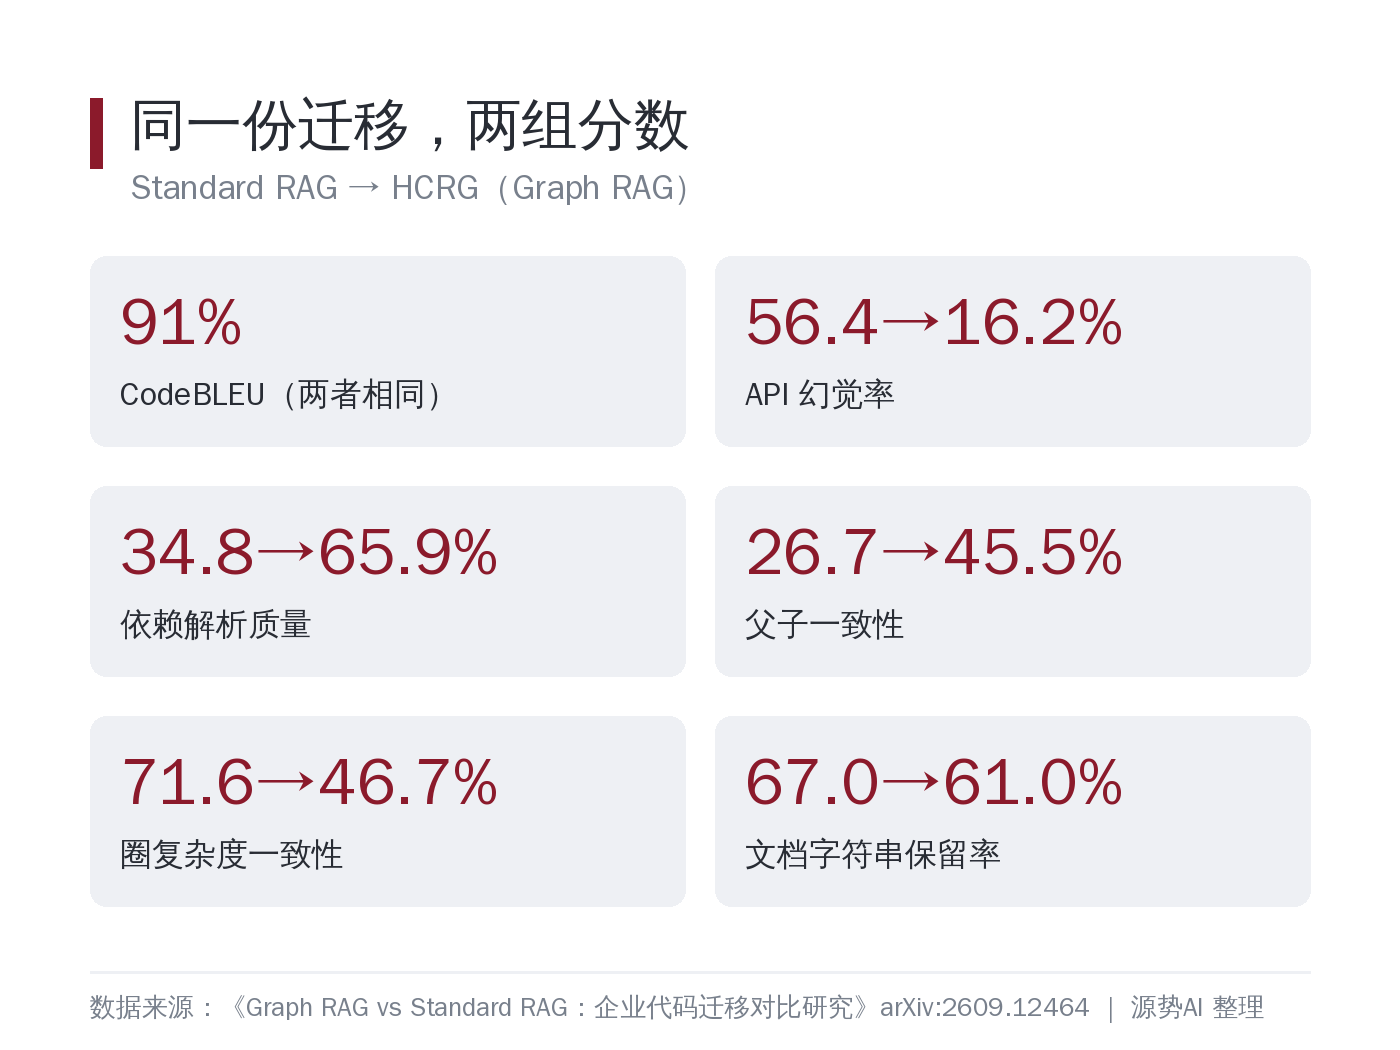
图注:两个方法的 CodeBLEU 完全相同,拆成结构指标后差距才显形;API 幻觉率与依赖解析质量是分化最大的两项
图召回也不是全面更强
图召回同样有代价。
把全局结构视野交给模型之后,它开始防御性过度工程:圈复杂度一致性从 71.6% 掉到 46.7%,文档字符串保留率从 67.0% 降到 61.0%(来源:《Graph RAG vs Standard RAG:企业代码迁移对比研究》,arXiv:2609.12464)。
论文自己的定性很克制:用代码复杂度的上升,换 API 幻觉的显著下降,对自动化改造遗留系统来说,这条路更站得住。
这个取舍值得记住。它不是"图召回更好"的站队结论,而是"你要的是能编译,还是要的是能维护"。搬迁类项目通常选前者,长期迭代的系统得两个都要。
谷歌内部已经在跑更大的迁移
同一周,谷歌在 Gemini 4 Argon 的发布里给了一组内部用例。
一组智能体分析全公司数据中心的性能剖析数据,自主定位并应用内存优化,铺开后释放了超过 300TiB 内存,预计节省总量在 500TiB 到 1PiB 之间。同一批智能体还被用来把 C/C++ 代码库迁到 Rust,涉及 Fuchsia OS 的 Zircon 内核等超过 80 万行的项目;在开源视频解码器 libgav1 上,它们替换了 3.2 万行 SIMD 代码,最终得到一个内存安全、比原 Rust 移植版快 2.7 倍的解码器(来源:IT时代网,转引自《AI行业24小时_20261001_10》,2026-10-01)。
口径要一并记住:这些都是谷歌自测,没有第三方复测,也没披露代码正确率、回归测试通过率与工时。这类规模数字是方向信号,不是可以直接写进立项书的基准。
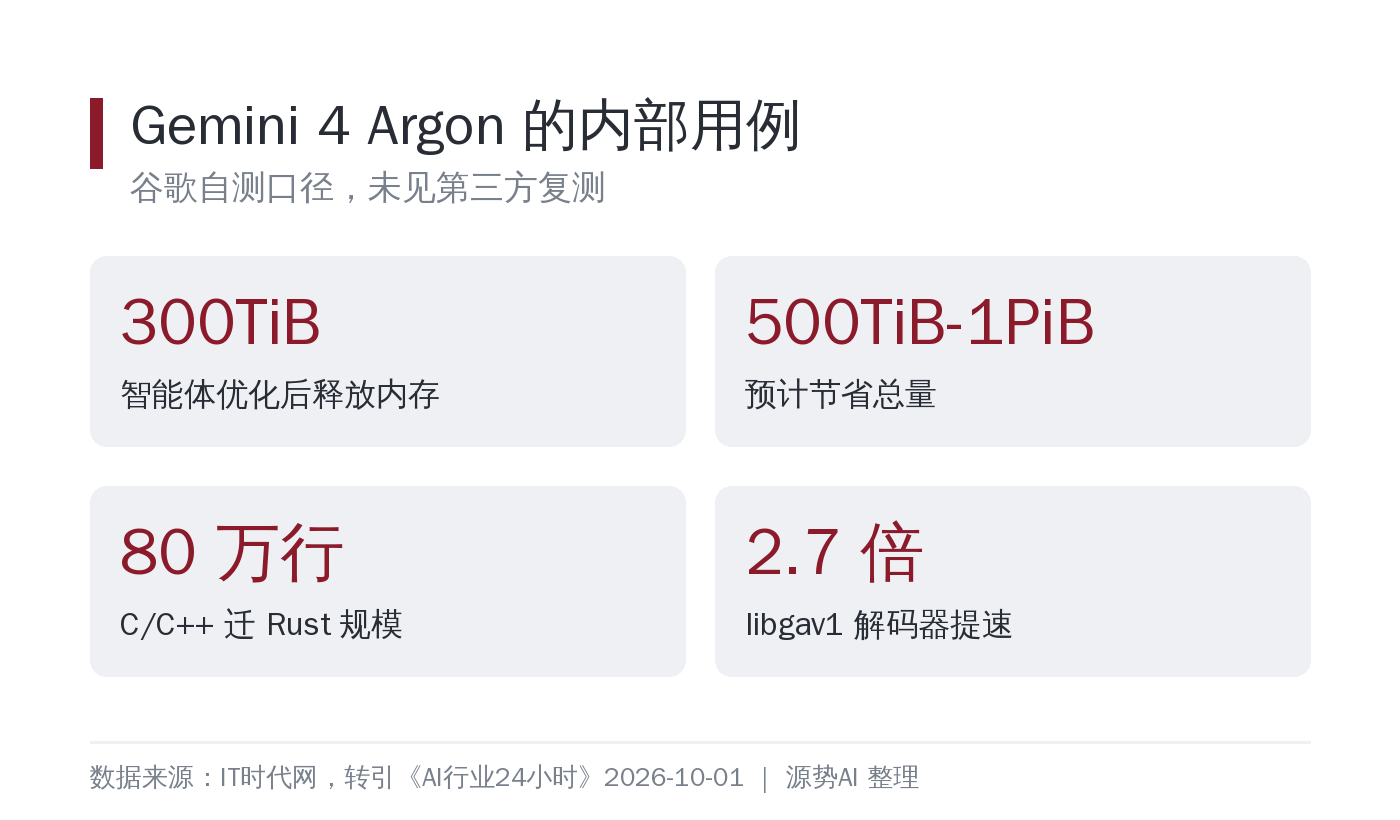
图注:数据中心内存优化与代码库迁移,是同一批智能体在两个方向上产出的结果;数字均为谷歌自测口径
对做遗留系统改造的人意味着什么
三条落地的判断。
第一,评估口径要提前换掉。用行级相似度或 CodeBLEU 验收 AI 迁移的代码,等于默认放行"语法对、依赖错"的产出。把依赖解析质量、父子一致性、圈复杂度一致性写进验收表,才拦得住。
第二,图召回的门槛不在模型,在 AST 和依赖边。tree-sitter 抽 AST、把架构边映射成图这两步要工程投入,没有这层结构化数据,图召回退化回普通检索。
第三,小步验证。这类研究给出的迁移规模只有几千行级的公开仓库,企业内部动辄数十万行,先在耦合度最高的一条业务链上跑通,再决定要不要铺开。
补充一个容易踩的坑:公开仓库的代码质量通常高于真实系统。企业内部代码里,动态调用、反射、生成式代码、以及没有文档的历史补丁占比高得多,AST 抽不全的地方,图召回也会跟着失效。选试点仓库时,先看它跟你最想改造的那套系统有几分像,别只看它跑起来漂不漂亮。
源势AI观点
我们的判断是,AI 迁移代码这件事,从"能不能做"进入了"用什么标准验收"的阶段。
给客户做遗留系统改造时,我们现在的做法是先建依赖图谱,再让模型动代码——顺序反了就得多花一轮返工。图谱这一层不产生新增代码量,但它是唯一能把"改完能跑"和"改完能维护"分开的东西。
第二点更实际:把迁移拆成"结构翻译"和"行为对齐"两个阶段分别验收。前者用图召回和结构指标,后者用回归测试和线上流量回放。混在一个环节里评,分数永远是虚的。
第三,别用一次成功的案例去估算整体成本。论文里的仓库是公开的小项目,真实系统里长尾依赖、动态调用、生成式代码的比例都高得多,那部分才是成本的主要来源。
话题标签:#AI代码迁移 #图召回 #遗留系统
