把检索交给外部服务,隐忧有两层:服务端看得见你的查询,也决定返回哪些证据。前者是机密性,后者是完整性。
两篇同期上线的论文,分别给出了这两件事当前的工程边界。
私有检索走到了分钟级
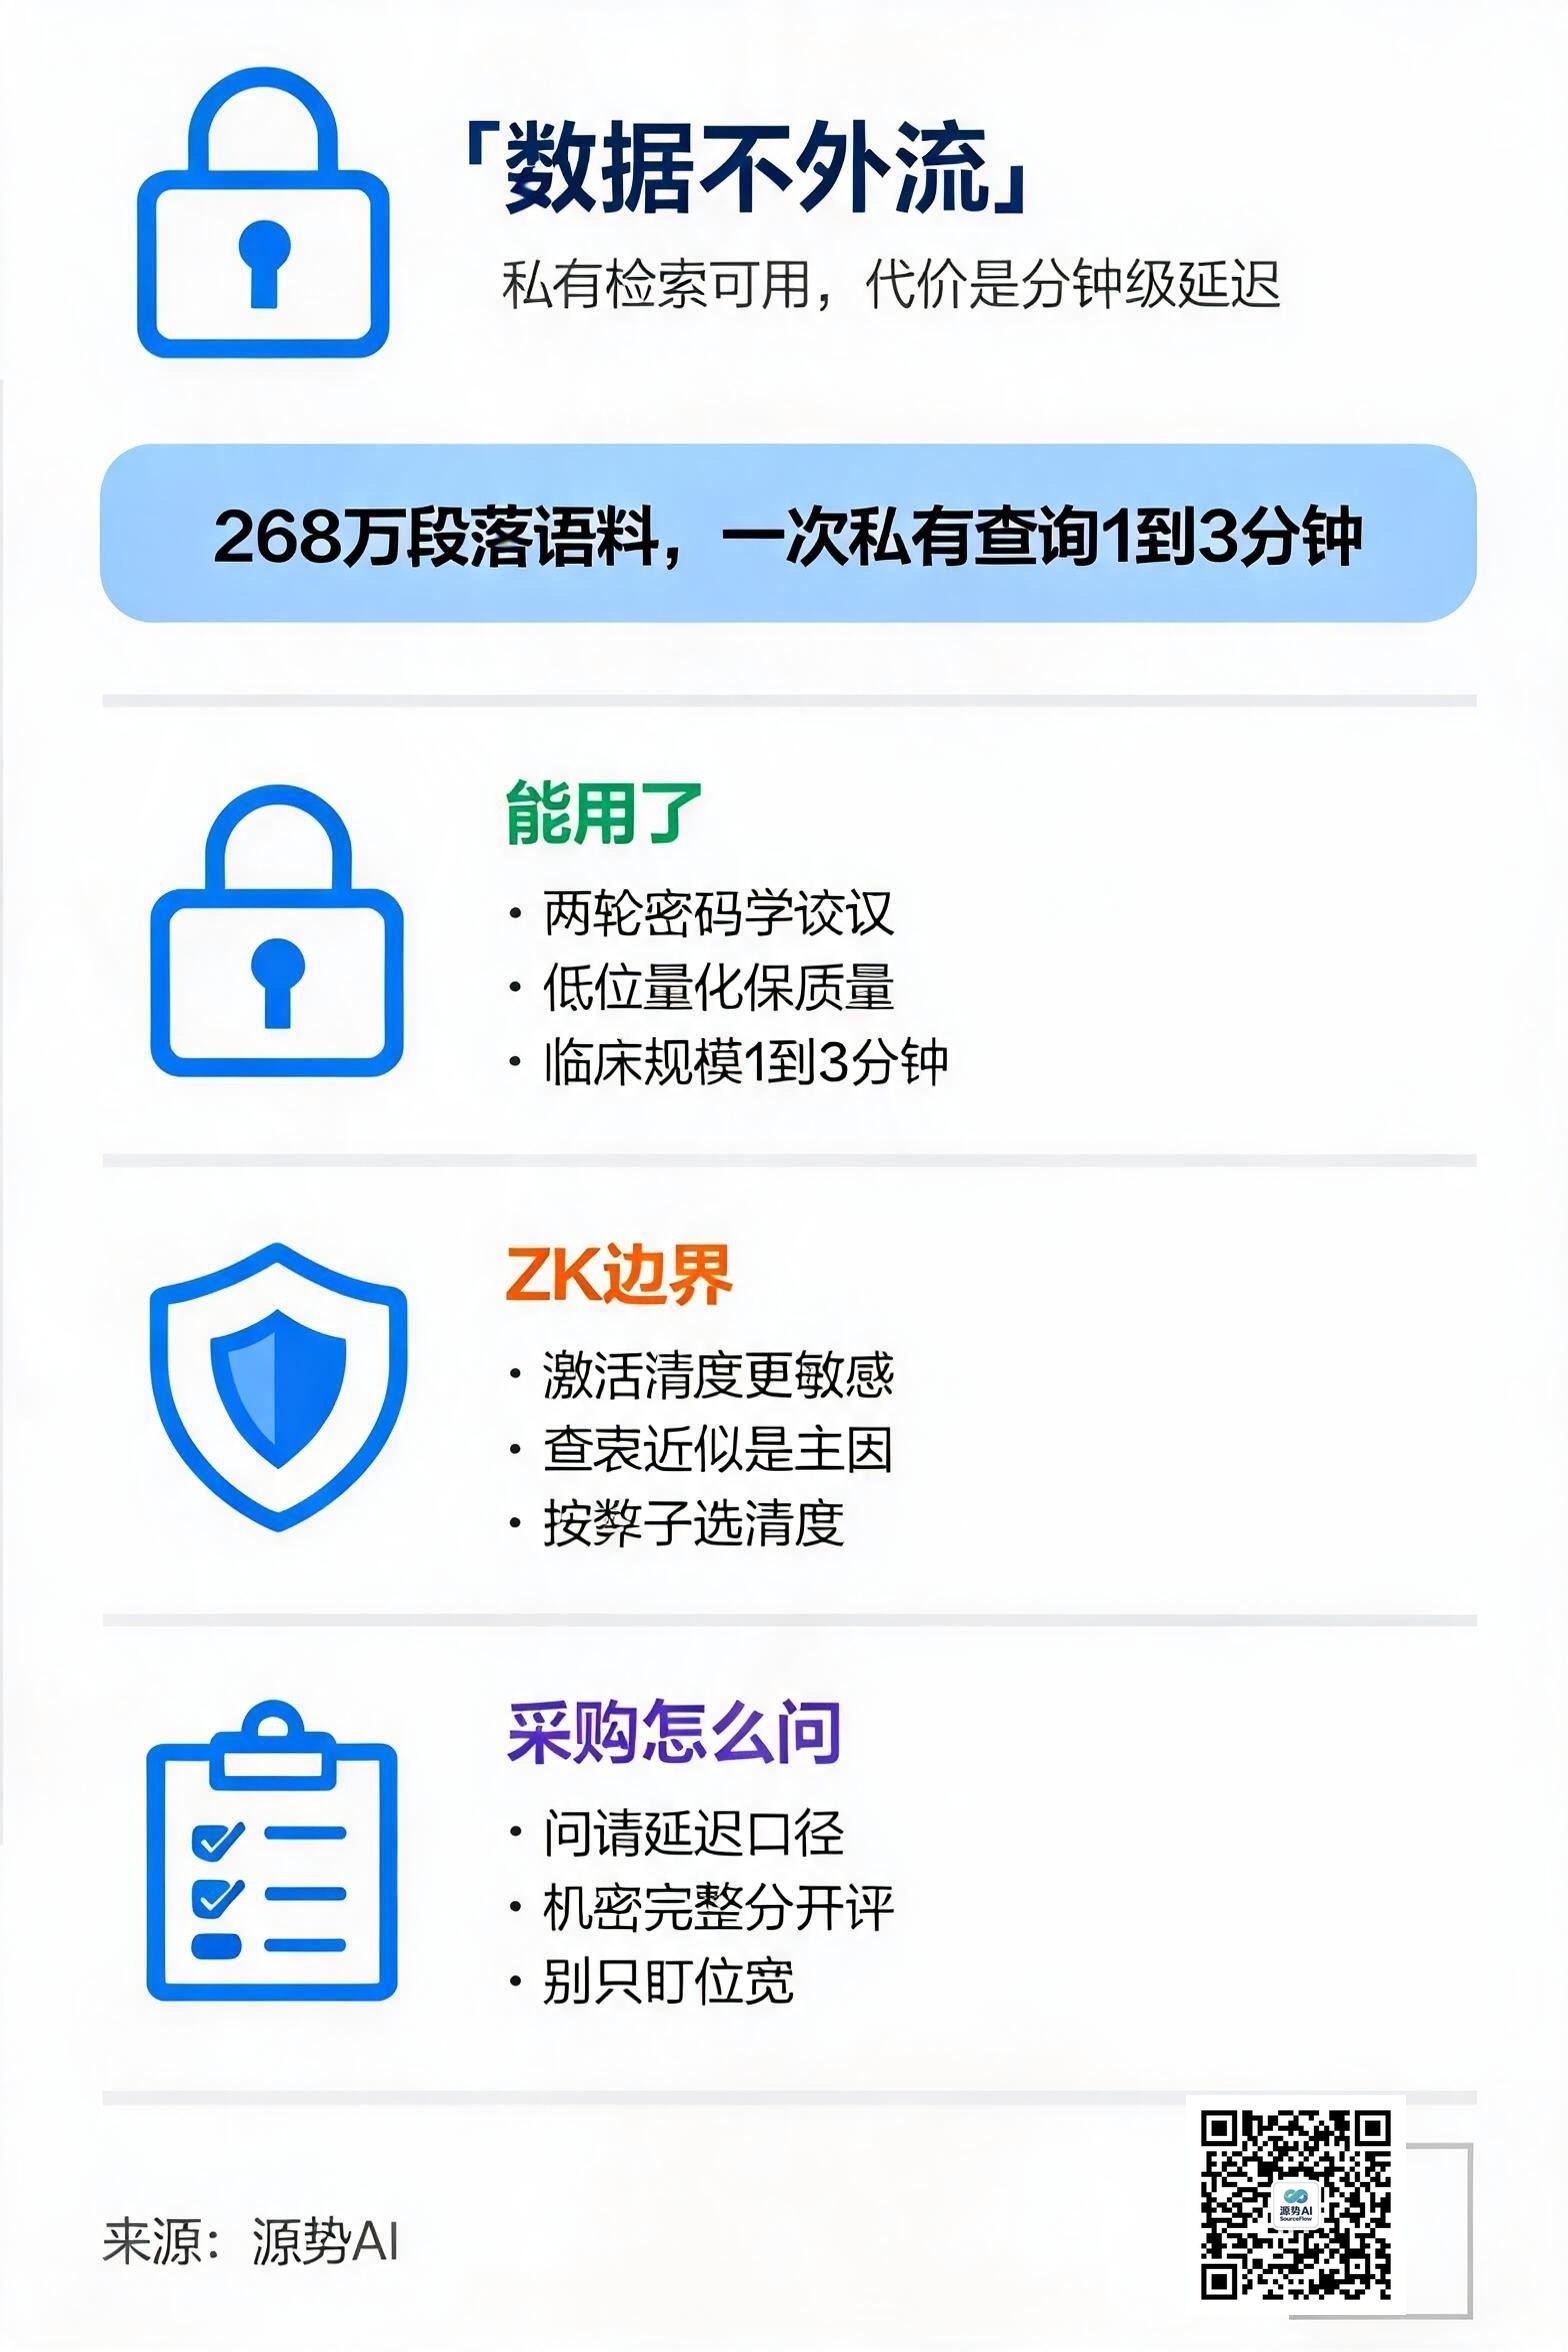
蒙特利尔高等技术学院与 Mila 等机构的研究,把私有稠密检索定义成两个目标——查询隐私,加上对抗恶意服务端的检索完整性——并提出一个两轮密码学协议同时满足两者:把私有且可验证的检索归约为"承诺矩阵 × 加密向量"的乘法,再用低位量化把这个计算压到可实用的量级(来源:《量化让稠密检索可抵御恶意服务端》,arXiv:2609.36376)。
评测覆盖 6 个嵌入模型、4 个语言模型、最大 268 万段落的语料(来源:《量化让稠密检索可抵御恶意服务端》,arXiv:2609.36376)。在裁剪量化器下,3-bit 量化基本保持了检索质量与下游 RAG 准确率;一次针对临床规模语料的私有查询,需要 1 到 3 分钟的服务器时间。
结论的关键不在"理论上可行",而在有明确的语料规模与延迟边界。分钟级延迟可接受时,私有稠密检索对中等规模的隐私敏感语料已经能用了。
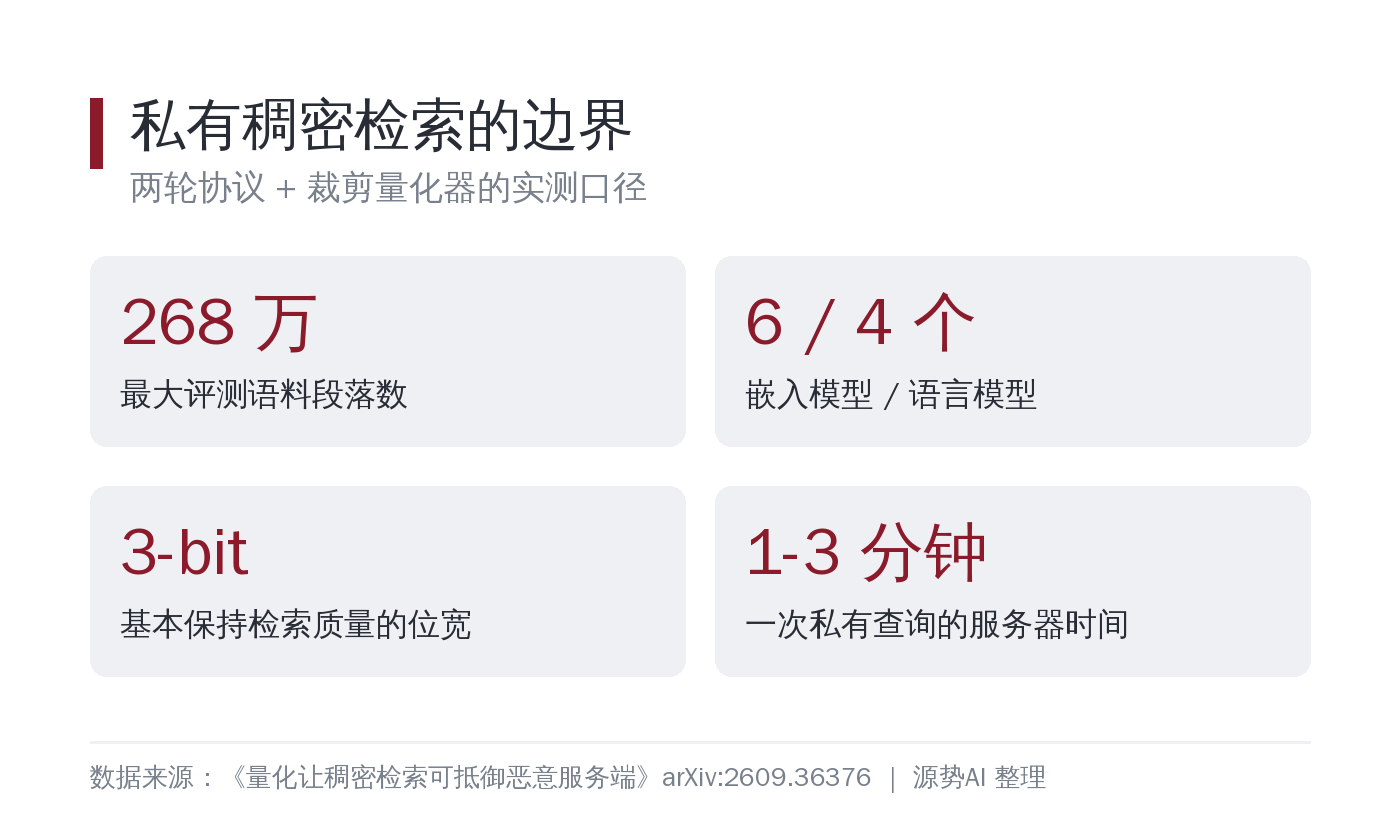
图注:3-bit 量化基本不损检索质量,代价落在查询延迟上;分钟级是这个方案当前的分界线
低位量化那套,在 ZK 里不灵
另一条线要解决的是"可验证":让监管方、用户、审计方验证模型的训练数据使用与推理行为,同时不暴露模型参数——零知识证明。
伊利诺伊大学厄巴纳-香槟分校的团队首次给出了 ZK 友好量化的形式化定义,并在 9 个模型上系统扫描权重、激活与非线性查表的精度设计空间。结论有点反直觉:激活精度远比权重精度敏感;非线性查表近似是效用退化的主要来源;RMSNorm 的平方根倒数查表在多个大模型上反复成为瓶颈,只在这一个算子上提高精度,就能恢复接近基线的效用(来源:《ZK-LLM 下的比特:零知识友好量化系统评测》,arXiv:2609.36437)。
还有一条更实际的发现:降低位宽或查表规模,并不带来成比例的端到端证明开销节省。传统低位量化的经验不能直接搬到 ZK 场景,得按算子选精度,而不是按"位宽越低越省"办事。
补上完整性和外包推理两块
同期的另外两篇把拼图补齐了。
一篇处理 RAG 查询本身的泄露面:通过扫描提示分布来识别哪些查询会带出敏感内容,在检索入口加一道闸门,而不是等答案生成完再过滤(来源:《给 RAG 的隐私泄露装一道查询闸门》,arXiv:2609.16095)。
另一篇处理算力外包:模型跑在不可信的 GPU 上时,用差分隐私把推理过程中外泄的信息压住。这意味着"把推理租出去"和"数据不泄露"之间的取舍,有了可量化的参数,不再是二选一(来源:《用差分隐私把 LLM 推理外包给不可信 GPU》,arXiv:2609.15039)。
四篇放在一起看,方向是一致的:隐私保护正在从"加密之后不能用",变成"慢一点但可用"。
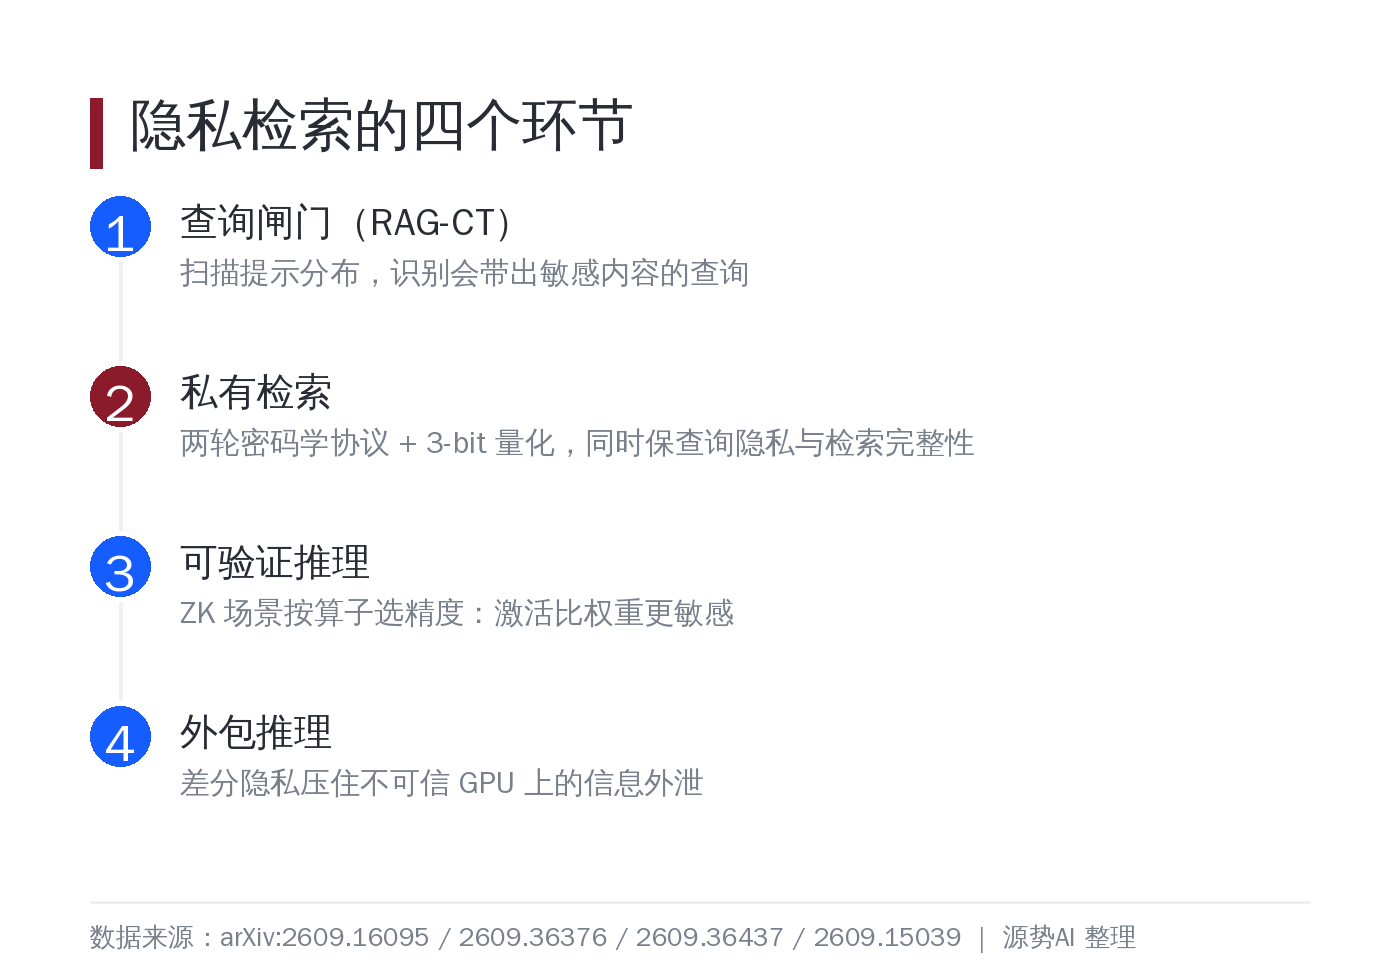
图注:查询闸门、私有检索、可验证推理、外包推理加密,四个环节各自有了可量化的边界
落到采购上怎么用
三条能直接用的判断。
第一,问清延迟口径。"私有检索已经可用"这句话本身没有信息量,要问的是在多少段落规模下、延迟几分钟、用几位量化。论文给出的参照是 268 万段落、1 到 3 分钟、3-bit(来源:《量化让稠密检索可抵御恶意服务端》,arXiv:2609.36376)。
第二,把合规需求拆成"机密"和"完整"两项分别评估。市场方案大多只解决机密性——数据不泄露;服务端能不能篡改检索结果、能不能选择性返回证据,是另一件事,很多产品没有答案。
第三,别用"位宽"当唯一成本旋钮。ZK 场景已经证明,降位宽不一定省证明开销,选错了算子反而白白丢精度。这类参数要按算子的敏感度来配。
源势AI观点
我们的判断是,隐私预算会变成企业采购 AI 的常规科目,而不是合规部门的专项。
在金融和医疗这两条线上,客户最先问的已经不是"模型效果怎么样",而是"数据出不出域、出了域还能不能控"。过去这个问题的答案只有两个极端:全私有化部署,成本高到做不动;或者接受数据外流,合规过不了。现在中间地带出现了——私有检索、可验证推理、差分隐私外包,各自都有明确的延迟和规模边界。
给客户做方案时,我们的做法是把隐私成本写成一张表:每种保护手段对应多少延迟、多少算力、覆盖哪一类风险。表列出来,业务方自己就能选,不需要在"要不要上 AI"这件事上反复拉扯。
还有一条要提前想清楚:保护手段只解决技术层面的泄露,不解决"查询本身透露了什么"。查询闸门这类工作正在补这一块,但它要求企业先知道自己有哪些字段是不能被反推的。这件事得业务侧给出定义,技术补不了。
话题标签:#隐私计算 #私有检索 #零知识证明
