
图注:一图读懂本文要点——八种记忆方案层层叠加,企业按五个档位选型(来源:源势AI)
给 Agent 接一个向量数据库,很多人以为它就「有记忆」了。真去搭过一套长期记忆系统才知道,这个问题比想象中麻烦得多。
原因在于,「记忆」两个字底下压着一堆不同的子问题:什么该留在当前对话里、什么该被忘掉、什么该压缩、哪些信息值得长期保存、保存了之后什么时候该翻出来(来源:智能体AI《Agent 记忆到底怎么做?一文讲透 8 种 Memory 策略,从窗口到 Memory OS》,2026-10-02)。
向量数据库只回答了其中一小部分。
底层事实:模型没有记忆
先说一个容易被忽略的前提:模型每次推理,看到的只有这一次输入的上下文。没有中间态,没有隐藏的意识流。所以所有 Agent Memory 要解决的,本质上是同一件事——怎么把过去有价值的信息,在合适的时间点,用合适的形式,重新塞回上下文里(来源:智能体AI,2026-10-02)。
围绕这件事,业界大概走出了八条路。前四条管「节流」,后四条管「建结构」。
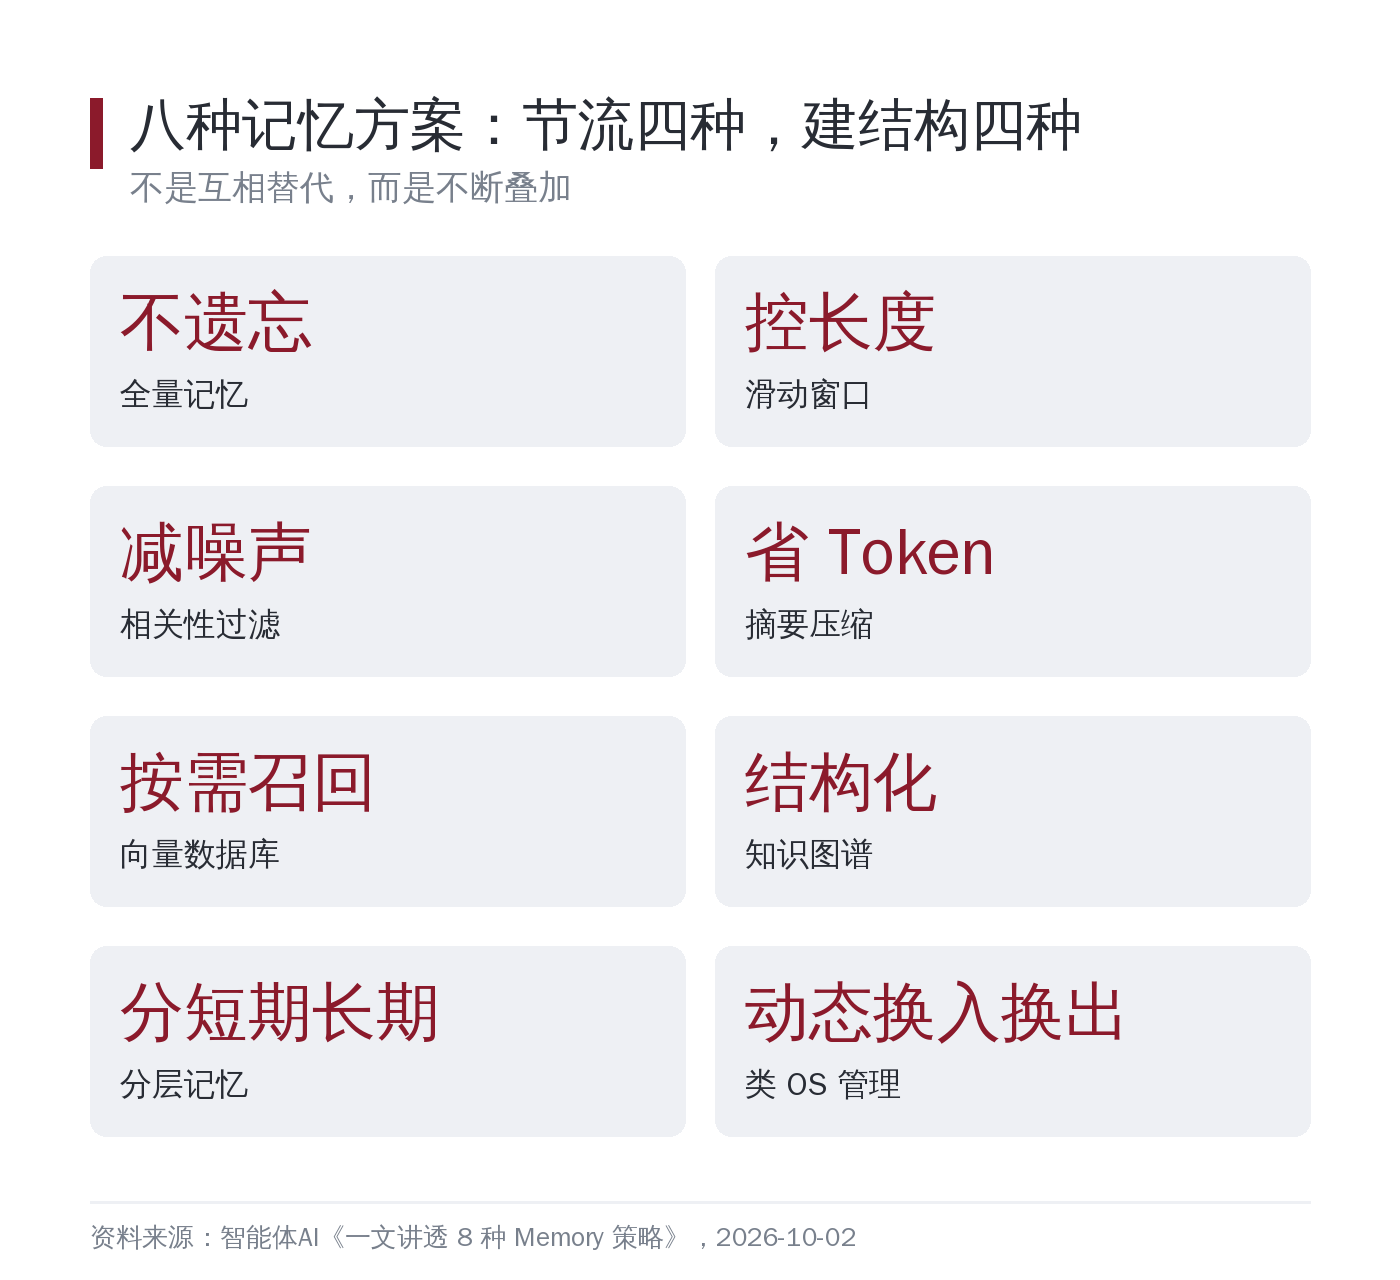
图注:前四种管「留什么、忘什么、怎么压缩」,后四种管「怎么建结构、怎么按需取回」——它们不是互相替代,而是不断叠加(资料来源:智能体AI《一文讲透 8 种 Memory 策略》,2026-10-02)
节流的四种是从朴素到聪明排下来的:全量记忆把所有历史原样保留,好处是零信息损失,代价是很快撞到上下文窗口的天花板;滑动窗口只留最近 N 轮,长度可控但只认时间戳、不懂重要与否;相关性过滤给每条记忆打分,从「时间驱动的遗忘」变成「价值驱动的遗忘」,风险是判错一次就会悄悄失忆;摘要压缩用 LLM 把长对话压成短摘要,省 Token 但必然丢细节(来源:智能体AI,2026-10-02)。
这四种有一个共同短板:一旦某条记忆不在当前上下文里,就彻底找不回来了。
后四种,在重建结构
于是有了把记忆存起来、需要时再取的路子。
向量数据库是最常见的一种。但这里有个误解要先澄清:它解决的不是「记忆」本身,而是「长期记忆的存取方式」。内容转成 Embedding 存进去,用当前问题做语义检索,取 Top-K 塞回上下文。问题在于背后的细节——Embedding 准不准、文本怎么切块、Top-K 取多少、召回是否完整,每一项都会影响效果,调优的工作量往往比接入本身大得多(来源:智能体AI,2026-10-02)。
这里还有一条容易被混淆的边界。老贾探AI 的一篇梳理把「压缩」和「记忆」切开:压缩作用在窗口内部,记忆作用在窗口与持久层之间,两件事的接口顺序不能反——先落盘,再压缩(来源:老贾探AI《Agent上下文压缩与记忆策略》,2026-09-27)。顺序有实际后果:Anthropic 把上下文编辑和记忆工具设计成必须配对使用,编辑负责把上下文变小,记忆工具负责给被擦掉的内容留一条后路。按其梳理,在网页检索类评测里,单做上下文编辑就能大幅压低 token 消耗;把记忆工具一起用上,正向提升更明显——两者本就是设计成配对使用的(来源:老贾探AI《Agent上下文压缩与记忆策略》,2026-09-27)。很多团队买了「记忆系统」之后第一件事是把历史对话全量塞进去、每次提问召回 Top-K——那其实是在做 RAG,不是记忆。
知识图谱更进一步,把记忆结构化成图和关系。向量检索擅长回答「这段文字像不像」,不太擅长表达复杂关系;图谱存的是「张三是项目负责人、项目 A 属于公司 B」这类结构,适合关系密集的场景,但构建复杂、维护麻烦。
再往上,是分层记忆:短期用滑动窗口,长期用向量库或图谱,按需组合,一起送进 LLM。这一步的意义是系统第一次具备「按性质分区存放」的意识(来源:智能体AI,2026-10-02)。
最顶层是类操作系统的内存管理。Context Window 类比 RAM,长期记忆库类比 Disk,Memory Manager 负责在两者之间换入换出。走到这一步,记忆已经不再是一个数据库问题,而是一个资源管理问题。MemGPT(后来的 Letta)是最早把「记忆即操作系统」这个想法系统化的论文(来源:智能体AI,2026-10-02)。
存得多,不等于记得住
这条演进路线有现成的产业注脚。
华为 9 月把智算集群的记忆存储推到了 PB 级:CMS 记忆存储方案构建 PB 级记忆空间,支持 TB 级记忆高速读取(来源:Tech Digest《AI行业24小时_20261001_10》,2026-10-01)。
硬件把容量堆上去的同时,算法侧在说另一件事。长程任务最朴素的解法是把每一轮的思考、动作、观察都拼进上下文,代价是推理成本与显存随长度上升,超出训练长度后输入落进分布外,冗余内容还会稀释注意力(来源:《强化学习驱动的 LLM 智能体记忆管理:六篇论文对比》,转引自源势AI,2026-10-01)。
研究里有个很直观的例子:用户先说「领养了一只叫 Buddy 的狗」,又说「又领养了一只叫 Scout 的狗」,未经学习的记忆系统会把后者误判为矛盾,用删除加新增把原记忆覆盖掉;学习过的系统会发一条更新,把事实合并成「领养了两只狗」(来源:《强化学习驱动的 LLM 智能体记忆管理:六篇论文对比》,2026-09-09)。
记什么、改什么、丢什么,本身是个决策问题,写更复杂的 system prompt 解决不了。
企业选型,其实是分五个档
落到实际工程上,可以按复杂度把需求分成五档(来源:智能体AI,2026-10-02):
简单 Chatbot 用全量记忆或滑动窗口就够;长对话 Agent 需要滑动窗口加摘要压缩,先把上下文长度控制住;知识型 Agent 在此之上接入向量数据库,开始有长期记忆;复杂企业 Agent 把短期记忆、摘要、向量库、知识图谱叠起来做分层管理;长期运行 Agent 再加一层 Memory Manager,负责写入、召回、压缩、淘汰、换入换出、优先级排序这一整套调度逻辑。
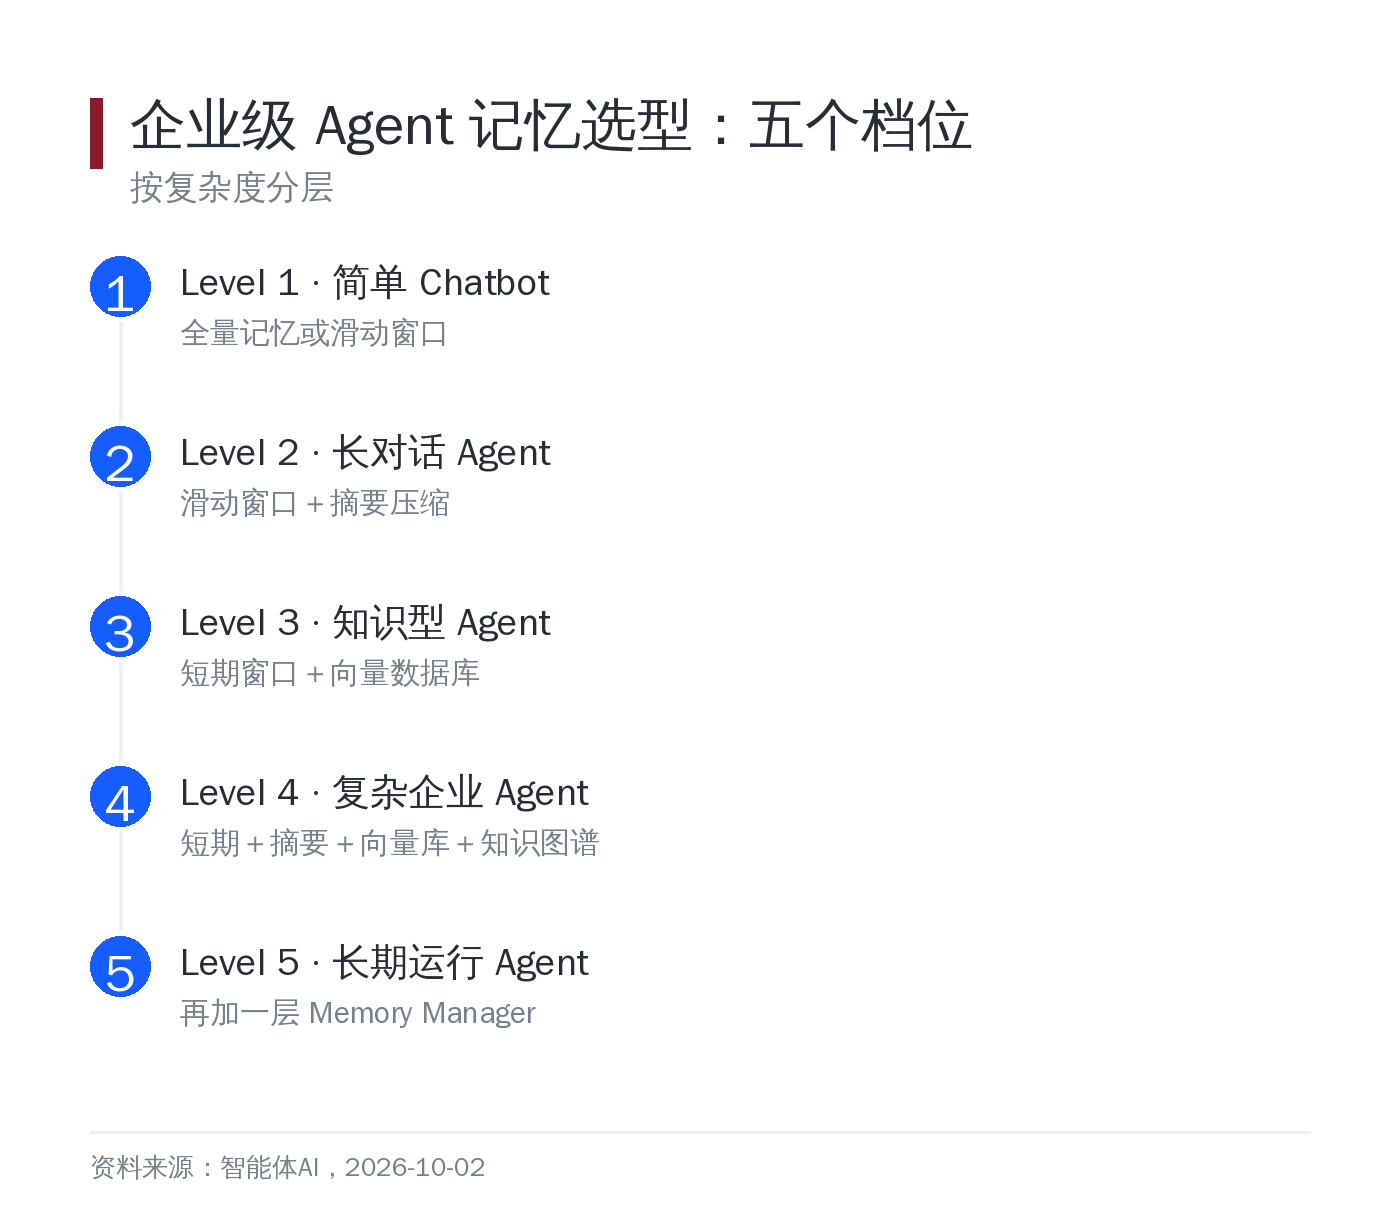
图注:从 Level 1 的简单 Chatbot 到 Level 5 的长期运行 Agent,差别不在数据库,而在要不要一层 Memory Manager(资料来源:智能体AI,2026-10-02)
这套分档的价值在于:它把「要不要上记忆系统」变成了「你处在哪一档」。
源势AI观点
第一,把「压缩」和「记忆」当两件事设计,顺序别搞反。压缩作用在窗口内部,记忆作用在窗口与持久层之间,要先落盘再压缩。给客户做落地时,我们见过不少团队先上压缩、后补存储,结果是被擦掉的内容再也找不回来。
第二,先把任务类型量清楚,再谈选型。「单次请求内多轮」和「跨多次会话长期运行」对应的技术完全不同:前者管的是工作上下文,后者管的是长期记忆。很多项目一上来就买向量库,其实是给第一类任务上了第二类的方案。
第三,预算按「每轮固定成本」编,而不是按「总算力」编。定长状态的意义是让每步代价与总长度脱钩,这在多轮任务里省下的通常是数量级。硬件给容量是好事,但真正的成本在取舍规则上——什么时候覆盖、什么时候合并、什么时候该丢,这套规则要跟着业务定义,抄不来。
记忆从来不是「把历史存起来」,而是怎么管理一块有限的认知空间。接一个数据库解决不了这件事。
话题标签:#智能体记忆 #上下文工程 #Agent架构
