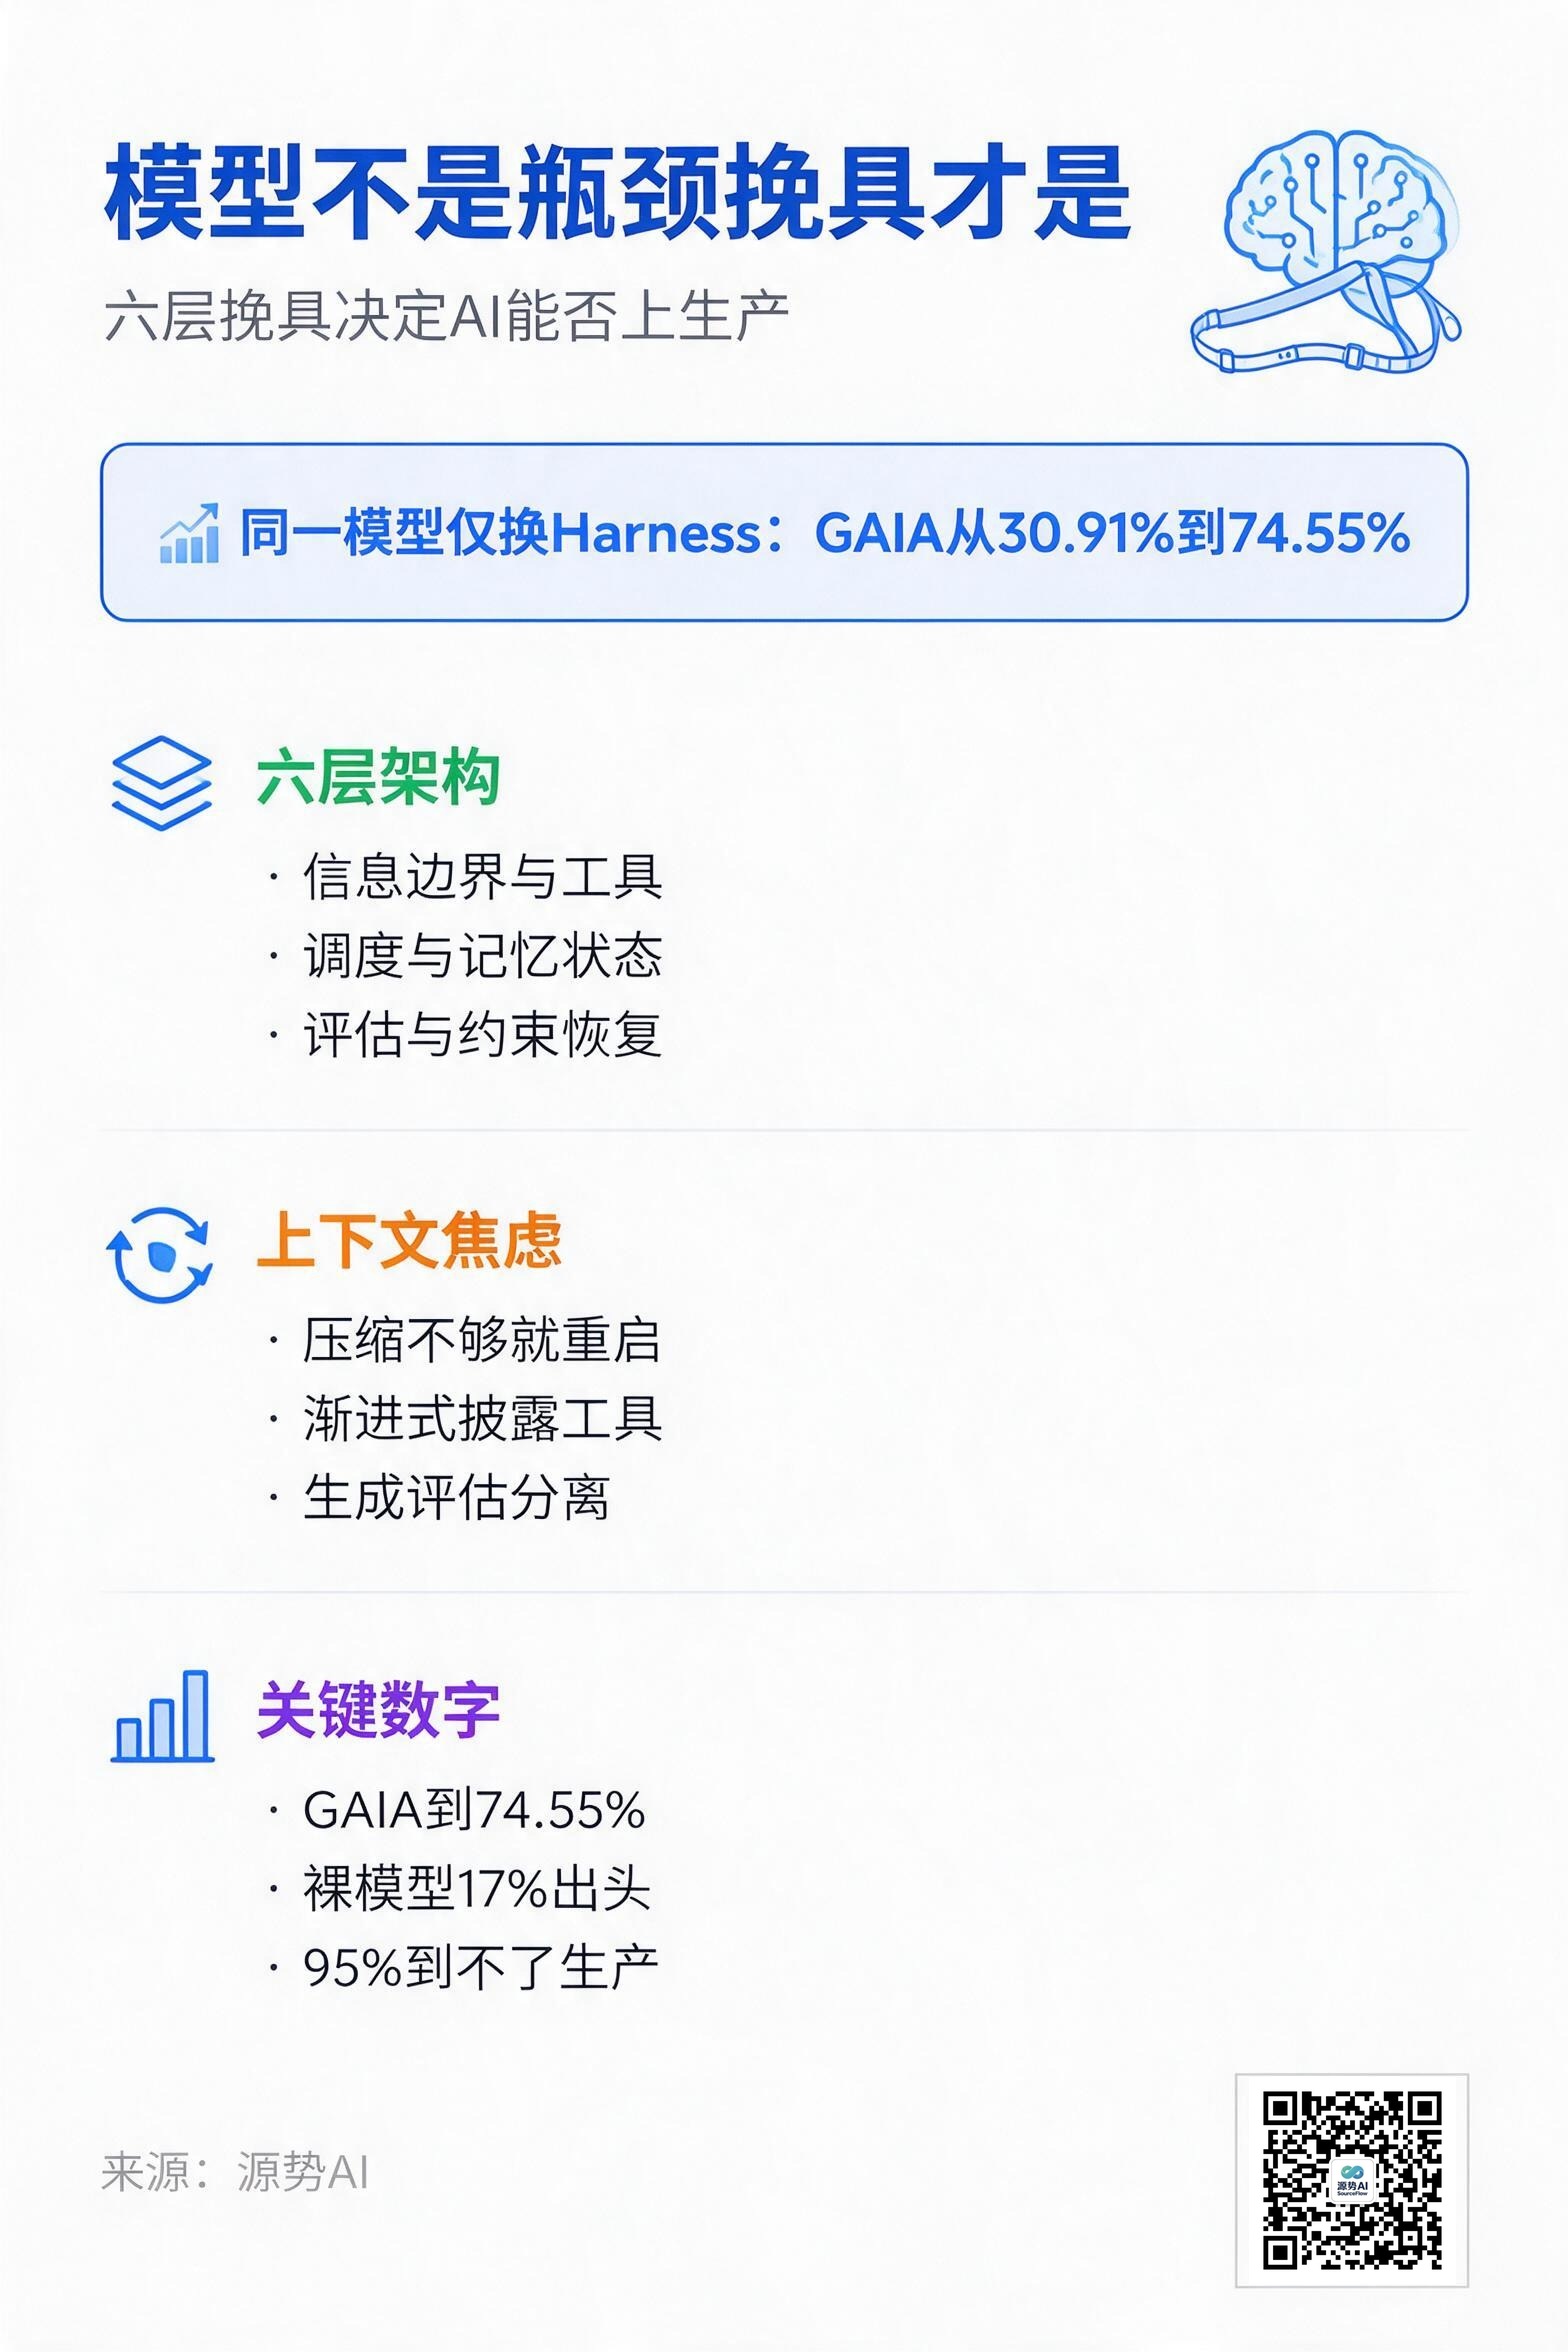
图注:一图读懂本文要点——模型不是瓶颈,六层挽具决定 AI 能否上生产(来源:源势AI)
为什么最聪明的模型,一到生产环境就崩溃?
答案往往不在模型本身,而在缺少一套可靠的控制机制。围绕模型搭的这套支撑体系,行业给了它一个名字:Harness,中文常译作挽具、驾驭工程(来源:忽南忽北Wq《深入探究Harness Engineering:如何设计出生产级别的Agent》,2026-09-30)。
模型的能力决定排行榜上的理论分数,但它在真实任务里的表现,更多取决于这套外在系统稳不稳。
从提示词到挽具,走了三个阶段
LLM 应用的演进大致分三段。
第一阶段是提示词工程,关心的是「模型听懂我的意思了吗」。仔细设计角色说明、给几个示例、加格式约束,输出就可能明显不同。但提示词很快会遇到瓶颈:无论写得多好,都无法让模型知道它原本不知道的事,也无法让它记住几次工具调用之前发生了什么。
第二阶段是上下文工程,关心的是「模型掌握事实了吗」。RAG、动态检索、把工具输出传回模型、有策略地截断历史,都属于这一段。它确实带来突破,但解决不了一个问题:执行漂移。智能体先制定出色的计划、完美执行第一步,从第二步开始可能误解工具返回、偏离主线,却还能继续执行后面十几步,而系统毫无察觉(来源:忽南忽北Wq,2026-09-30)。
第三阶段才是 Harness 工程,关心的是「模型能持续正确地采取行动吗」。它的做法是围绕模型构建一套确定性的系统,用来监督模型的行动、捕捉失败、施加约束,在模型偏离轨道时把它拉回来(来源:同上)。
这个方向其实很新,是近一年才被单独拎出来讲的(来源:AI前沿笔记《谷歌发布 Harness Engineering 综述》,2026-09-11)。推动力很实际:Agent 进入长任务之后,工程师的时间并没有省下来,反而全花在搭记忆、调上下文、接工具、处理失败上。
六层架构,缺一层都会漏
成熟的 Harness 系统可以拆成六层(来源:忽南忽北Wq,2026-09-30)。
第一层是信息边界,回答「模型能看到什么」。多余的数据不会让模型更聪明,只会分散注意力,把系统规则、任务状态、外部证据混在一起,模型就可能漏掉约束。
第二层是工具系统,管的是「能用什么、何时用」。一个常见错误是装太多工具,导致模型编造不存在的参数、误用不熟悉的 API。还有一条不可妥协的规则:绝不把未经处理的工具输出直接传回模型——一次工具调用返回的几十条 JSON 记录,就足以污染上下文。
第三层是调度编排,把「先做什么、后做什么」从概率模型手里收回来,交给确定性的流程。
第四层是记忆与状态,让任务状态得以延续。这里最常见的错误,是把任务状态和对话历史混为一谈,导致上下文窗口不断膨胀、结构混乱。
第五层是评估与可观测性。初级 Agent 往往缺这一层:生成结果、宣布成功,却没有机制判断结果是否正确。让 Agent 自己评估验收并不可靠,相当于让运动员兼裁判员。
第六层是约束、验证与恢复,回答「出错后怎么办」。约束用硬编码规则规定绝对不能做什么,验证在输出前后设关卡,恢复提供重试逻辑和回滚路径。

图注:信息边界、工具系统、调度编排、记忆与状态、评估与可观测性、约束与恢复——Harness 可以看作 Agent 的操作系统,缺哪一层都会从哪一层漏(资料来源:忽南忽北Wq《深入探究Harness Engineering》,2026-09-30)
上下文焦虑,要靠重启
任务一长,前面搭的框架也可能失效,尤其是信息边界、记忆状态和评估这几层。
当上下文不断累积、接近上限时,模型会开始丢失重点、忘记核心目标、跳过验证,表现得像急着交差。Anthropic 的研究人员把这种状态叫上下文焦虑(来源:忽南忽北Wq,2026-09-30)。
最简单的办法是压缩上下文:总结历史、把摘要重新注入。但这只能减少 Token,不能真正重置模型的认知状态。更彻底的办法是重启——Anthropic 把它叫上下文重置,当上下文过大时,把压缩后的摘要交给一个全新的智能体实例,从更干净的上下文重新开始,就像处理内存泄漏时直接重启进程(来源:同上)。
工具也可以用渐进式披露:起初只给模型最少必要的工具,需要某项能力时再动态提供详细文档,避免信息过载。
把生成和评估分开
上下文干净了,不代表结果可靠。Agent 仍可能产出错误结果,或把未完成的工作误判为成功。
Anthropic 的实践是分离职责,设三个角色:规划器把人类需求转化为工程规格,生成器按规格执行,评估器独立验收输出,在功能上和生成器解耦。评估器不能只看生成器写出的代码,还要直接和渲染后的结果交互(来源:忽南忽北Wq,2026-09-30)。
OpenAI 又推进了一层:当 Agent 写代码快到人类来不及审核,他们为智能体搭了完全自动化的 CI/CD 流水线,Agent 在隔离沙盒里跑代码、用无头浏览器截图、读日志、迭代,直到确认部署正确。「完成」不再只是「我生成了文本」,而是「我跑了代码、查了日志、修了错误、验了部署」(来源:同上)。
数据也支持这条线。腾讯研究院在年度趋势报告里引用的实验显示:在 CL-bench 这类测试「现学现用」的基准上,即使把所有必要信息完整放进上下文,前沿模型的任务解决率也只有 17% 出头;ARC-AGI-3 换成交互式、不给说明书的开放式任务后,所有模型被打回到 1% 以下(来源:腾讯研究院《2026人工智能十大趋势报告》,转引自源势AI《模型越强,挽具越值钱》,2026-09-09)。
另一组对照更能说明问题:北京智源团队把「验证」从答案出口的事后过滤器,改造成研究轮次之间的控制信号,让一个 10B 激活参数的小模型在 BrowseComp 上拿到 82.5 分,超过了同家族 397B 激活参数的基线(来源:《验证驱动的递归自改进研究智能体》,2026-09-03)。小模型赢大模型,赢的不是智力,是挽具。
更直接的数据来自一份 2026 年的 Harness 工程综述:把模型钉死不动、只换 Harness,同一个 Claude Sonnet 4.5 在 GAIA 基准上从 30.91% 涨到 74.55%,提升 43.64 分,全部记在 Harness 账上(来源:AI前沿笔记《谷歌发布 Harness Engineering 综述》,2026-09-11)。同一份综述还给出一个刺眼的判断:绝大多数企业级 AI Agent 永远到不了生产环境。它们不是不会说话,是没人给它造这副挽具。
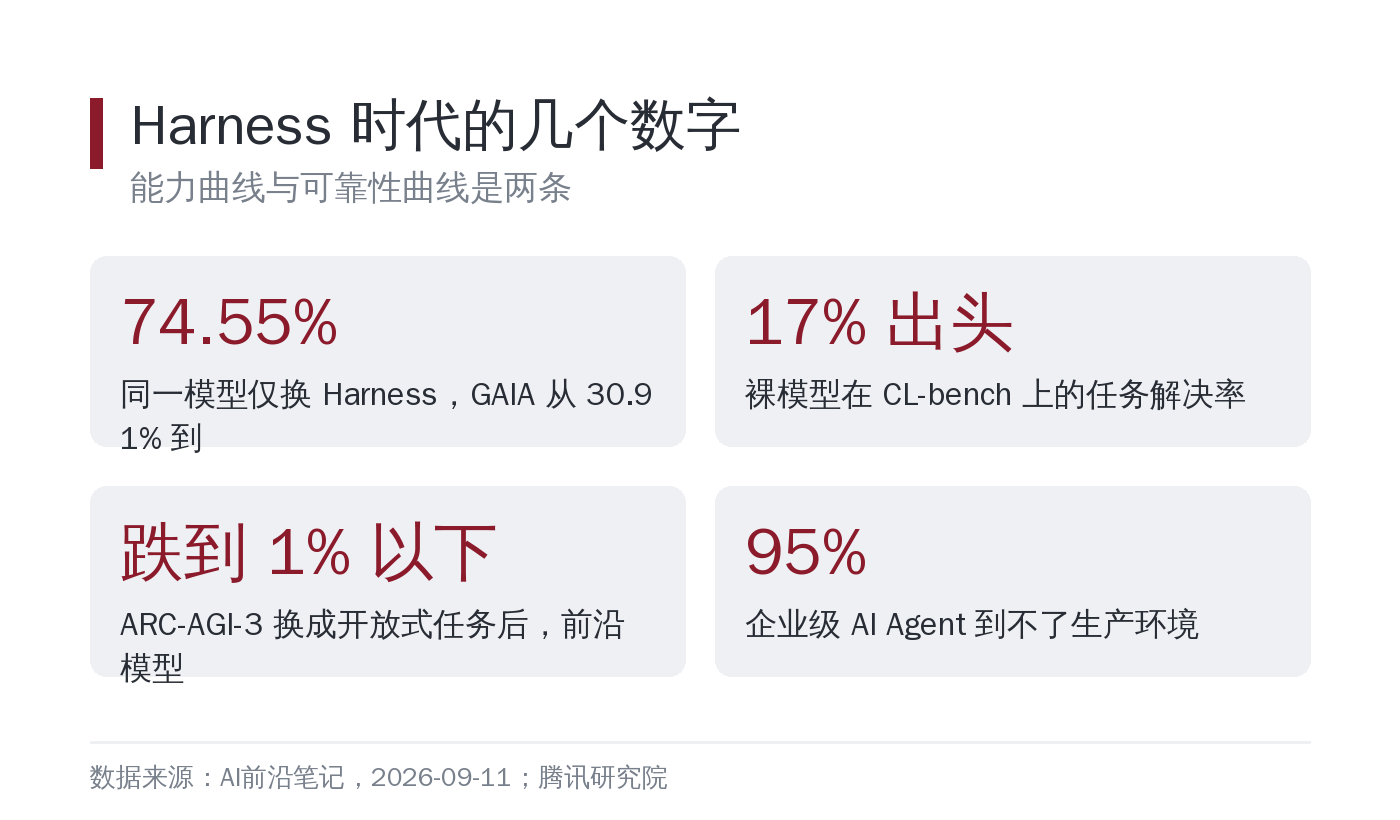
图注:同一个模型仅换 Harness,GAIA 从 30.91% 到 74.55%(数据来源:AI前沿笔记《谷歌发布 Harness Engineering 综述》,2026-09-11)
源势AI观点
第一,把「模型内部的问题」和「模型外部的问题」分开看。推理能力、知识密度交给模型迭代,那是基座厂商的战场;任务拆解、工具编排、结果验证、失败恢复属于工程交付,这才是企业级 Agent 落地真正要花钱的地方。
第二,采购 Agent 时,把 Harness 层的工程能力写进评估表。过去评估供应商看模型榜单,现在要看三样东西——运行环境搭得好不好、失败恢复做没做、验证信号闭不闭环。把任务成功率从六成提到九成的那一段差距,往往就藏在这一层(来源:忽南忽北Wq《深入探究Harness Engineering》,2026-09-30),订单里看不到,预算里也常被当成附赠。
第三,别指望换一个更大的模型解决问题。我们做企业智能体交付踩过的坑基本都在这一层——靠的通常不是模型升级,而是把上下文边界、权限审批、验收标准设计清楚。
行业还在大谈 Harness,恰恰说明它没有被模型内化完。等到显性的挽具沉进模型里,这一段工程能力会变成默认项;在那之前,它仍然是决定 AI 能不能上生产的那道坎。
话题标签:#Harness工程 #智能体落地 #AI工程
