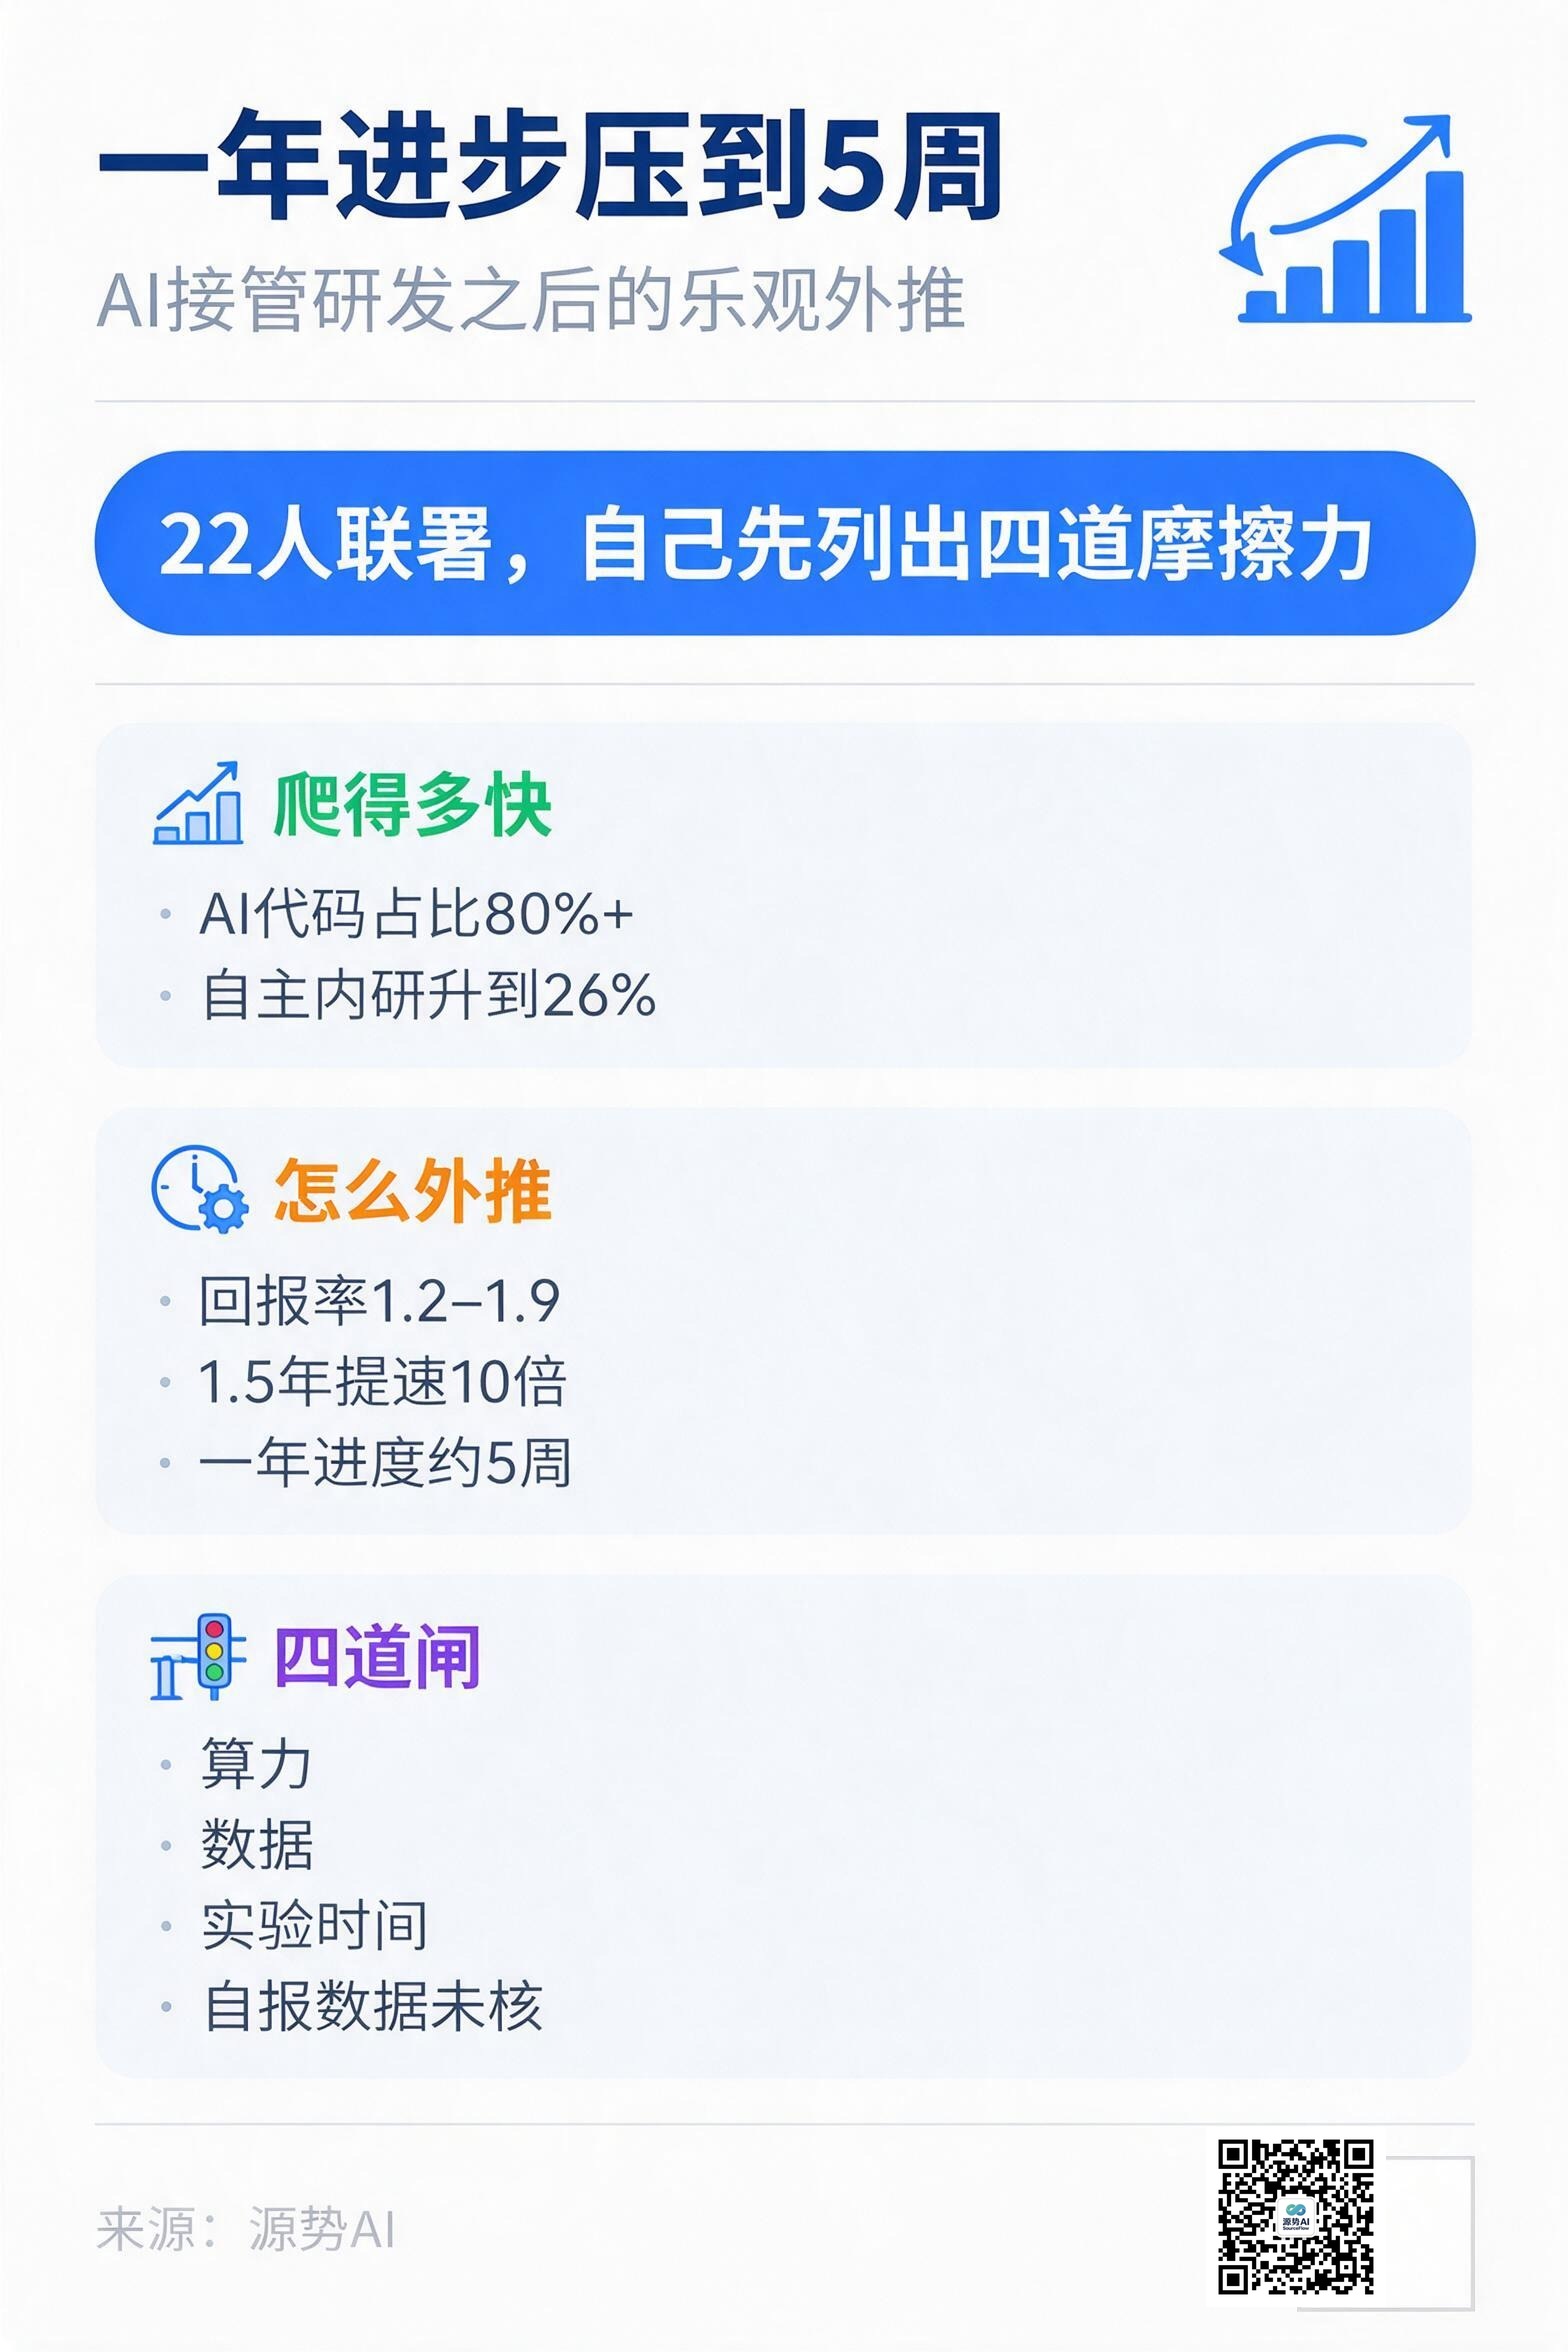
图注:一图读懂本文要点——AI 接管研发后,进步速度可能被压缩,但四道摩擦力还在(来源:源势AI)
10 月 3 日,Geoffrey Hinton 在 X 上转发了一篇论文,标题直接问:《What if automating AI R&D triggers an intelligence explosion?》(如果自动化 AI 研发触发了智能爆炸会怎样?)(来源:网易科技,2026-10-03,转引自 Tech Digest《AI行业24小时_20261006_10》)。
22 位作者联署,名单里有 Hinton、Yoshua Bengio、Andrew Barto,也有 OpenAI 首席科学家 Jakub Pachocki、微软首席科学官 Eric Horvitz、Anthropic 联合创始人 Jack Clark(来源:网易科技,转引自 Tech Digest《AI行业24小时_20261006_10》)。这不再是某个人在播客里的即兴判断,而是把"智能爆炸"第一次当正式课题写成论文。
论文最抓人的一句话是:在最乐观的参数下,今天要一年的进展,将来约要 5 周。
5 周是怎么算出来的
论文不是空转推演,用了几条内部数据做论据:AI 生成的获批代码占比,从 2025 年 1 月的低个位数,升到 2026 年 5 月的 80% 以上;Claude 在仅接受高层级人类监督时,自主完成的内部 AI 研发工作,从 2026 年 3 月的约 1%,升到 8 月的 26%(来源:网易科技,转引自 Tech Digest《AI行业24小时_20261006_10》)。
把这两个爬坡速度代入"研究回报率"——论文里的这个参数,衡量的是研发投入的产出倍数:投入一份人力与算力,能折算回多少研发能力,取历史估计 1.2 至 1.9,意味着一份投入换回约 1.2 到 1.9 份产出,是一段相对保守的区间——并假设算力与数据不先卡死,论文的外推结果是:AI 进步速度可能在大约 1.5 年内提高 10 倍,今天需要一年的进展,届时约需 5 周(来源:网易科技,转引自 Tech Digest《AI行业24小时_20261006_10》)。
一句话概括这条曲线:AI 不只在做研发任务,它开始把"怎么做研发"这件事本身也变成了可学习的对象。
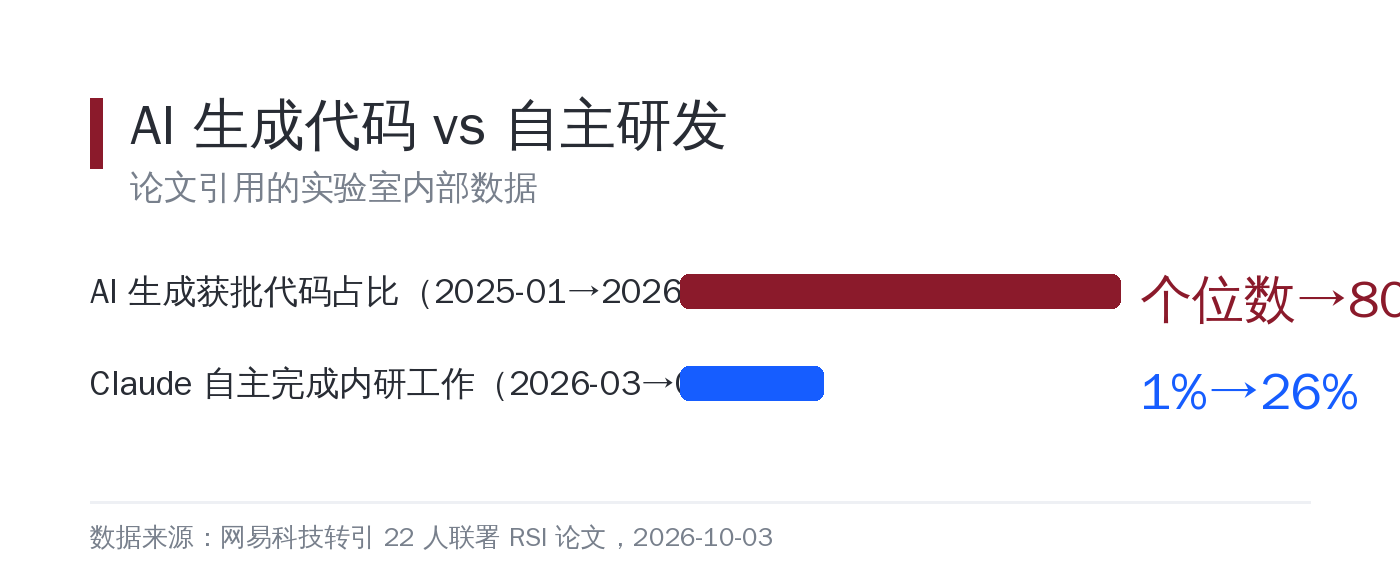
图注:两条曲线都是实验室内部口径——AI 生成获批代码占比半年多从个位数升到 80% 以上,Claude 自主完成的内研工作五个月从约 1% 升到 26%,均未获第三方复现(数据来源:网易科技,转引自 Tech Digest《AI行业24小时_20261006_10》)
论文自己列了四道摩擦力
如果只看到"5 周",就漏掉了这篇论文最克制的部分。
论文明确说,现有证据远不足以证明智能爆炸已经发生,并自己列出了算力、数据、实验时间等四道摩擦力(来源:网易科技,转引自 Tech Digest《AI行业24小时_20261006_10》)。换句话说,那张 5 周的图是"假设三道闸都开着"的情形,不是预测,论文也没有给出时间点(来源:网易科技,转引自 Tech Digest《AI行业24小时_20261006_10》)。
数据口径也得打个折:Anthropic 与 OpenAI 的内部数据是企业自报,无法独立核验(来源:网易科技,转引自 Tech Digest《AI行业24小时_20261006_10》)。
这恰恰是这篇论文的价值所在——提出"爆炸"假设的人,比旁观者更急着把刹车参数写清楚。
局部飞轮,比一场爆炸更像真实进程
把视角从"会不会爆炸"挪到"已经在发生什么",看到的是一串更小的、可验证的闭环。
Frontis-MA1 的论文做的是机器学习工程里的窄循环:AI 提方案、环境跑评测、成功与失败被整理成经验,经验再拿去训练下一轮的改进者。同一套搜索框架下,做过针对性后训练的 35B 模型,比基础模型高出 21.22 个百分点(来源:笔记《AI 的递归自我改进(RSI),可能先从许多局部飞轮开始》,2026-08-28,转引自 Frontis-MA1 论文)。
行业对 RSI 的分层也更清楚了。一份技术综述把它拆成三层:L1 只迭代产出物、模型和脚手架全冻结;L2 冻结权重、迭代提示词与工作流,是 2026 年产业界的主流;L3 才动权重和架构,只在数学、代码的小范围里做前沿实验(来源:笔记《RSI 核心技术与挑战深度分析》,2026-09-05)。越往下走,改动的东西越核心、越难回滚,这也是 L3 至今只在窄域里试探的原因。前 OpenAI 科学家翁荔则把话说得更直白:递归自我改进的主战场不在权重,在 Harness——那套包在模型外面的框架。
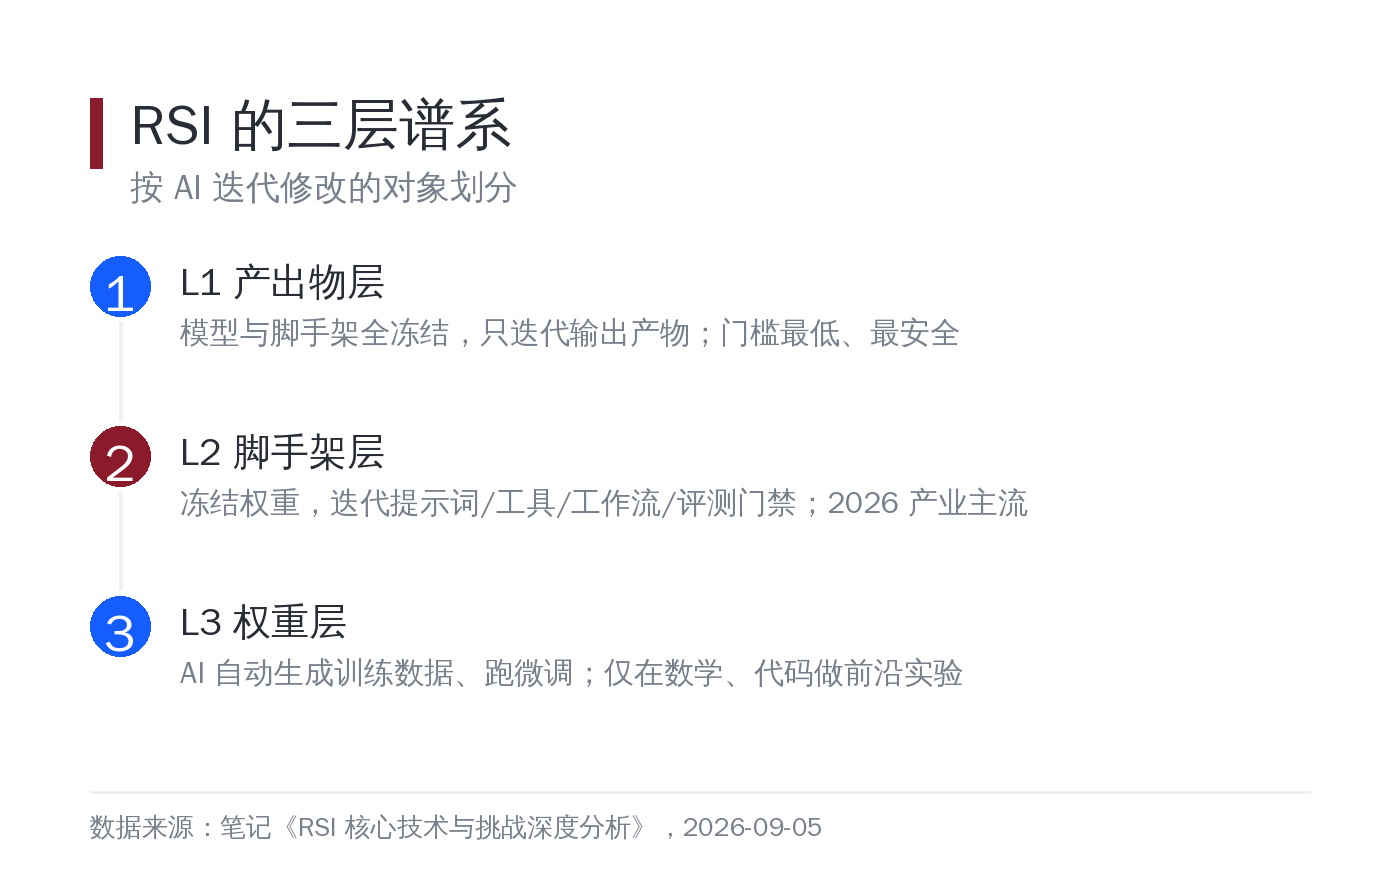
图注:RSI 按修改对象分三层——L1 产出物、L2 脚手架(当前产业主流)、L3 权重,越往下风险越高(数据来源:笔记《RSI 核心技术与挑战深度分析》,2026-09-05)
回头看,源势AI 在 8 月 23 日的文章里复盘过这件事,当时的结论是自我进化的故事讲得很响、兑现得很慢——那次实测里,机器自己重写造 AI 的说明书的活儿,只走完了不到两成的路。一个多月后,Hinton 们把同一件事写成了 22 人联署的论文,也把"兑现得慢"改成了"摩擦力有四道"。
源势AI观点
第一,把"5 周"当预测去下注是误读。它是特定参数下的外推,论文自己列了四道摩擦力,还承认自报数据无法核验。企业该关注的不是那个数字,而是"AI 正在越来越多地写生产代码"这条趋势线——它已经开始影响研发团队的排班和验收方式。
第二,真正在落地的 RSI 是 L2,不是 L3。当前能跑通的生产级改进,集中在提示词、工具定义、工作流、评测门禁这些脚手架层。这意味着投入的重点可以更务实:与其等着模型自己变强,不如先把自家 Agent 的失败轨迹采下来、把弱点聚类做起来——那才是"改进者"要吃的饲料。
第三,验证器是命脉,没有可靠验证器的团队做不了 RSI。代码和数学之所以最先跑通,是因为有编译器和证明检查器能自动判对错。哪个团队能把自己的业务做成"能自动判对错"的形态,哪个团队才真正拿到了自我改进的入场券。
话题标签:#递归自我改进 #智能爆炸 #AI研发
