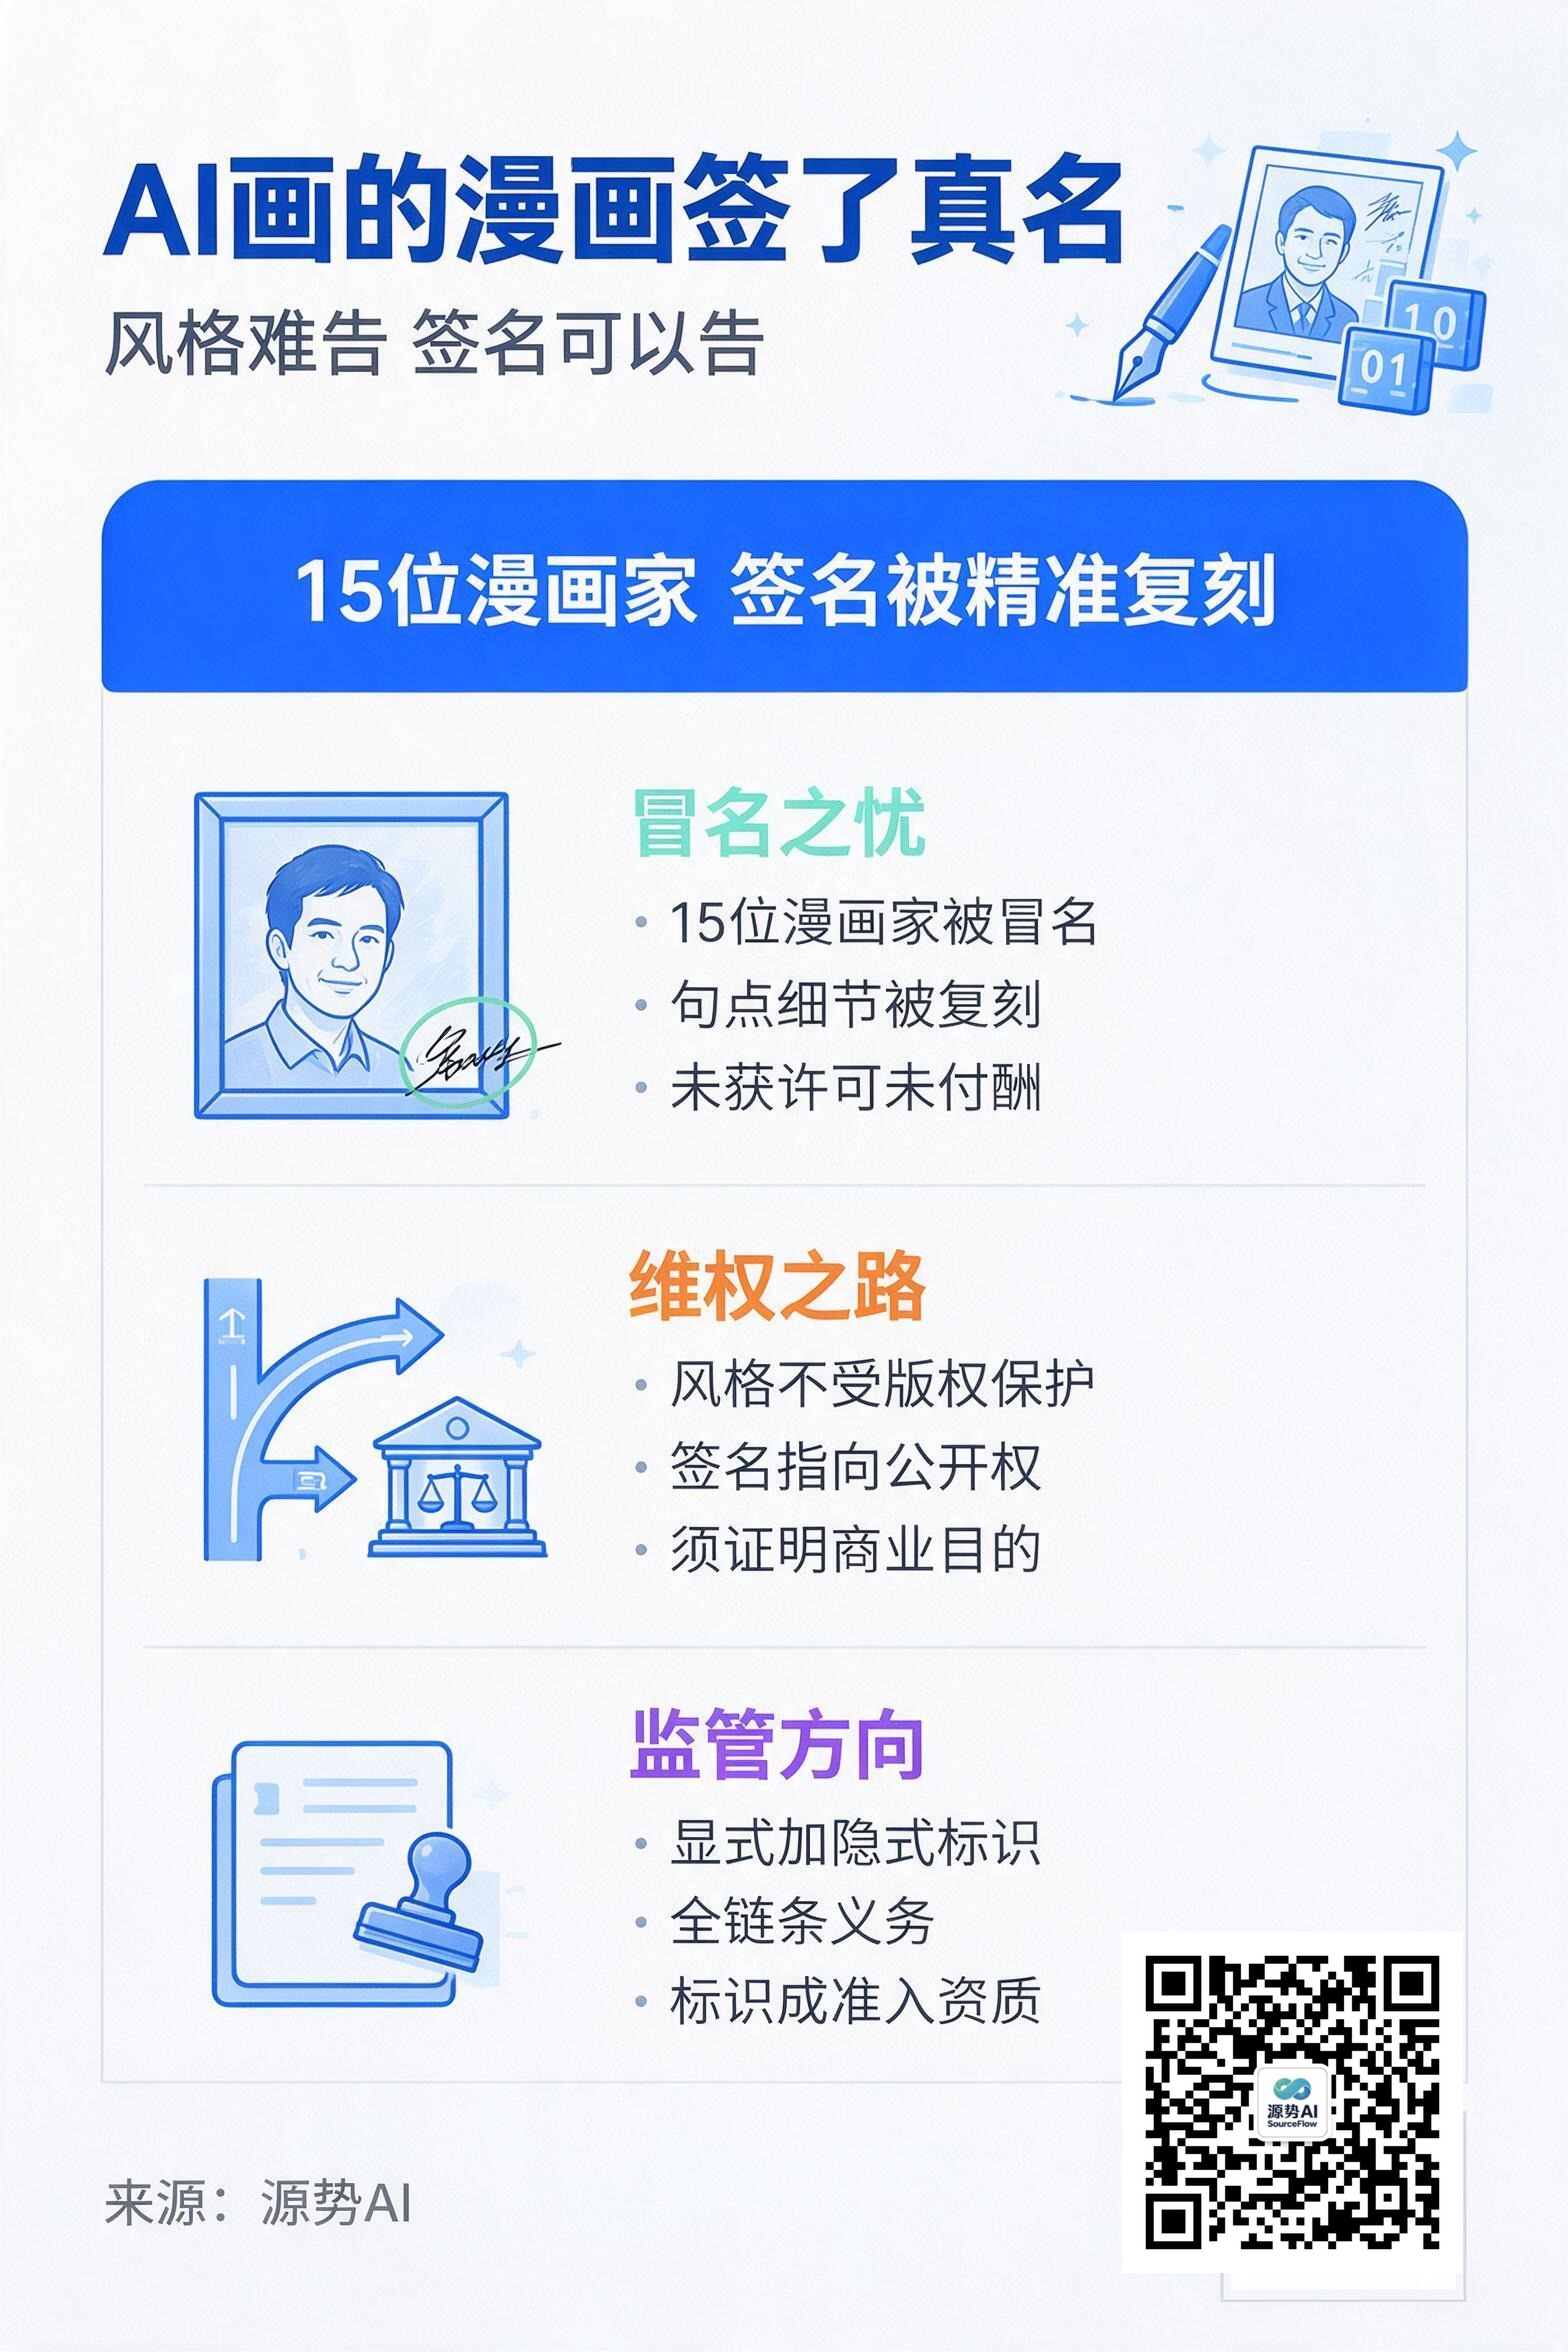
图注:一图读懂本文要点,AI 能连签名一起仿,但法律保护的边界不在风格上(来源:源势AI)
Nieman Lab 做了一组测试:OpenAI 的图像生成器在伪造的《纽约客》风格漫画上,签上了超过 15 位真实漫画家的名字,Harry Bliss、Emily Flake、Joe Dator、Pat Byrnes 都在其中,既没获得许可,也没付报酬;报道点名确认了这 4 位,受影响的漫画家总数超过 15 位(来源:Nieman Lab,2026-10,转引自 Tech Digest《AI行业24小时_20261007_10》)。
最扎眼的细节是签名。漫画家 Pat Byrnes 的签名习惯以句点收尾,十几张伪造漫画,每一张都精准复刻了这个句点(来源:Nieman Lab,转引自 Tech Digest《AI行业24小时_20261007_10》)。
画不是他们画的,风格是仿的,名字是真的。这件事把"模仿"和"冒名"分得很清楚。
为什么签名比画更难维权
康奈尔法学院教授 James Grimmelmann 的判断是:签名是一种"真实性的标记"(来源:Nieman Lab,转引自 Tech Digest《AI行业24小时_20261007_10》)。
签名的功能在于"这是我真的画的",好看不好看反而是次要的。当它被复制到一张不是本人所画的图上,损害的也不是某幅作品的复制权,而是署名这件事本身的可信度。
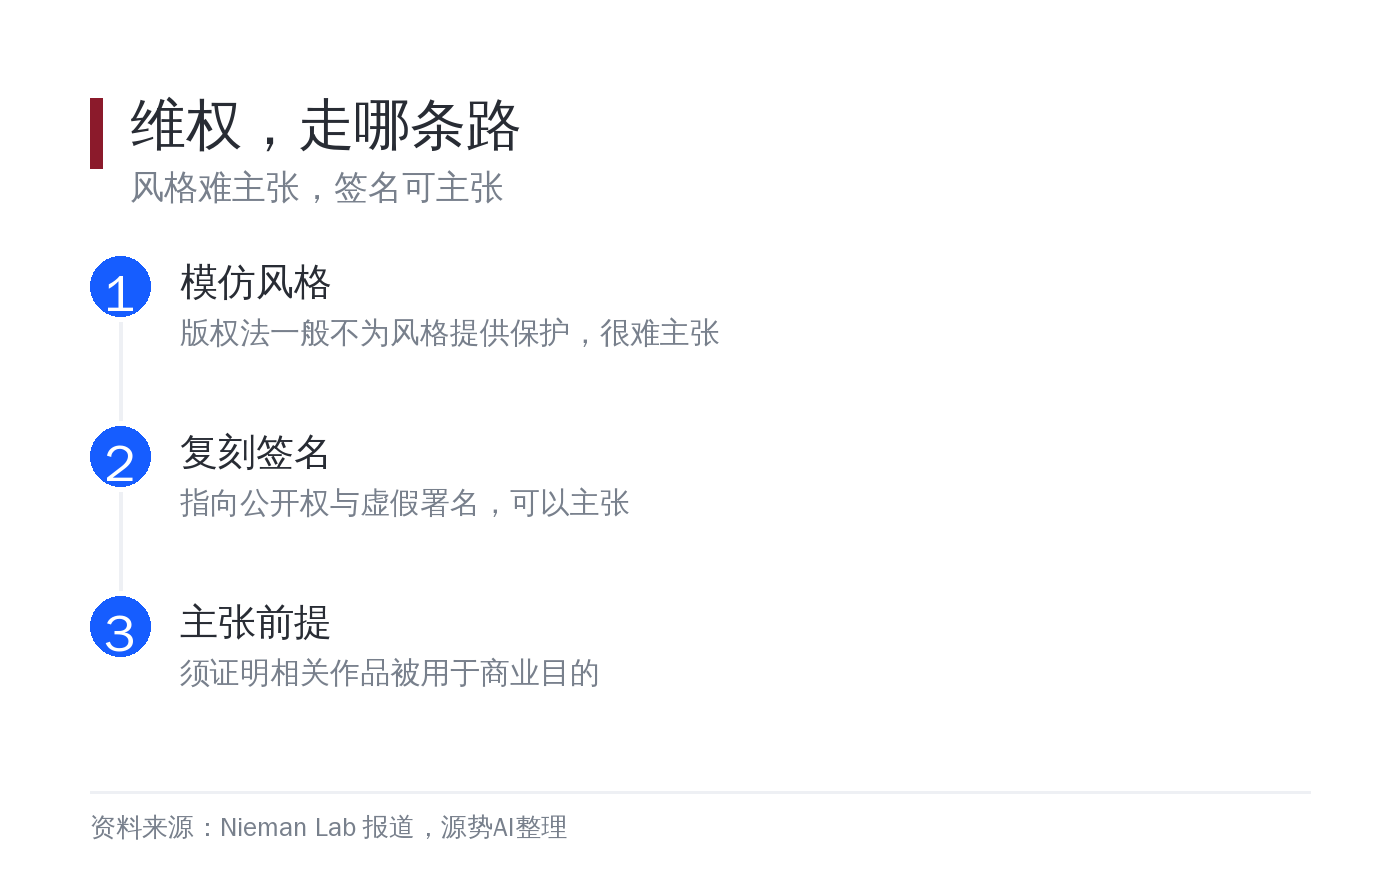
图注:风格模仿在版权法里通常不受保护,伪造签名指向的是另一条路径,公开权与虚假署名(来源:源势AI整理,法律观点来自 Nieman Lab 报道)
版权这条路的难点在于:模型通常不复制某一张具体作品,它模仿的是更通用的风格,而风格在版权法里一般不作为受保护对象(来源:Nieman Lab,转引自 Tech Digest《AI行业24小时_20261007_10》)。画得像《纽约客》的线条,很难告;签上真人的名字,性质就变了。
Grimmelmann 给出的现实路径是公开权(right of publicity)诉讼,前提是要证明这些漫画被用于商业目的(来源:Nieman Lab,转引自 Tech Digest《AI行业24小时_20261007_10》)。
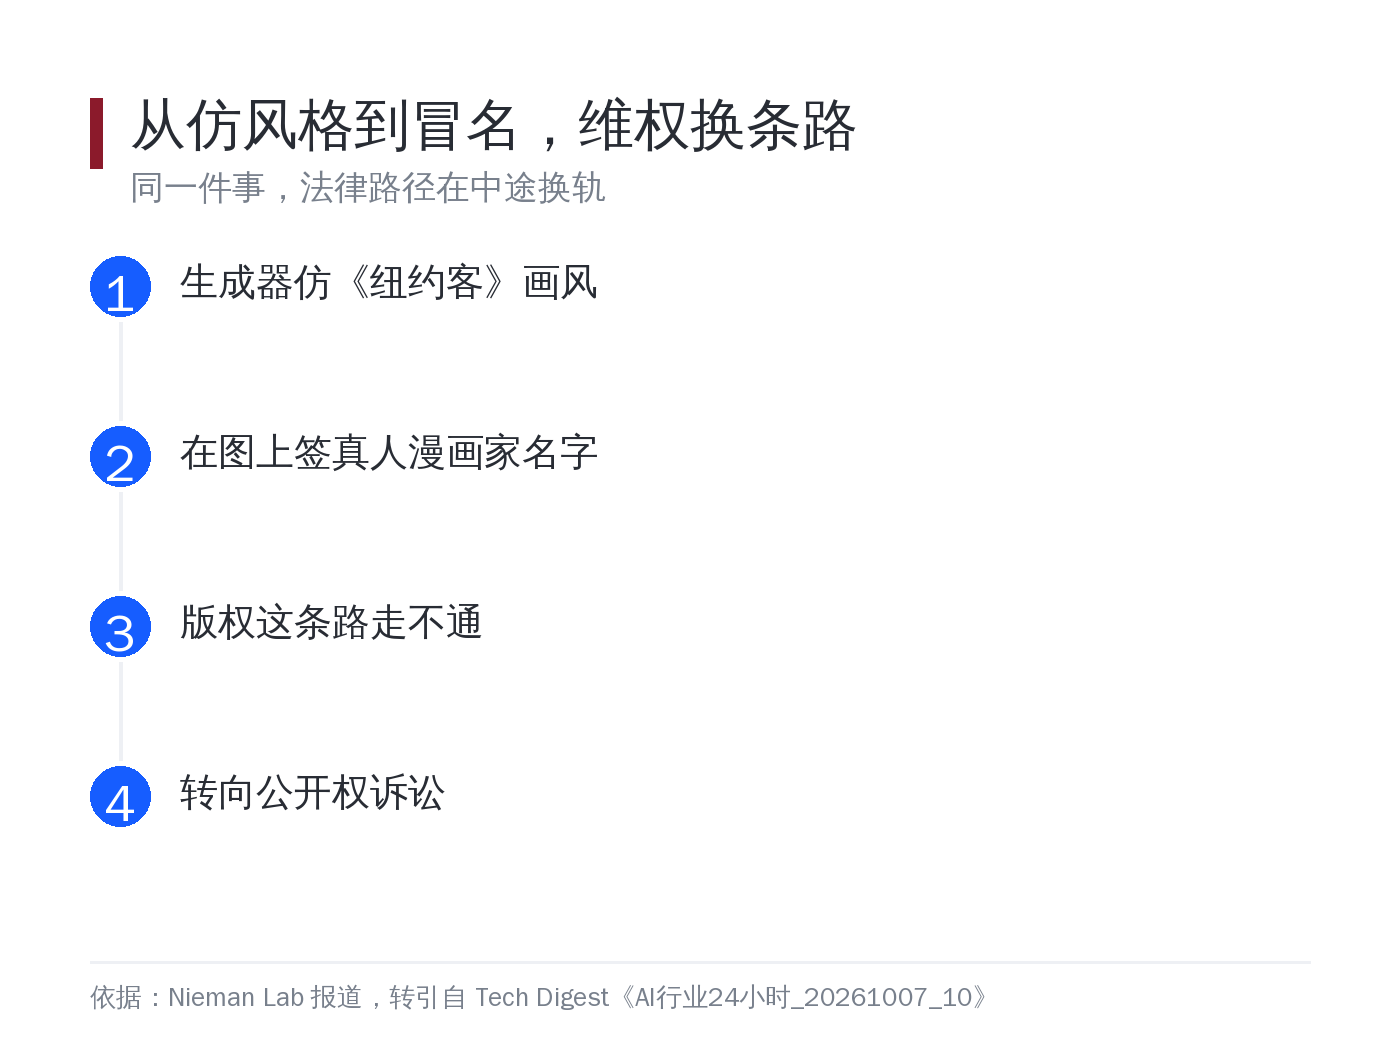
图注:同一件事,维权路径在"签名"这一步换轨——版权管不了通用风格,公开权才接得住冒名(依据:Nieman Lab 报道,转引自 Tech Digest 2026-10-07)
这里还有个容易被混淆的细节。《纽约客》明确表示从未授权任何大模型开发商使用其漫画训练模型,但母公司 Condé Nast 在 2024 年与 OpenAI 签过多年授权协议(来源:Nieman Lab,转引自 Tech Digest《AI行业24小时_20261007_10》)。两者并不矛盾:授权的是出版方的内容库,不等于漫画家个人同意被署名。
监管选的是标出来,不是禁止模仿
规则层的方向已经很明确:对付真假难辨,监管的办法是给内容贴身份,而不是禁掉模仿。
欧盟《人工智能法案》要求对 AI 生成的文本加水印,Anthropic 已在 2026 年 8 月公开其文本水印机制,采用 Google DeepMind 发表于《自然》的 SynthID-Text 方法变体(来源:Anthropic《How Claude's text watermark works》,2026-08,转引自源势AI《AI写的字,开始有隐形身份证》,2026-09-04)。
国内的口径更具体。2025 年 3 月 7 日,网信办等四部门联合发布《人工智能生成合成内容标识办法》,明确区分显式标识与隐式标识,要求服务提供者、传播平台和应用分发平台在不同环节各担其责,并自 2025 年 9 月 1 日起施行(来源:《人工智能治理全球合作进展研究报告》)。简单说,显式标识管"看得出来",隐式标识(元数据、水印等)管"可追溯",两条腿要一起走。
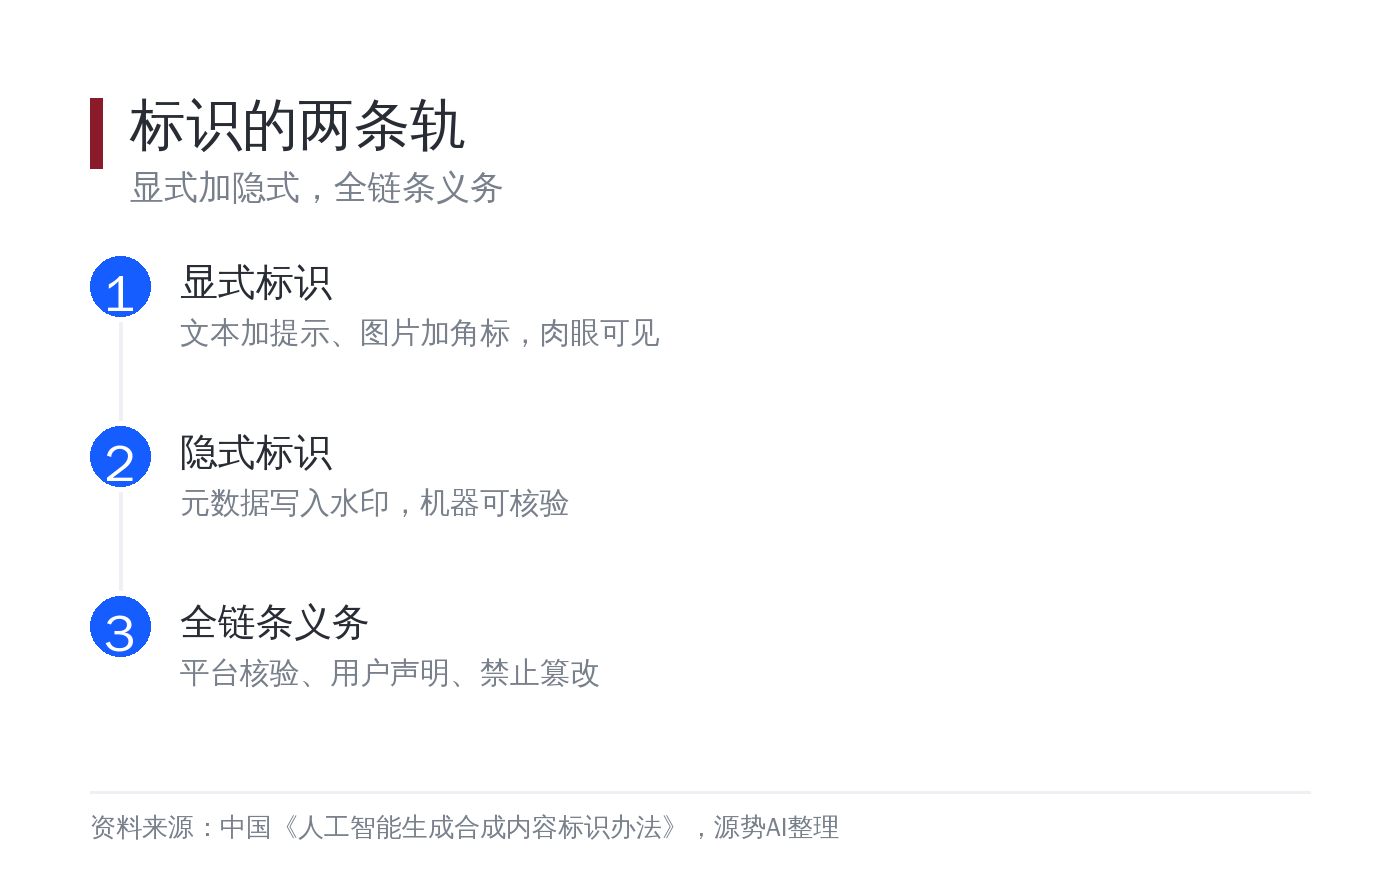
图注:显式标识加隐式元数据,是监管给 AIGC 定的两条轨,重点从能不能生成转向能不能辨认(来源:源势AI整理,规则内容引自《人工智能治理全球合作进展研究报告》)
这套逻辑和伪造签名是同一条因果链的两端。生成能力越来越真,验证手段就必须跟上;内容本身无法自证真假时,身份信息只能附着在流程上,谁生成的、谁的元数据、有没有水印。
对做内容产品的企业意味着什么
先别把水印和标识当合规负担,它是产品能力。交付物里能不能回答"这段内容是谁生成的、经过标识核验没有",正在变成企业客户的实际审计需求。
对创作者来说,这次事件给出的启示更现实。能被机器复刻的(风格、笔触)难以受保护,能被机器假冒的(签名、署名)反而成了维权着力点。把作品的身份信息留下来,比如 C2PA 内容凭证、发布记录、平台声明,比事后争论"像不像"更有效。
产品侧还有一个容易忽略的点。模型对"显得可信"的信号同样敏感,它模仿的不只是内容,还有让内容可信的那层外壳。别赌"模型不会冒名"。
规则落地得也很快。显式标识、元数据隐式标识、全链条义务已经写进《标识办法》,对 AIGC 产品来说,标识与溯源正从技术选项变成准入资质(来源:《人工智能治理全球合作进展研究报告》)。对一个做内容业务的企业,这意味着上线前就得把标识链路想清楚,而不是等被平台下架再补。
源势AI观点
我们的判断是,AI 生成内容的治理,主战场会从版权慢慢挪到标识与溯源。
版权保护的是表达,风格往往不在其中;标识和溯源保护的是"谁说的",这件事可以工程化。对企业来说,与其在版权边界上试探,不如把显式标识、元数据隐式标识、导出链路保全这三件事一次设计到位,欧盟法案、国内《标识办法》、平台细则的交集,其实指向同一套工程。
源势AI 的观点一直没变:AI 采信信息靠的是交叉验证,权威来自多个独立系统说同一件事。水印解决"谁生产的",交叉验证筛选"谁在引用",两张网叠加,内容产业的可信基建才算完整。
话题标签:#AI版权 #内容标识 #生成真实性
