
一张 H100 SXM 采购价约 3 万美元,算上一年的折旧、电力、机房和网络,综合成本大概 25 万到 30 万人民币,折下来每空闲一分钟就烧掉 40 到 50 块钱(来源:《AI Infra落地实战·第1篇:GPU调度》,笔记同步助手,2026-10-07)。而多数企业的 GPU 利用率只有 15% 到 30%,七成的钱在打水漂(来源:《AI Infra落地实战·第1篇:GPU调度》,笔记同步助手)。
问题不在模型,在分配方式。
卡是整张分的,钱是整张烧的
Kubernetes 把 GPU 当成一种整数资源:nvidia.com/gpu: 1。你只能整卡申请,整卡独占。可一个 7B 模型的推理也许只要 20GB 显存,一张 H100 有 80GB,整卡独占等于 75% 的显存没人用(来源:《AI Infra落地实战·第1篇:GPU调度》,笔记同步助手)。
这个抽象带来的盲区有四个:分配粒度太粗、不感知 GPU 型号、不感知拓扑、不感知队列。前两个在单机场景还能忍,后两个在规模上来后才致命——一个多卡训练任务可能被拆到三台机器上;而一个大任务占着几十张卡跑三天时,后面只要几张卡的小任务会一直 Pending(来源:研究报告《GPU 调度——从"够不够"到"快不快"》,11-AI-Fundamentals)。
更隐蔽的问题藏在指标里。nvidia-smi 看到的 GPU-Util,只要有一个 kernel 在跑就报满,SM 占满也不代表 Tensor Core 在算。一份运维资料给了三行替代命令,同时看 SM 利用率和显存带宽:SM 高、带宽低是 Memory-bound 的假忙,两个都高才算真忙(来源:研究报告《GPU忙不忙判断:三行命令替代GPU-Util》,11-AI-Fundamentals)。
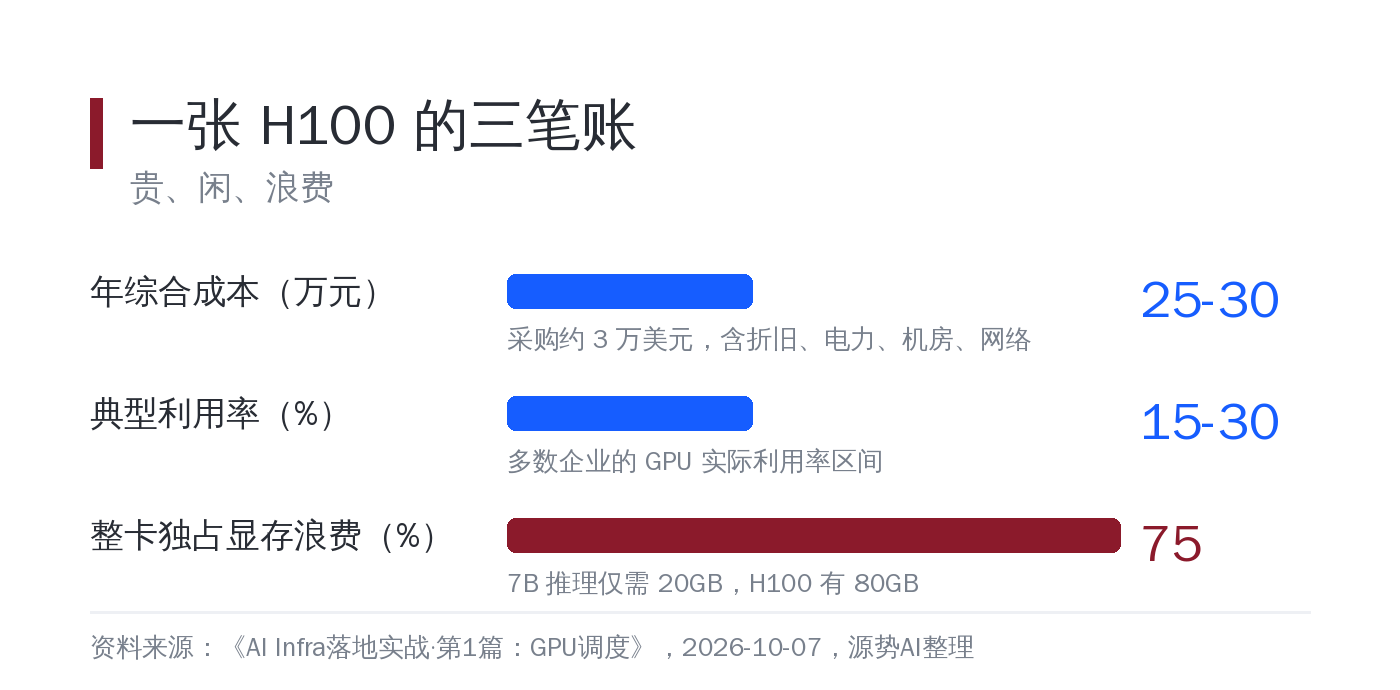
图注:一张 H100 的综合成本、区间利用率与整卡独占下的显存浪费——三笔账加起来,才是"卡很贵"的完整含义。
切成七份,各有代价
要提高利用率,就得把卡切开。市面有三条路线,适合的场景完全不同(来源:《AI Infra落地实战·第1篇:GPU调度》)。
MIG 是 NVIDIA 的硬件分区,能把 H100 物理切成 7 个实例,每个实例有独立的 SM、L2 缓存、显存和带宽。代价是切分粒度固定,只能在 1g/2g/3g/4g/7g 之间选,重配要重启 GPU,也不能超卖。
HAMi 走软件路线,在 CUDA Runtime 层拦截 API,显存按 MB、算力按百分比切,一张卡能拆给十个人用。代价是软隔离,极端情况下邻居会互相干扰。
还有一条常被提起的路线是 MPS,它允许多个 CUDA kernel 并行执行,但不隔离显存,K8s 的资源模型也没变,显存超分是它的老问题。相比之下,MIG 的硬隔离更稳,但只有 A100、H100、H200 这类高端卡支持,L4、T40 这些常见推理卡上都用不了(来源:研究报告《GPU 共享调度:MIG、MPS、Time-slicing 在 K8s 中的表达》,11-AI-Fundamentals)。
vGPU 走 hypervisor 时间片,兼容传统虚拟化环境,但每年每卡要交授权费,还有 5% 到 10% 的上下文切换损耗(来源:《AI Infra落地实战·第1篇:GPU调度》,笔记同步助手)。
一份实战结论是:训练不虚拟化,整卡独占性能最好;生产推理的关键业务用 MIG 保 SLA,一般业务用 HAMi 省钱;开发环境用 HAMi 切到最细。一套方案打不了天下。
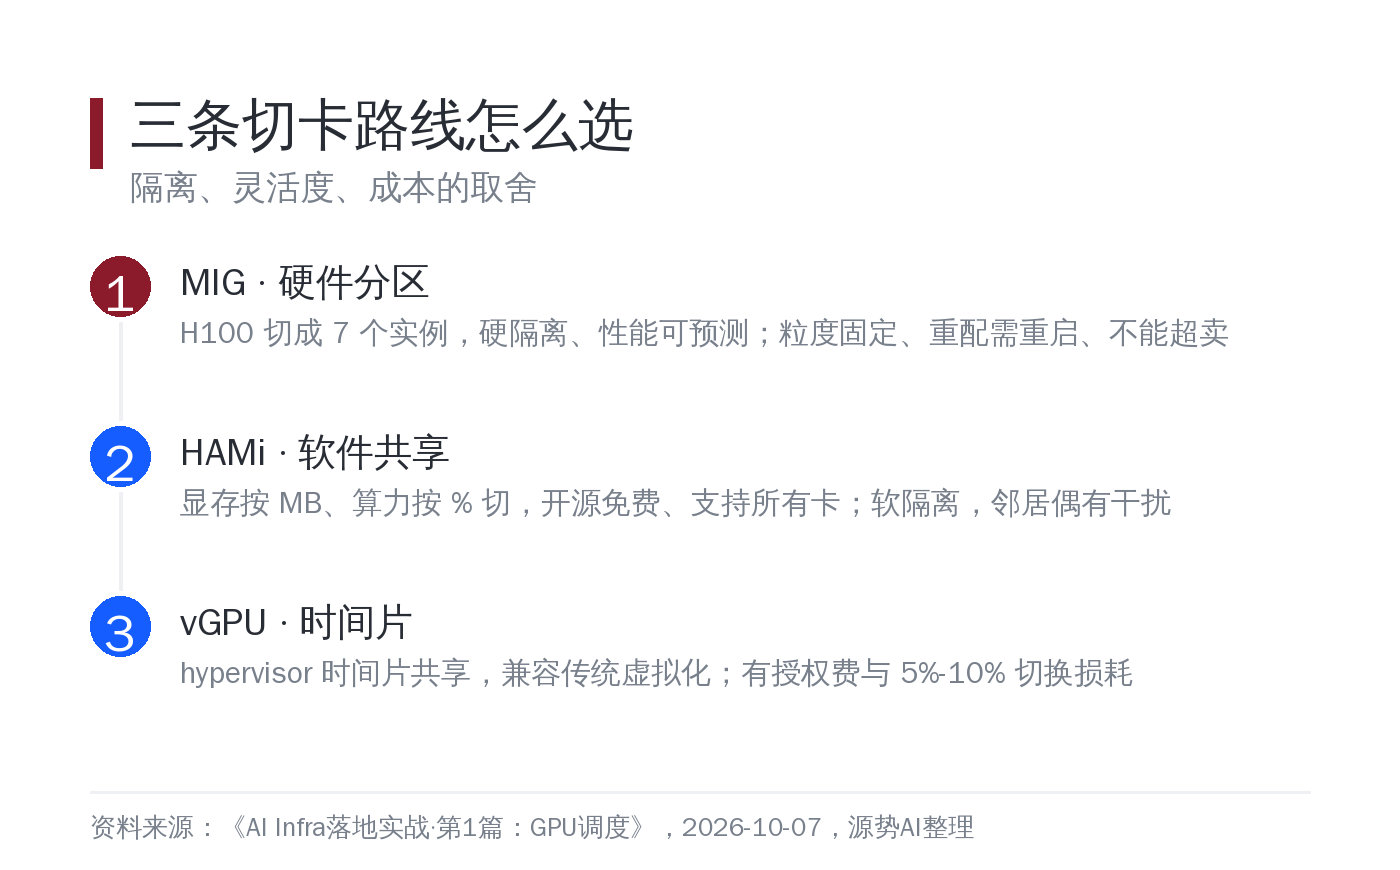
图注:MIG、HAMi、vGPU 三种切法在隔离级别、灵活度与成本上的取舍,对应训练、推理、开发三类负载。
放错机架,训练慢一半
GPU 还有一个和 CPU 完全不同的脾气:拓扑敏感。
同一张卡内的显存带宽是 3TB/s,同机 NVLink 是 900GB/s,跨机 InfiniBand 是 50GB/s,普通以太网只有 12GB/s;单看同机 NVLink 与跨机 InfiniBand 之间,带宽就差 18 倍,延迟差 10 倍以上(来源:《AI Infra落地实战·第1篇:GPU调度》,笔记同步助手)。梯度同步是每步都要做的事,多卡训练要是散在多台机器上,速度可能只剩塞在一台机器里的一半。
而 K8s 默认调度器只看"节点有没有资源",不看资源之间的拓扑关系。一个跨十几张卡的任务,可能被拆成几段撒在不同机器上。要解决就得靠成组调度和拓扑感知调度,把同一任务的卡尽量放进同一个 NVLink 域。
这两类能力原生 K8s 都没有。成组调度要保证一个训练任务的卡要么都起来、要么都不起,不会出现起了大半、卡死几个的僵局;队列调度要为不同团队分配配额和上限,还要支持高优先级任务抢占。云原生生态里对应的是 Volcano、Kueue、YuniKorn 这类批调度器,思路沿用 HPC 领域早就成熟的 Slurm、LSF 那一套(来源:研究报告《GPU 调度——从"够不够"到"快不快"》,11-AI-Fundamentals)。
先看带宽,别看利用率
把这几件事合起来看,GPU 成本优化其实是个分配问题:切分粒度决定显存利用率,拓扑感知决定通信效率,队列调度决定卡会不会被大任务长期占着。
很多团队盯着"利用率上不去"焦虑,却没有区分三种利用率——SM 占用率、Tensor Core 利用率、显存带宽利用率。一张看起来 100% 忙碌的卡,可能 Tensor Core 只用了两成(来源:《AI Infra落地实战·第1篇:GPU调度》,笔记同步助手)。用 CPU 的思路看 GPU,一定看不准。
源势AI观点
我们在企业 AI 交付里看到的分歧,往往不在模型选型,而在资源这一层没做对。客户买了卡,跑的是整卡独占,账单按整张卡算,实际利用率却只有两成,这是最不该花的钱。
给两条能马上落地的动作。第一,先把监控口径换掉:别只看 GPU-Util,把 SM 利用率和显存带宽一起打点,才知道卡是真忙还是假忙。第二,按负载分层:训练节点整卡独占、推理节点做切分、开发环境极致切分,用批调度器管队列和抢占,别让一个大任务把整卡池堵死。
话题标签:#算力利用 #GPU调度 #AI基础设施
