
图注:一图读懂本文要点——模型没动,换的是模型外面那套系统(来源:源势AI)
华为诺亚方舟实验室联合 UCL 等团队,把一个底模送上了 ARC-AGI-3 公开集。25 款游戏、183 个关卡全部通关,RHAE(相对人类行动效率)拿到满分 100,总操作 7518 次——人类完成同一套关卡用了 17135 次,比它多出约 56%(来源:量子位,2026-10-14,转引自 Tech Digest《AI行业24小时_20261014_10》)。
分数反常的地方在于,模型一个参数都没改。
底模是 Claude Opus 5,全程不更新权重、不做游戏微调。同一个底模在官方测试框架下的平均 RHAE 只有约 40.7 分,换掉外部系统之后提升了 59.3 分(来源:量子位,2026-10-14,转引自 Tech Digest《AI行业24小时_20261014_10》)。
分数跳在哪一环
Memento 3 的改法,是把「怎么玩」从模型里搬出来。
它用 Code as Model 的思路,让智能体自己维护一份 Markdown 规则手册,再搭一套可运行的 Python 世界模型。遇到新关卡,先在自建模拟器里推演,确认了再落地执行。规则手册迭代了 11 个版本,团队还引入 Git 做版本回溯(来源:量子位,2026-10-14,转引自 Tech Digest《AI行业24小时_20261014_10》)。
拆开看是三件事:模型负责判断,手册负责记忆,模拟器负责试错。三样都在模型外面。
Pong 里有个细节:智能体摸清控制策略之后,不再请求大模型推理,连续三局以 21:0 拿下(来源:量子位,2026-10-14,转引自 Tech Digest《AI行业24小时_20261014_10》)。
这套东西在行业里已经有名字。一份 2026 年的 Harness 工程综述汇总了同类实验:同一个模型,把外部工程做足,成绩从 30.91% 抬到 74.55%(来源:《谷歌发布 Harness Engineering 综述:同一个模型,从 30.91% 到 74.55%,2026 最值钱的 AI 工程,是给它造一副「Harness」》,2026-09-11)。

图注:同一个 Claude Opus 5 底模,官方测试框架下平均 RHAE 约 40.7,换成 Memento 3 系统后拿到满分 100(数据来源:量子位,2026-10-14,转引自 Tech Digest《AI行业24小时_20261014_10》)
17% 和 1% 这两个数
这个结论不是今天才有。
腾讯研究院在《2026人工智能十大趋势报告》里给过一组更狠的对照:在专门测「现学现用」的基准上,即便把所有必要信息完整放进上下文,前沿模型的解决率也只有 17% 出头——模型倾向于用预训练里记住的老办法,无视眼前的新规则。另一个对照更极端:ARC-AGI-2 上前沿模型四个月从 53% 冲到 98%,换成不给说明书、需要交互的 ARC-AGI-3,所有模型被打回 1% 以下(来源:腾讯研究院《2026人工智能十大趋势报告》)。
能力曲线和可靠性曲线,本来就不是一条。
笔记《智能体Harness(驾驭运行层)功能分析》把这件事写成过一个式子:智能体等于大模型加上运行层,模型负责思考决策,运行层负责把抽象决策变成安全、可执行、可管控的真实行为(来源:《智能体Harness(驾驭运行层)功能分析》,2026-08-12)。
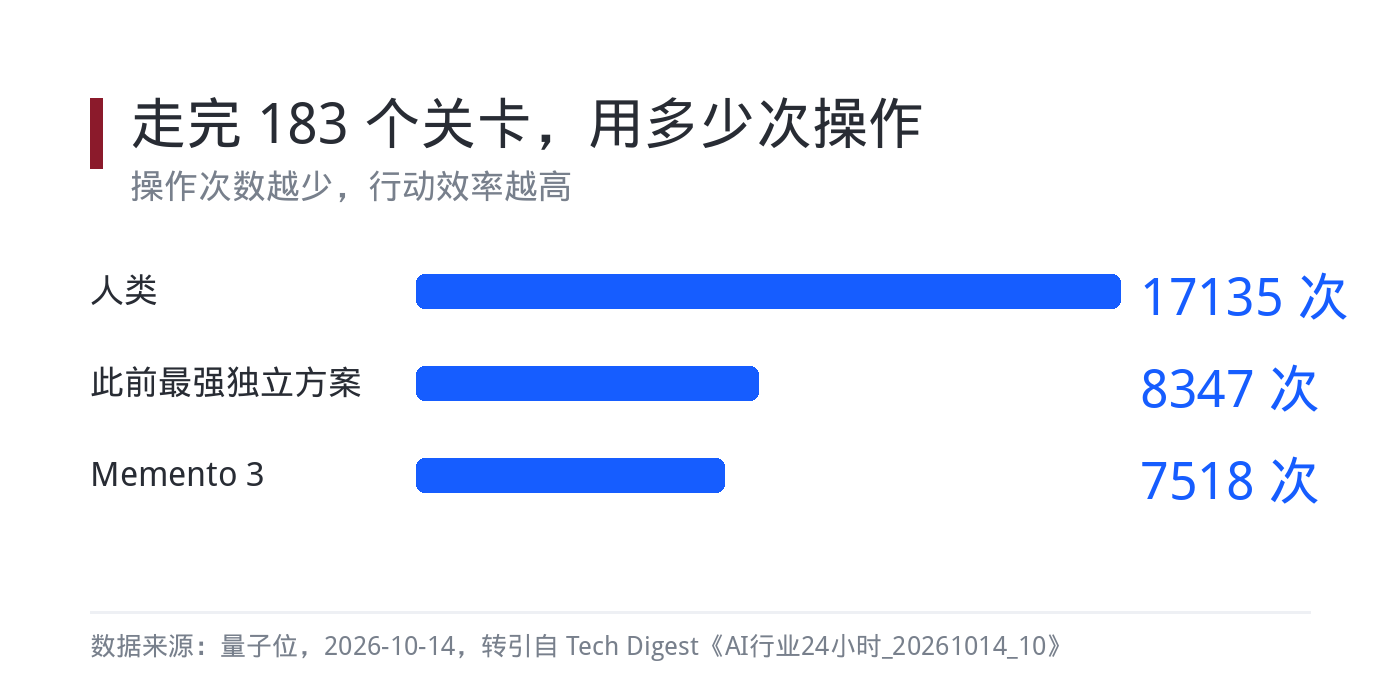
图注:RHAE 满分背后是操作次数——Memento 3 用 7518 次走完 183 个关卡,人类用了 17135 次,此前最强独立方案是 8347 次(数据来源:量子位,2026-10-14,转引自 Tech Digest《AI行业24小时_20261014_10》)
这套方法搬得出游戏吗
口径得交代清楚。
RHAE 衡量的是行动效率,不是通用智能;7518 次对 17135 次,比的是用多少次操作完成任务,不是谁更聪明。成绩出自团队论文与公开集自测,目前没有独立第三方在同一配置下复现,各方案的智能体设计与算力配置不同,横向数字不宜直接比较(来源:量子位,2026-10-14,转引自 Tech Digest《AI行业24小时_20261014_10》)。
「不再调用大模型」也是策略固化之后的局部现象,不等于这套系统能脱离模型。
更现实的问题在反馈信号。游戏环境有明确的胜负判定,规则手册写错了,重跑一次就知道;企业场景里没这么干净的判据,手册迭代 11 版这件事,落到业务系统上可能要付出真实代价。
规则手册写错一次,在游戏里是重跑一局;在业务流程里,可能是一条已经发出去的错误建议、一次已经落库的错误写入。前者能回滚,后者要人工兜。这也是为什么版本回溯和模拟推演这两件事,在业务侧比在游戏侧更值钱——它们不是为了拿更高分,是为了让错误停在推演阶段。
迁移的可行性取决于环境有没有可判定的反馈。金融风控有明确的对错标签,工业质检有物理标准,这类场景的迁移条件最好;营销文案、咨询报告这类结果依赖主观判断的任务,规则手册少了验收环节,可能从「提升可靠性」变成「提升自信」。
源势AI观点
第一,把「模型能力」和「系统能力」分开记账。同一个底模在 40.7 和 100 之间的那段差距,不是模型厂商的责任,是集成方的责任——采购评估表里,运行层的成熟度权重该往上提。
第二,别把可靠性当事后补丁。规则手册、模拟推演、版本回溯这三件事,本质是把不确定性关在模型外面;最好在项目立项时就和模型选型一起定下来。
第三,验收口径跟着换。既然「行动效率」类指标比「答对一次」更接近生产,验收标准也该从「跑通几个 demo」改成「稳定完成多少比例的任务」。模型越强,这套外部机制越值钱。
话题标签:#智能体 #Harness #任务完成率
