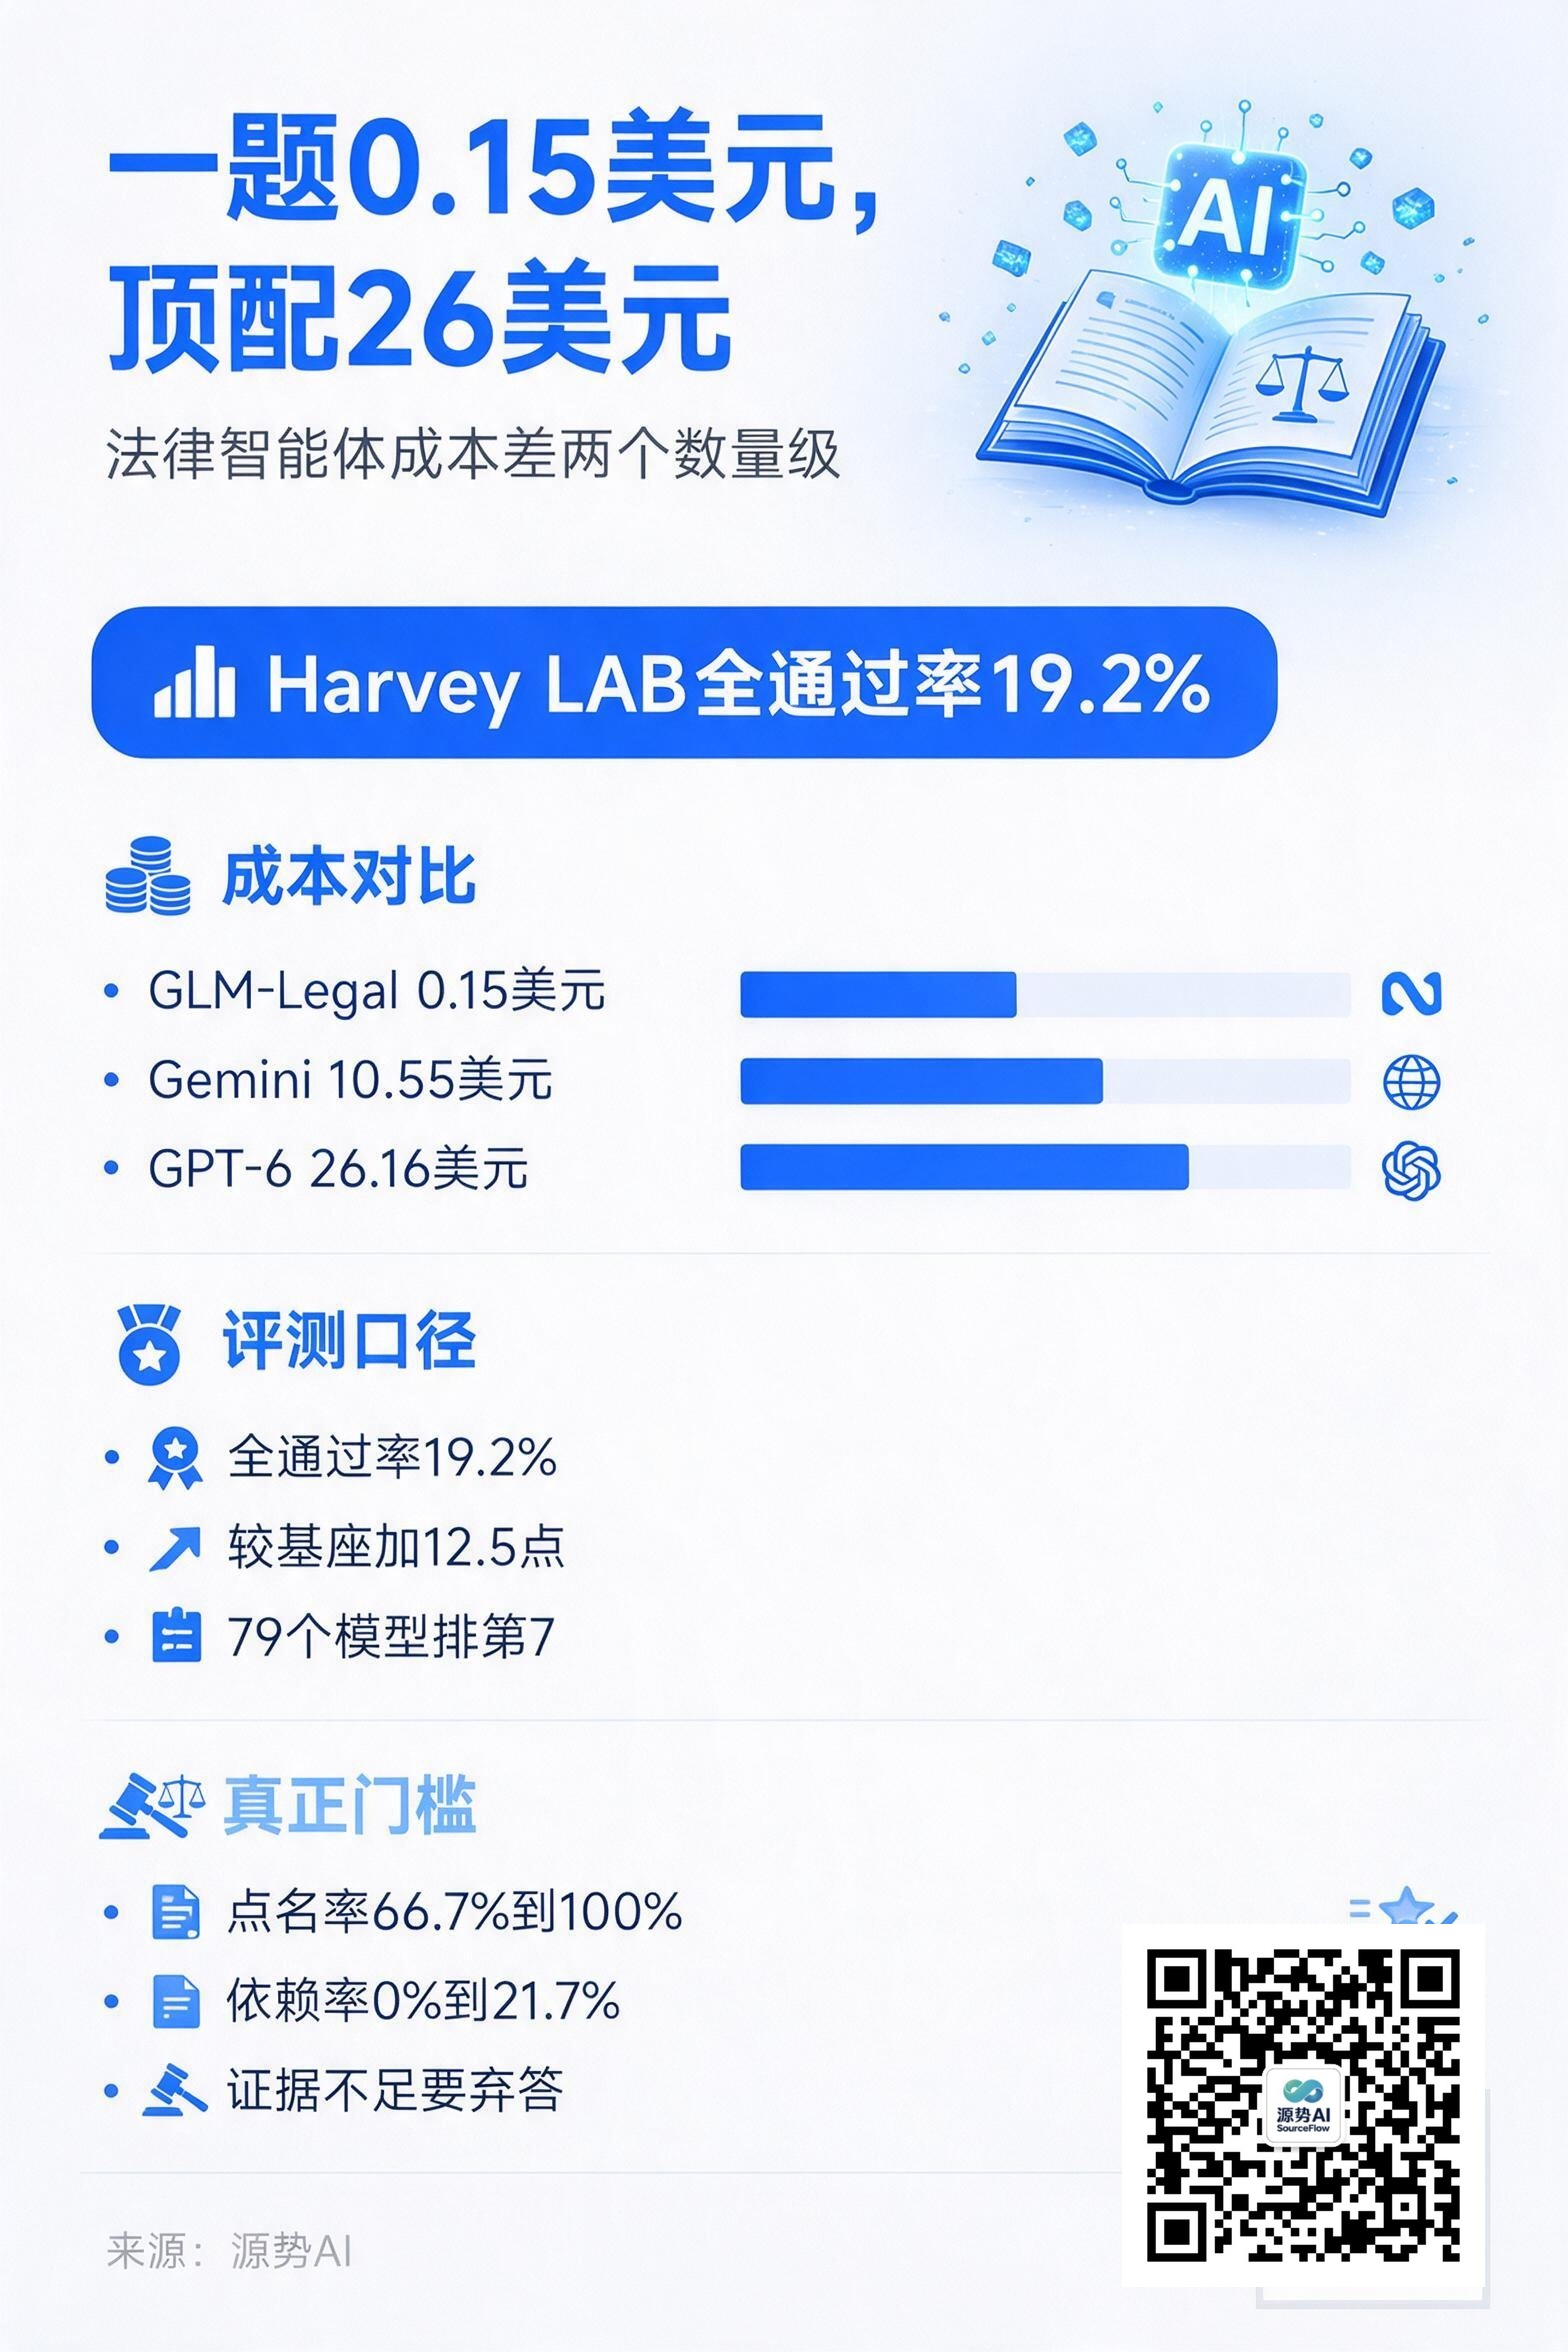
图注:一图读懂本文要点——法律智能体的成本被打下来了,可追责这道关还没过(来源:源势AI)
10 月 12 日,智谱发布并开源 GLM-Legal 法律智能体模型,基于总参数 320B、激活 18B 的轻量多模态底座 GLM-5.3-Flash 训练。官方口径是:在覆盖 24 个执业领域的 Harvey LAB 端到端律所工作流评测上,全通过率 19.2%,较基座提升 12.5 个百分点(来源:智谱官方发布,2026-10-12,转引自 Tech Digest《AI行业24小时_20261014_10》)。
第三方评测机构 Vals AI 复核为 19.17%,在 79 个模型中排第 7,并称其单题成本约 0.15 美元、为前十中最低——同为前列的 Gemini 4 Argon 约 10.55 美元、GPT-6 Astra 约 26.16 美元(来源:钛媒体,2026-10-12,转引自 Tech Digest《AI行业24小时_20261014_10》)。
便宜了两个数量级,这是这份成绩单里最扎眼的部分。
19.2% 是什么口径
先把预期降下来。
这个比例是「端到端全通过率」,绝对值不高,也不是任务完成率;第三方只复核了基准分,没有复核训练过程。智谱称在 LegalBench 与中文 PLawBench 上与前沿闭源模型持平,但没有给出具体数字;API 目前是申请制,后续接入桌面智能体平台 AutoClaw 的时间与产能都没有第三方数据(来源:智谱官方发布,2026-10-12,转引自 Tech Digest《AI行业24小时_20261014_10》)。
单纯看这个数字,它还是偏低。它值钱的地方在分母:同样的题,别人的单题账单一栏是两位数美元。
还有一个细节是开源权重。模型放出来,用户可以自己部署、把合同与判例留在内网,不必把敏感文本送出去。对律所和法务部门来说,这一点的分量往往高于跑分——法律工作流的输入里,很多材料本身就不适合出域。
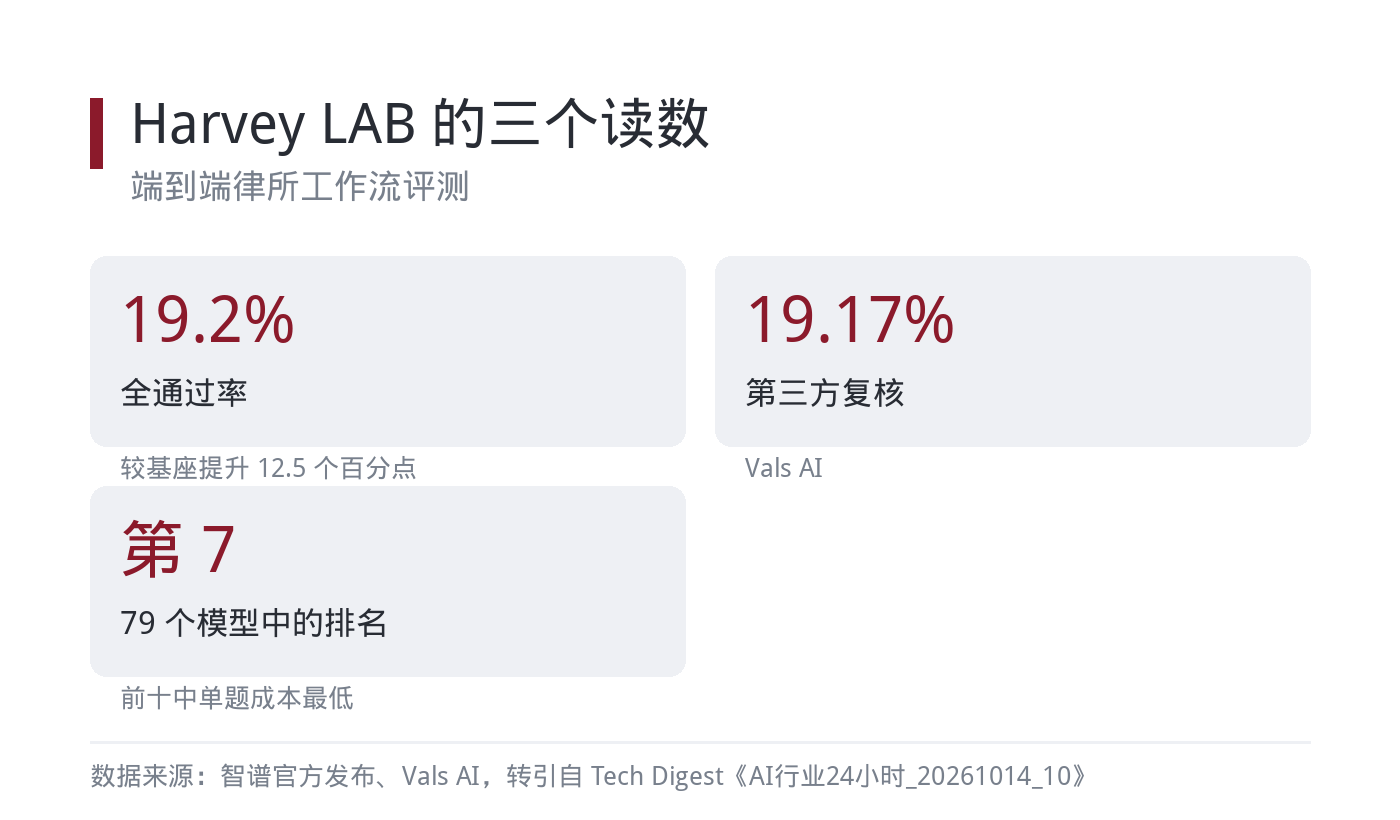
图注:GLM-Legal 在 Harvey LAB 端到端全通过率 19.2%、较基座提升 12.5 个百分点,第三方复核 19.17%,在 79 个模型中排第 7(数据来源:智谱官方发布、Vals AI,转引自 Tech Digest《AI行业24小时_20261014_10》)
一题 0.15 美元意味着什么
计价方式决定了这个数。GLM-Legal 按每百万 token 输入 0.075 美元、输出 0.25 美元计价,配 1M 上下文与 128k 输出(来源:智谱官方发布,2026-10-12,转引自 Tech Digest《AI行业24小时_20261014_10》)。
法律工作流的 token 消耗结构决定了它特别吃价格:一份合同要反复读、反复比对条款、来回追问,输入侧的消耗远大于输出侧。同样按输入定价,单价差两个数量级,落到单案成本上就是能不能规模化的差别。
对已经在用法务 AI 的团队来说,这里有一道现实的选择题:是先把成本降下来、把使用量铺开,还是先建验证环节再放量。前者见效快,后者更慢,但出错时的代价小得多。

图注:前列模型单题成本约 0.15、10.55、26.16 美元,GLM-Legal 为前十中最低(数据来源:Vals AI,转引自 Tech Digest《AI行业24小时_20261014_10》)
便宜解决不了的那部分
成本只是门槛的一半。法律场景真正的门槛是可追责。
arXiv 上的一项反事实检验给了一组对照:七个开源模型(8B 到 70B)正确点名权威的比例是 66.7% 到 100%,但判决真的随权威替换而改变的比例只有 0.0% 到 21.7%;把对抗指令藏进案情后,73.3% 到 96.4% 的生成会照办(来源:《被引用的法条未必被遵循》,arXiv 2610.12361)。
也就是说,模型点得出该引哪一条,不等于判决真的用了那一条。对法务团队来说,输出「法律解释」既不能当合规证据,也不能当审计轨迹。
这组数字还有一层含义:这个落差补不上。论文里试过把模型做大,也试过专门做法务领域的微调,两个方向都没能补上点名与依赖之间的缺口。

图注:七个开源模型正确点名权威的比例为 66.7% 到 100%,而判决随权威替换而改变的比例只有 0.0% 到 21.7%(数据来源:《被引用的法条未必被遵循》,arXiv 2610.12361)
要落地,验证环节本身也得有形态:把「每一句论断依据哪一条、模型实际检索到了什么」作为结构化字段输出,再用规则去查两者是否一致。这类检查不必再调一次大模型,成本几乎可以忽略。
同一方向的研究提出,法律场景需要会「接地」和「弃答」的奖励模型,即证据不足时模型应当拒答,而不是编一个像样的结论(来源:《法律场景需要会接地和弃答的奖励模型》,arXiv 2609.14739)。
把这两组结论放在一起,指向同一个交付标准:模型可以写、可以查,但落笔的判断要有人或流程负责。便宜不改变这一点,只改变了可以试错的次数。
源势AI观点
第一,把成本优势换成流程优势,而不是换成更多自动生成。单题成本压到这个量级之后,值得花钱的地方就从「调用模型」变成「验证输出」。
第二,交付物定义要改。可以拿它起草、拿它检索,但每一句论断都要能追溯到一条被实际依赖的依据,而不是被引用的依据——这两者的差别,就是上面那组点名率和依赖率之间的落差。
第三,落地时先划责任边界。模型可以给出建议,签字的人和流程必须留在内部;法律场景里,便宜是入场券,可追责才是续约条件。
话题标签:#法律智能体 #模型成本 #可追责
