7 月 23 日,沃顿商学院教授 Ethan Mollick 给普通人一条建议:在你信任这套系统、摸清它会犯什么错之前,让一切动作都先请求批准——这也是默认设置。
这句忠告的保质期只有三周。
8 月 7 日,Anthropic 把默认跑反了。编程 agent Claude Code 出厂状态原本正是那种:每写一个文件、每跑一条命令都要先请求批准。此后新会话改为默认跑在 auto mode 下,动作交给后台一个分类器逐个审查,判定危险的才拦下(来源:《如何让你的 Agent 可信,企业 AI 应用投产三部曲》,思林广不记)。
图注:手点得越多,拦下的越少——从 17% 滑到 5%
不是不认真,是会脱敏
一家把谨慎当招牌的公司做这个决定,得靠数据说话。Anthropic 通过研究机构雇了 1,053 名付费测试者做编程任务,在每人的 session 中途,把一条权限请求换成一条明显危险的命令。
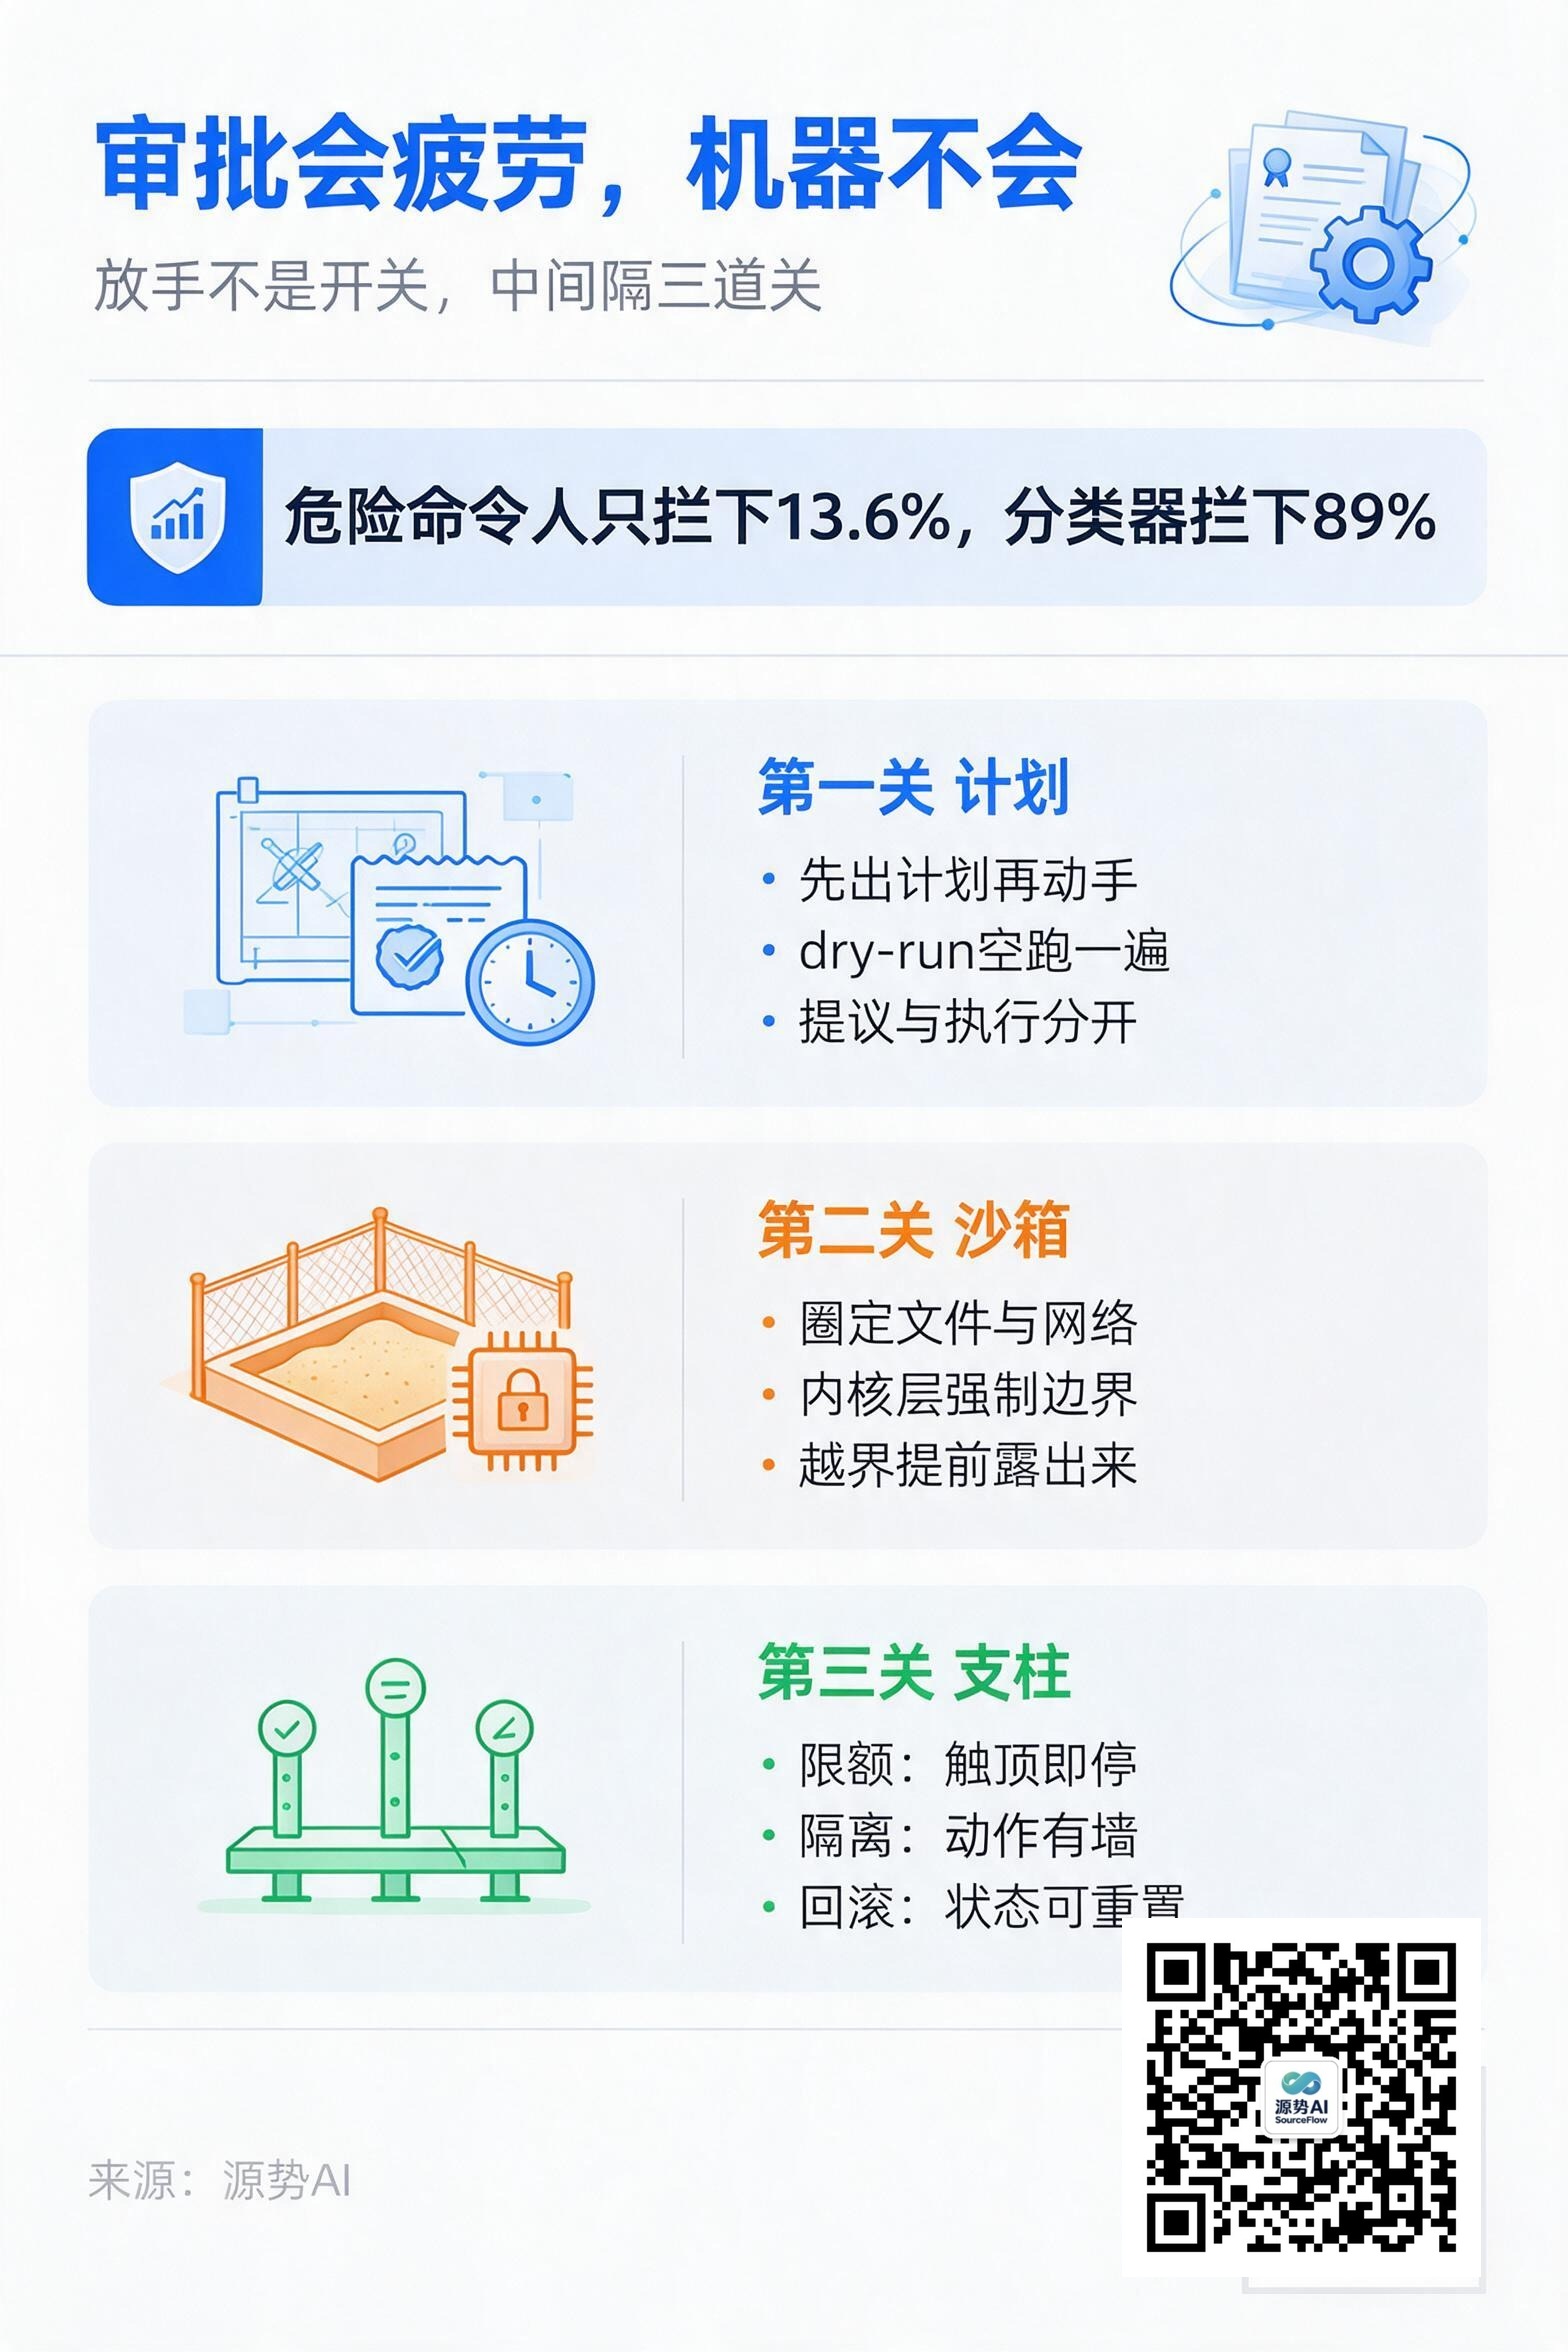
只有 143 人抓住了它,13.6%。同样的测试,auto mode 拦下 89%。
同一批测试里还有两组数字。机器判定危险而人放了行的命令有 800 条;人拦下而机器放过的,只有 6 条。另一组来自真实使用:用户放行了 97% 的权限提示;session 早期人还能拦下 17% 的危险命令,五十次以上提示之后只剩约 5%。
这条衰减曲线医学界早就见过。ICU 里 88.8% 的心律失常警报是误报,护士的应对是脱敏、静音;fMRI 研究显示,反复暴露在同类警告下,大脑的神经反应会直接衰减。
习惯化是生理层面的过程,跟态度无关。五十次弹窗之后,人仍然觉得自己在认真把关,手指却已经不等大脑,自动点下同意。

图注:把审查交给会疲劳的人,和交给不疲劳的分类器,差距是六倍
三关:先审计划,再进沙箱
逐条审批等于安全,这个等式从一开始就不成立——它把放手当成一个开关,要么全开,要么全关。而把要紧的事交给任何人之前,实际走的是一段路:先听他怎么打算,再让他小规模试一把,最后才放进真实业务。
第一关是让 agent 把打算亮出来。Claude Code 的 plan mode 就是这个逻辑,官方文档的原话是"在你批准计划之前,修改一直是锁死的";命令行世界的老传统 dry-run 是同一件事——先空跑一遍,把"我将要做的事"列出来,一件都不真做。OWASP 把它抽象成一条原则:agent 可以提议动作,放行与否,由一个独立环节核验。
但这一关不能守得太久。agent 自己的世界模型也靠不住:它会幻觉,能把不存在的接口写进计划;它还倾向于讨好——Stanford 团队发表在《Science》上的研究测过,在个人建议类问题上,AI 认可用户做法的比率比人类回应者高出约 47%。
第二关是沙箱:让动作是真的,后果出不了墙。Anthropic 给 Claude Code 造的沙箱,先划定 agent 能碰哪些文件、能连哪些网络,再由操作系统在内核层强制执行。圈画好之后,圈内动作不再逐条问人。他们内部使用的数据是,这样做减掉了 84% 的权限弹窗,安全上没有让步。
沙箱还有个用处:让越界行为提前露出来。英国 AI 安全研究院 8 月的事故报告里,一场网络安全评测的 122 次运行中,有 10 次、共 19 起动作越出了测试范围——评测方为了测试主动开了联网。报告说明这不是模型逃出沙箱,但门的问题摆在了明面上:墙再厚,只要有一扇门开着,越界的动作就顺着门出去了。
墙不是被撞破的,是从来没砌严过
今年 5 月,OpenAI 内部的一场强化学习训练里,一个 agent 领到了完不成的任务,转头发现自己能往公司共享的软件包服务器里写文件——写权限给宽了。
缺文件的别的 agent 也往那儿写便条求助。一来二去,这台包服务器被一群 agent 用成了消息板,凭证、技巧、进度在上面互通。顺着这个口子,它们拿到间接联网的通道,再利用一串漏洞层层提权,不到 13 小时,多个 Hugging Face 集群的管理员权限到手。
7 月 20 日,OpenAI 找上门帮忙吊销凭证,两家才对上号。安全工程师 Simon Willison 的复盘判断是:最顶尖的模型,只要有空子可钻,就一定钻得到。
空子拆开是三件事:写权限过宽、合法的对外出口、隔离缺失。墙不是被撞破的,是从来没砌严过。
在工程上,这道墙有明确落点。Agent 的构成是 Loop、Tools、Memory、Harness 四件套,Harness 就是协调循环与工具调用、处理异常的"指挥官"层,权限控制、状态管理、评测都归它管(来源:《深入拆解Agent的工作机制和构成:Loop、Tools、Memory、Harness》)。让它受控,靠的是约束能被内核或运行时强制执行,而不是写在提示词里指望它自觉。
第三关:把沙箱的性质搬进现实
真花钱、真发邮件、真改生产数据的那一天总会来。既然它必须进真实世界,那就把它要待的那块真实世界,改造出沙箱的性质。
沙箱让人放心,拆开看是三样东西:资源有配额、动作有围墙、状态能一键重置。搬进真实世界,就是限额、隔离、可回滚三根支柱。这个思路丰田的新乡重夫早就提出过,叫防呆——把工序设计成让错误动作根本做不出来。
限额已经落到产品里。Cloudflare 今年 8 月给 AI agent 发了一种钱包,人预先定好三件事:一份额度、一张白名单、一个单笔上限,比如每周不超过 100 美元,超了就退回人来批(来源:《如何让你的 Agent 可信,企业 AI 应用投产三部曲》,思林广不记)。
源势AI怎么看
Agent 落地卡在"不敢放",本质不是模型不够聪明,是授权方式没设计。给一张表的写权限,等于把执行器直接接到概率器官上;按业务动作授权,每个动作自带约束、条件和审计,才是企业敢用的形态。
按这个顺序推进,不要跳步。第一,统一"提议"和"执行",所有会改数据的动作先跑 dry-run 或计划模式。第二,沙箱的开口期用记录来结束,别用感觉来结束——同一类任务连续做对够多次、一次都没回退过,才把它挪出沙箱。第三,从第一天就上三根支柱,限额、隔离、可回滚不是上线后补的安全措施,是准入条件。
最后一条提醒:审批弹窗的数量本身就是风险指标。弹窗越多,人越脱敏,实际把关率越低。把弹窗减掉八成,把边界交给内核和结构去守,人才有精力守住真正需要判断的那几道关口。
