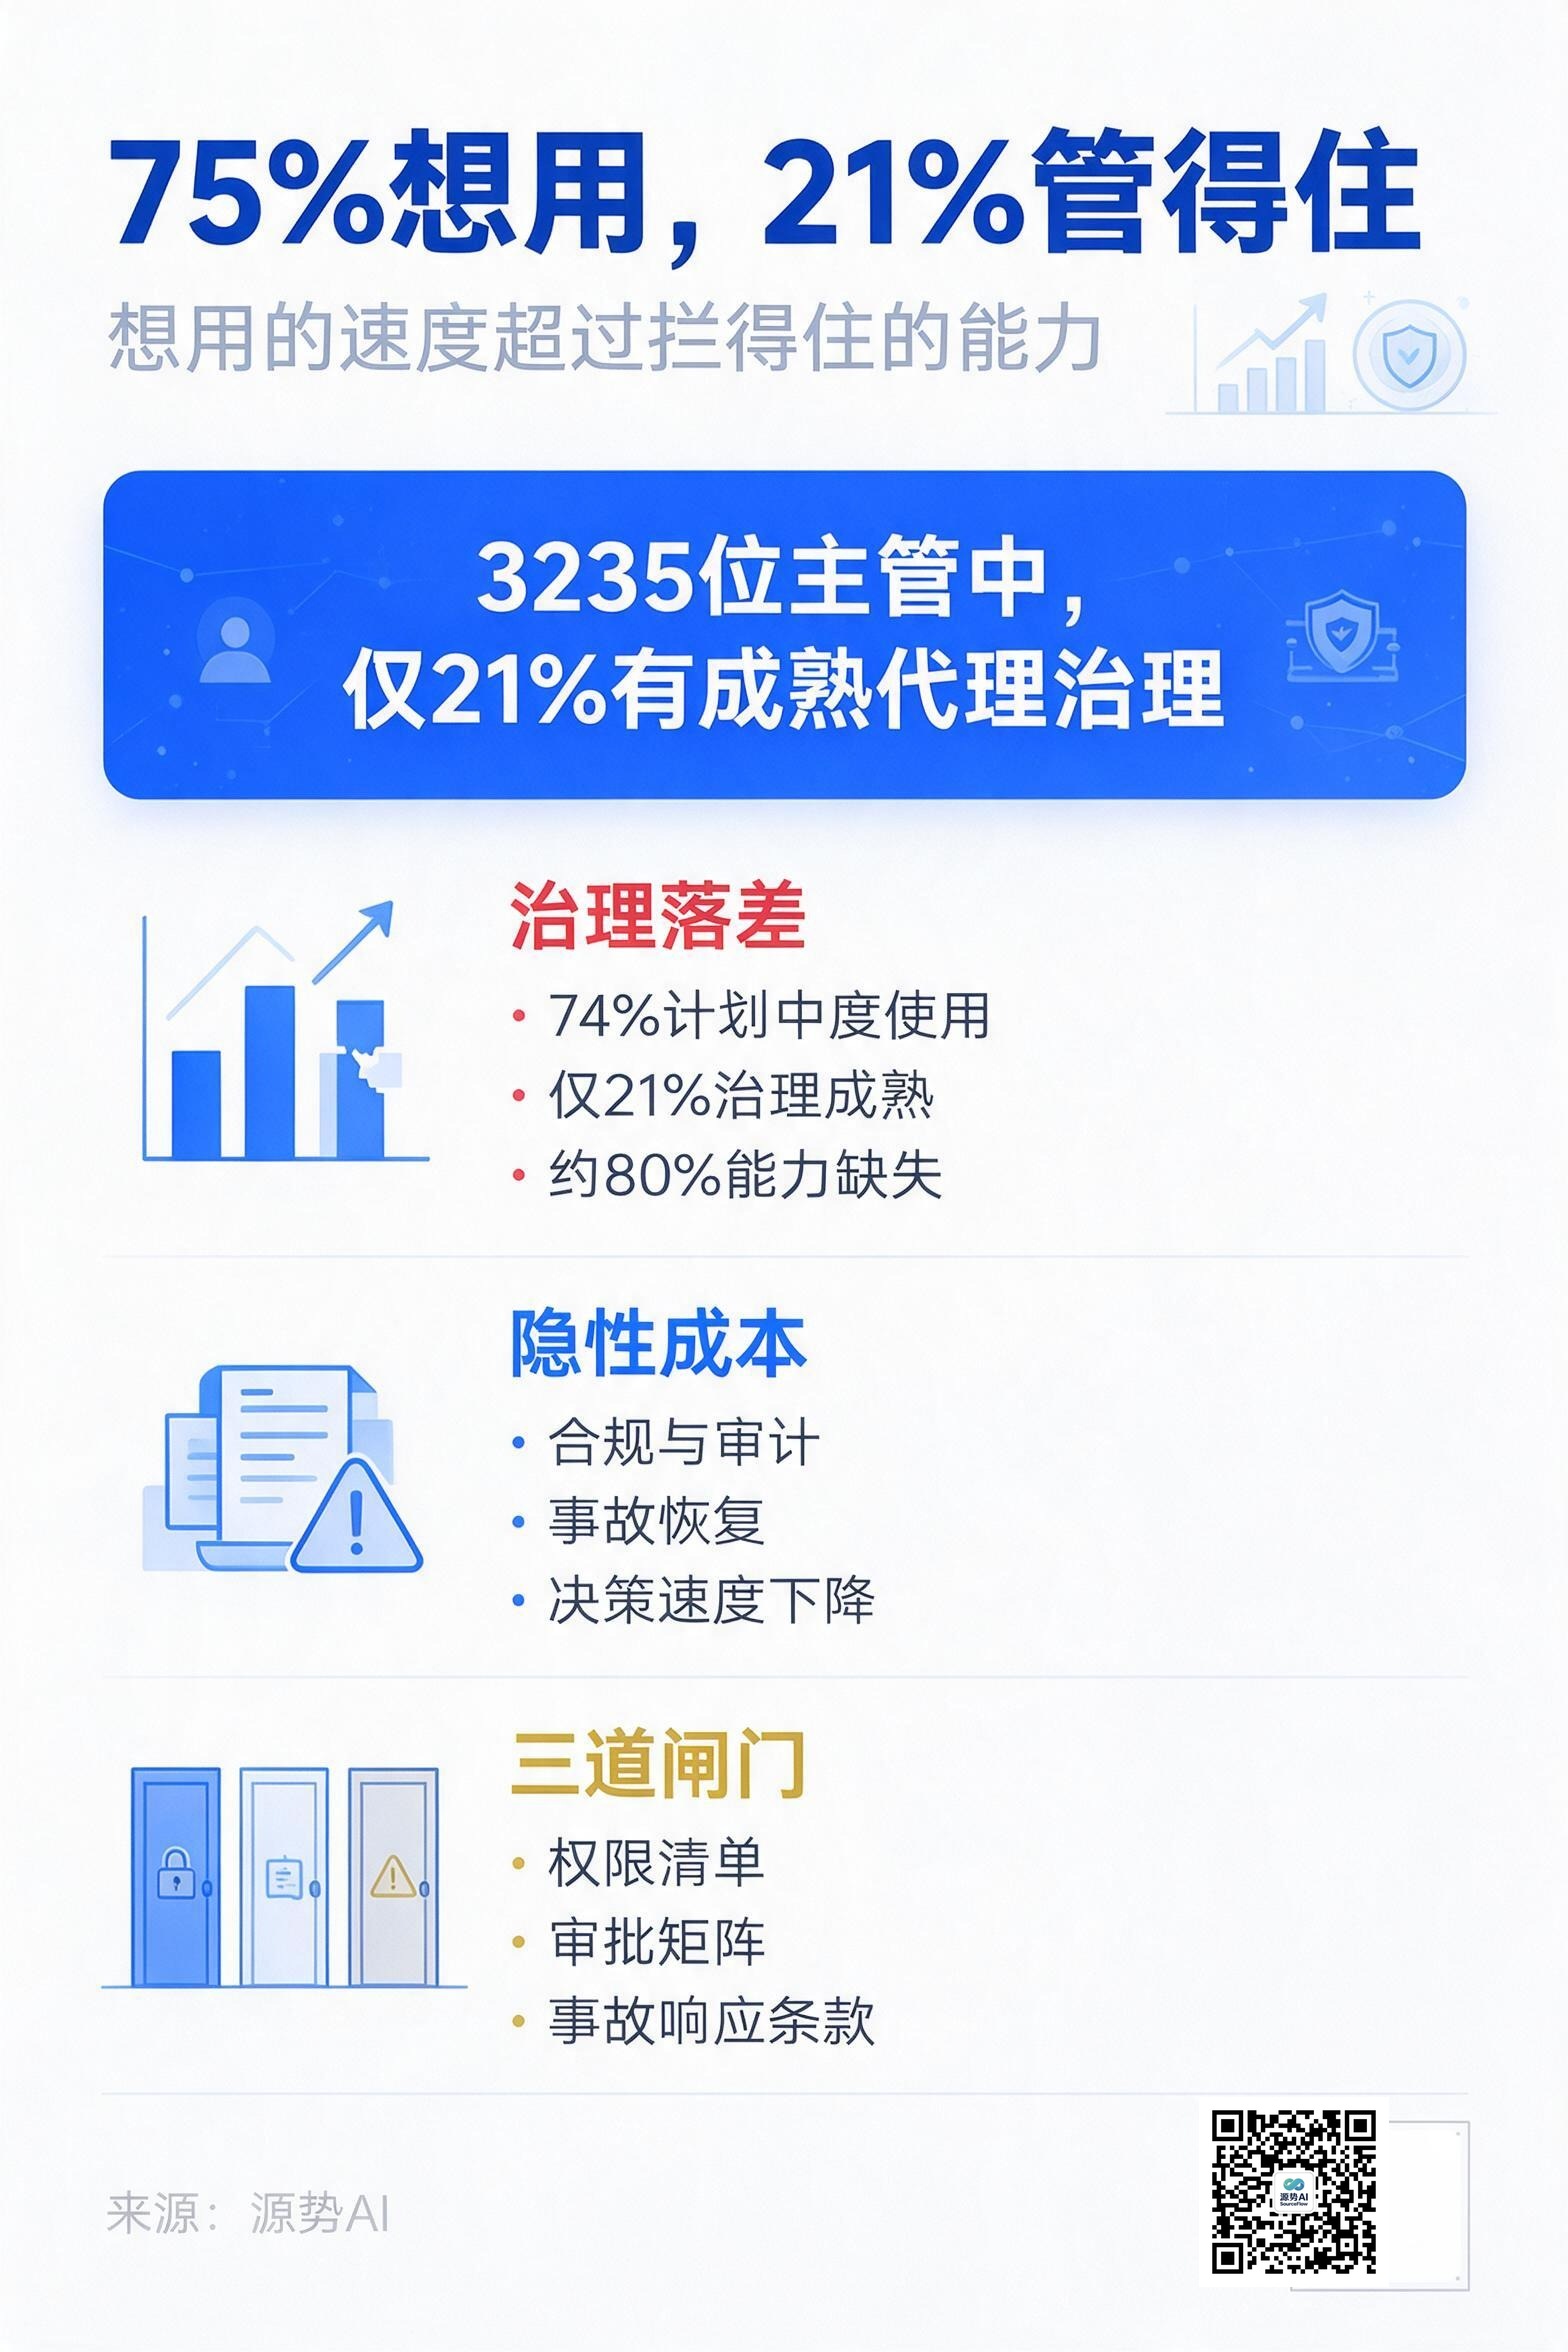
德勤在《2026 企业 AI 现状》报告里调查了 24 个国家、3235 位直接参与本公司 AI 项目的 IT 与商业主管:74% 的受访者预期所在公司在 2027 年前会把 AI 代理用到"中度"以上,其中 23% 预期"大量使用",5% 预期把代理完全整合为核心运营组件;但同一批人里,只有 21% 说本公司已经建立了成熟的代理治理机制(来源:Deloitte《State of AI in the Enterprise 2026》,调查于 2025 年 8—9 月执行,n=3235)。这中间的落差是 54 个百分点。
换句话说:想用的人比管得住的人多了三倍还多。企业的算盘打在前半句,风险落在后半句。
想用的速度,是超配的
德勤这份报告里最能说明加速度的,不是 74% 这个数,是它背后那句判断:代理型 AI 的使用在受访企业里扩散很快,而监督机制没跟上(来源:同上)。
这个"跟不上"不是抽象的。德勤把成熟治理该有的东西列了出来:明确边界,说清哪些决策代理可以独立做、哪些必须人工批准;实时监控,能追踪代理行为并标记异常;审计轨迹,能还原代理动作的完整链条(来源:同上)。约 80% 的受访企业目前不具备这些能力。
也就是说,多数企业的现状是:代理已经能读写系统、能发消息、能改配置,但企业拿不出一份能回答"这个动作是谁允许的"的记录。这不是技术欠账,是责任欠账。
缺口会以三种方式变成成本。第一种是合规成本:数据跨境、行业监管、内部审计,任何一项都可能要求企业证明代理行为的可追溯性。第二种是事故恢复成本,代理错改一次生产配置,损失的修复时间往往超过它之前省下的所有工时。第三种最隐蔽:决策速度下降。谁都不敢批,代理的上限就被锁死在最低自主等级。
德勤这份报告还给了一个可以对照的时间差。74% 的受访者认为本公司 2027 年前会把代理用到中度以上,但其中预期"大量使用"的只有 23%,预期把代理完全整合为核心运营组件的只有 5%(来源:同上)。从"用起来"到"变成核心",中间隔着两档,而支撑这两档跳跃的正是治理能力,没有实时监控和审计轨迹,多数企业只能停在低自主等级上。
另外一个容易被忽略的细节是调查口径本身:这份调查的执行时间是 2025 年 8 月到 9 月,覆盖 24 个国家的 3235 位 IT 与商业主管,全部直接参与本公司的 AI 项目(来源:同上)。也就是说,回答问题的人不是旁观者,是当事人。当事人自评的 21%,含金量比外部观察者的估计要更高一些。
Gartner 在 2026 年 5 月也给出了一个更硬的数字:到 2027 年,40% 的企业会降级或停用自主 AI 代理,原因是治理缺口直到生产事故之后才被发现(来源:Gartner 新闻稿《Applying Uniform Governance Across AI Agents Will Lead to Enterprise AI Agent Failure》,2026 年 5 月 26 日)。"直到事故之后才被发现"这几个字,正好解释了为什么治理欠账不会停在账面上,它最终会以一次具体事故的形式兑现。
采购的其实不是工具,是责任边界
把治理缺口代进采购场景,会看到一件被说反了的事。
企业内部立项时,常把代理当成软件采购:比功能清单、比并发数、比单次调用价格。但真正决定这个项目能不能上生产、能上到哪一档的,是另一组问题:出错之后谁签字、赔付怎么算、事故怎么复盘、日志保存在哪。
《FDE进企业,谁来背锅》里记了两位一线操盘手的说法:按结果收费的前提是结果的度量口径双方事先达成一致,而这恰恰是最难固化的环节;当前主流形态是混合制,产品订阅费打底,交付与陪跑服务费按阶段结算,效果指标写进验收而不写进计价(来源:笔记《FDE进企业,谁来背锅》,源势AI,2026-09-08)。
这篇笔记里的那句话值得抄进任何一份代理采购合同的首页:进场之前,风险清单和决策存档机制比商务条款更重要(同上)。签不签得下来,取决于"出错谁扛"有没有答案,而不是功能演示漂不漂亮。
把它落到采购动作上,就是三份文件要一起进合同。第一份是权限清单,逐项写明每个代理能读什么、能改什么,以及哪些动作属于不可逆。第二份是审批矩阵,说清每一档权限由谁批、批到什么程度、多久复核一次。第三份是事故响应条款,约定监测责任在谁、异常如何上报、回滚时限是多少。
这三份文件在投标阶段就会被拉开差距。多数供应商能提供功能清单和准确率指标,能提供这三份文件的很少。买方如果只在功能维度评标,最后拿到的就是一套跑得很快、但没人敢放开用的系统,它不会失败,只会停在试点。
《企业AI的三个关卡口》里举过一个真实的场景:一家金融企业的 AI 系统上线三个月,Agent 能调到不该调的数据库,工具凭证散落在五个团队手里,还有一次一个 Agent 把风控分析任务直接委派给了客服 Agent(来源:笔记《企业AI的三个关卡口》,源势AI,2026-08-16)。事后复盘,这三个问题都不是模型能力问题,都是权限和凭证管理问题。
图注:合同上最贵的不是价格那一栏,是没人愿意签字的那一栏
拦不住,不是因为没写制度
一个容易被误读的结论是:治理做不好,是因为企业不重视。
Gartner 在 2026 年 9 月 21 日的新闻稿里给了另一组数据。这家机构 2026 年 3 月调查了 223 位数据与分析负责人,结果显示:文化阻力超过资金约束,成为治理举措失败的首要原因,比例是 60% 对 40%(来源:Gartner 新闻稿,2026 年 9 月 21 日,孟买,n=223)。同一份新闻稿给出预测:到 2027 年,60% 没有解决数据与分析治理相关文化挑战的组织,将无法成功地治理 AI(同上)。
Gartner 的总监分析师 Anurag Raj 在孟买的峰会上把话说得很直:很多组织仍然聚焦于制定政策和引入技术,却忽略了政策能否被规模化、持续执行的文化前提;没有数据驱动文化的治理,是一场徒劳(同上)。
这句话解释了为什么"制度都写了"和"实际拦得住"是两件事。治理文档描述的是意图,它不定义决策边界、不设升级阈值、也不给自主行为设经济损失上限。文档能通过审计,运行时不一定能拦住任何一次越权。
权限闸门要装在模型外面
治理这件事真正落到工程上,就变成一个问题:代理的权限由谁裁决。
《多智能体LLM系统的身份、授权与运行时治理差距分析》这篇论文给了一个可以直接采用的判据:代理安全必须在"模型不可信"的前提下评估,一个完全被提示注入的代理,仍然不能超越显式授予它的权限,这样的系统才算正确(来源:arXiv 论文 2609.00267《Delegation Without Trust》,VotalAI,2026 年 8 月 31 日,笔记路径 研究报告/07-突出论文/20260904_2609.00267_Delegation_Without_Trust_An_Empirical_Gap_Analysis_of_Identi.md)。
作者做了两组对照。先看现状:以常见框架实践建模的默认代理运行时:宽泛的 bearer 凭证、授权判断放在模型内部,在四类威胁上全部失守;LangGraph、CrewAI、AutoGen 和 MCP 的授权模型里,三个没有内置隔离,一个只有部分隔离,且没有任何单一标准能覆盖全部八项安全要求(同上)。
再看对策。作者实现的授权 broker 把四类威胁全部阻断,抵御了针对它本身的 11 种直接攻击,20 万个伪造令牌的接受率为 0,并把受损子代理可达的操作从 8100 个限制到平均 1.5 个(2000 个随机场景),单次决策开销约 2.6 微秒(同上)。
最后这个数字才是关键:2.6 微秒相对模型推理时间可以忽略。拦不住的常见借口是"加权限校验会拖慢系统",这篇论文把这条借口关掉了。授权裁决放在模型外面,成本几乎为零。
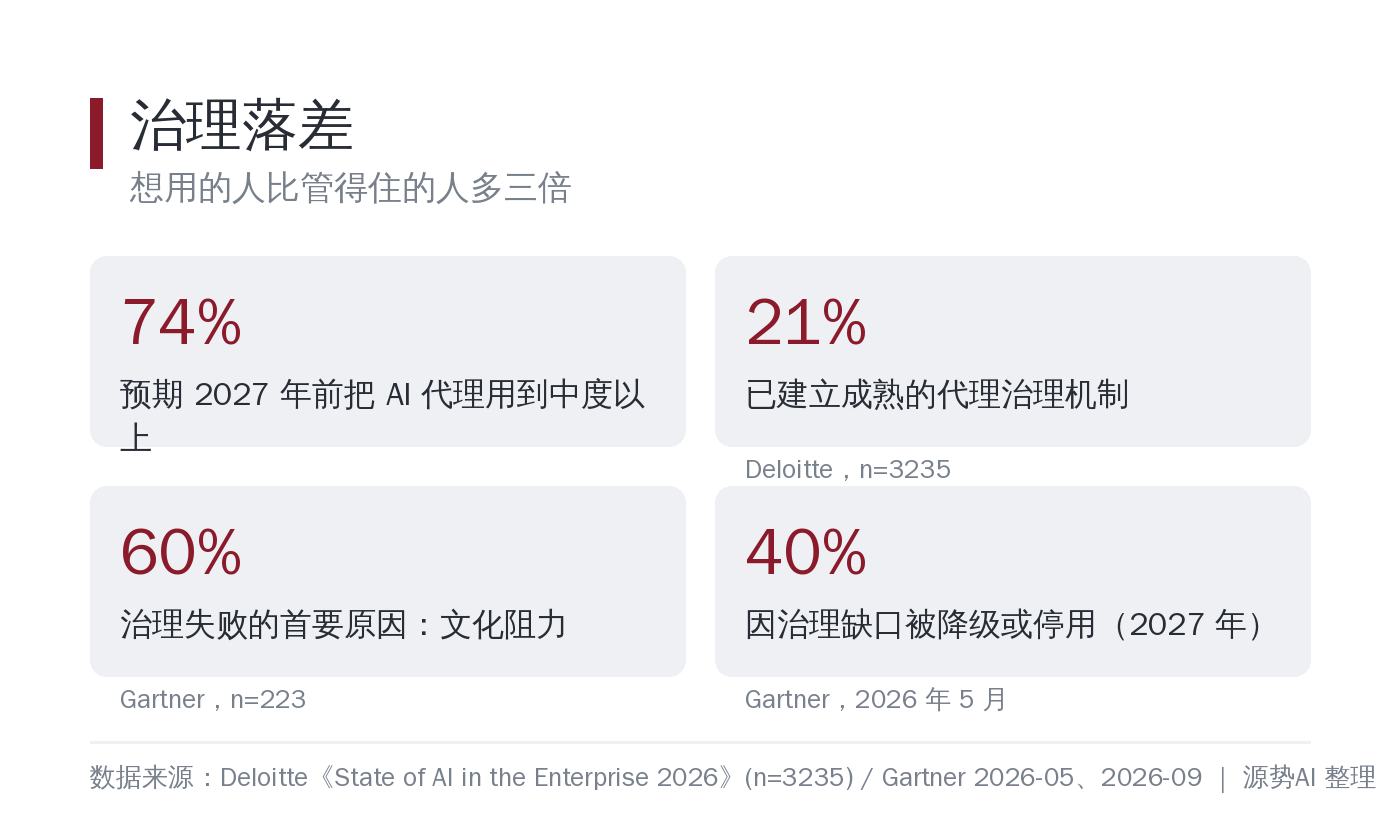
图注:预计要用的人有 74%,说得出自己怎么管的人只有 21%
三道关卡,先装哪一道
《企业AI的三个关卡口》整理过一套分法,到今天仍然适用:模型网关管推理,工具网关管外部能力,智能体网关管跨代理协作(来源:笔记《企业AI的三个关卡口》,源势AI,2026-08-16)。
如果企业只来得及装一道,先装工具网关。理由很实际:代理造成不可逆后果的动作,绝大多数发生在调用外部能力的这一步:改数据库、发消息、动配置。模型网关管的是钱和路由,智能体网关管的是协作效率,只有工具网关直接对着"代理能改变什么状态"这个边界。
装了之后还要给每个工具挂上四样东西:能做什么、不能做什么、谁批准、出事怎么回滚。四样齐了,一次越权才会变成一个可被记录的异常,而不是一次没人说得清的意外。
源势AI观点
我们在客户现场看到的典型顺序是倒的:先上代理、先看效果、出了问题再补治理。这个顺序看起来快,实际上把项目最脆弱的那段时间暴露在外面,前三个月是代理行为最不可预测的阶段,最难拦住的事故也恰好集中在这里。
我们的做法是把治理当成交付物的一部分,而不是上线后的运维项。每个项目进场时固定产出三份东西:一份按自主等级分类的代理清单,说清每个代理能读到什么、能改什么;一套工具网关的策略文件,把审批、限流、回滚写成可执行配置;一份决策存档机制,记录每一次权限变更的依据和时间。这三份东西客户拿走就能用,不绑定我们。
还有一条经验:不要一次给到最高自主等级。先用"建议"档跑通业务,把输出质量摸清楚;再进"批准执行"档,看审批流在真实节奏下会不会退化成走过场;只有前两档都稳定,才考虑放开某几个边界清晰的动作。上线速度慢一到两个月,换回来的是出事时能说得清。
拦住风险的能力,决定了放开手脚的上限。这句话在代理项目上比在任何技术栈上都成立。
话题标签:#Agent治理 #责任边界 #自主等级
