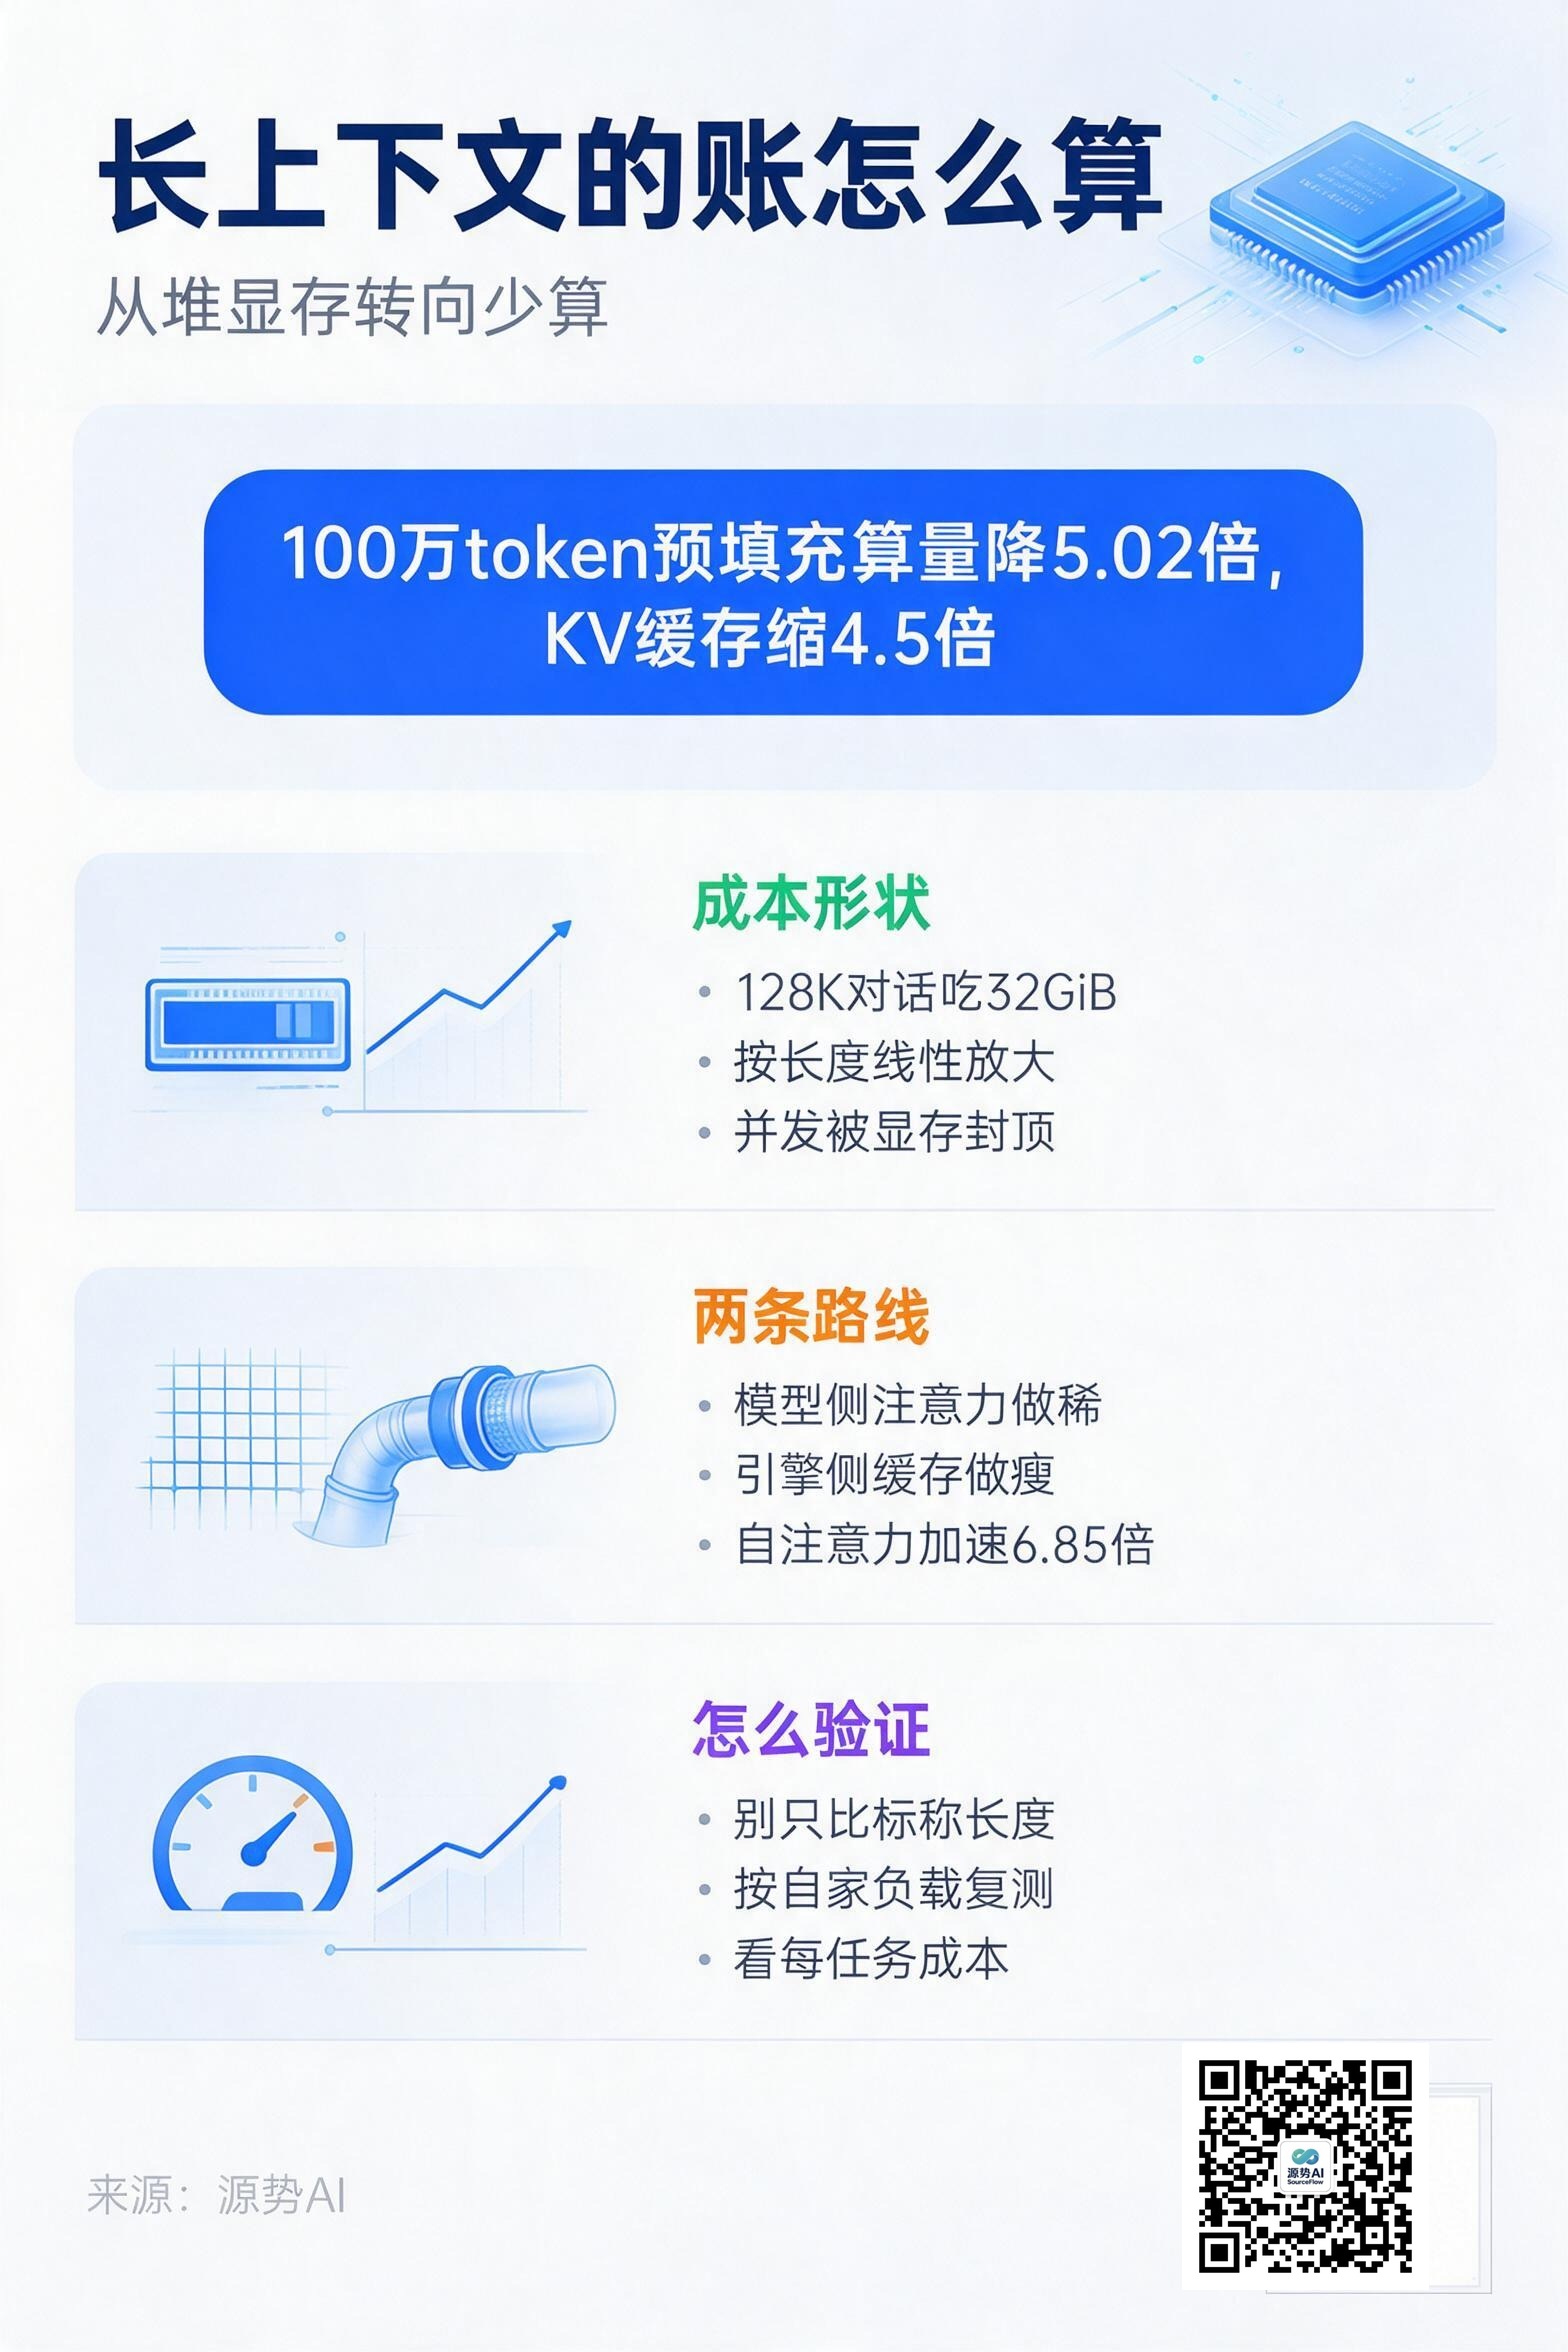
9 月 24 日,小米 18 Pro 系列发布次日,MiMo 团队公布大模型 V3 将换用新架构,并给出 HySparse 2 的一组数字:在 100 万 Token 长度下,预填充计算量降低 5.02 倍、KV 缓存缩小 4.5 倍;同场放出的还有 MiMo-V2.6-Pro 与 Flash 的训练明细——两款模型各完成 30 个训练 Step、累计约 75 万条训练轨迹(来源:科创板日报,2026-09-24)。
口径先说清楚:5.02 倍与 4.5 倍是小米自报的架构级优化数据,官方没有披露对照基线与序列长度分布,也没有说端到端时延会怎么变(来源:同上)。
但这组数指向的方向,和过去半年推理侧的主线一致:长上下文的成本,正在从"堆显存"转向"少算"。
显存税是按长度线性涨的
一条 128K token 的长对话,在 Qwen3-32B 上光 KV 缓存就要吃掉约 32 GiB 显存,比模型权重的零头还金贵。这笔开销按对话长度和并发数线性放大,没有上限(来源:《长上下文,正在收显存税》,源势AI,2026-08-28)。
显存被 KV 挤占之后,同一张卡能并发的人数掉下来,解码吞吐直接封顶。推理服务商最怕的账单就是这个形状:客户上一份百页合同,KV 涨四倍,能伺候的人掉四倍,单价没变。
这笔账还有另一半:显存不够时,请求会被排队或截断,用户在客户端看到的只是"变慢",服务商看到的却是质量投诉。长上下文的成本从来不是单点的,它同时压在显存、带宽和调度三本账上。
图注:丢 token、降精度、降维度——模型侧把注意力做稀,引擎侧把缓存做瘦,两条腿要一起动
引擎侧:把读不回来的块先读准
9 月 25 日入档的 CompKV 给了一条更细的路子。传统稀疏注意力先按注意力质量选块、再做均值补偿,两步互不通气;CompKV 把补偿残差拆成块注意力质量与块内 logit 变化两项,用紧凑统计量排序,优先精确读取那些"难以重建"的块,其余块才用均值摘要代替(来源:arXiv:2609.26300)。
在 Llama-3.1-8B-Instruct、Qwen3-8B 与 Qwen3-32B 上,它在 RULER 和 LongBench-Pro 的平均分高于所对比的稀疏基线;H100 上 32K 到 128K 上下文、512 到 2048 token 预算的九种组合里解码步延迟最低,自注意力相对全注意力最高加速 6.85 倍(来源:同上)。
更早的 PuzzleKV 走另一条腿:把 KV 页当压缩单元做页内低秩分解,用约 60% 的原始存储保住 Full KV 96% 以上的性能;再叠加因子级对称 INT4 量化,存储压到 18.7%,性能守住 93% 以上(来源:arXiv:2608.23843)。
模型侧做稀疏,引擎侧做瘦身,两边的钱一起省才省得下来。
架构端各家已经在动手:Qwen3.8-Flash-Next 用稀疏注意力压长序列成本、原生 262K 上下文,GLM-5.3-Flash 上了稀疏与线性注意力的混合设计(来源:《长上下文,正在收显存税》,源势AI,2026-08-28)。两条路的分工很清楚——前者从训练阶段就把注意力做稀,要等下一代模型;后者在不重训的前提下把已有模型的缓存做瘦,今天就能上线。
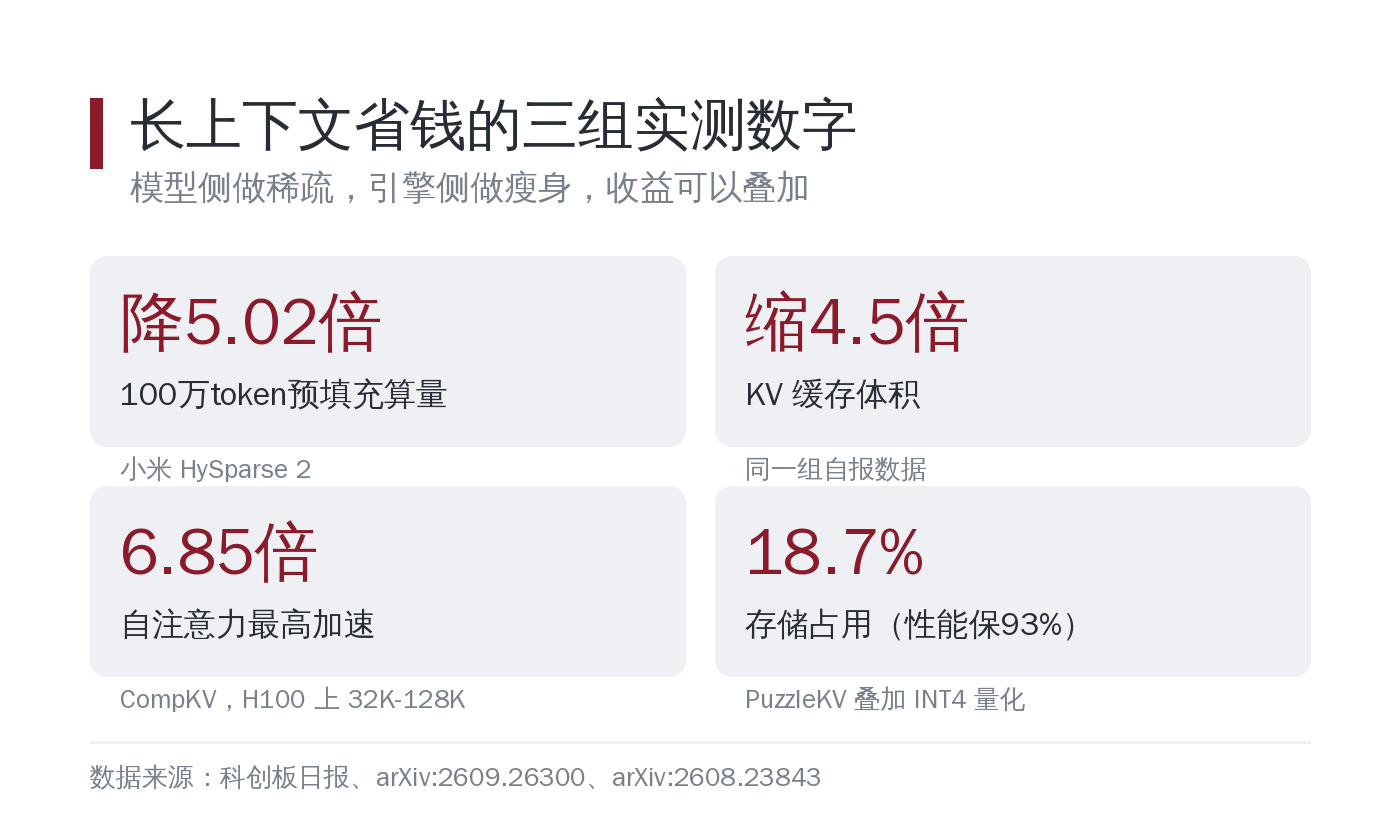
图注:稀疏选择、页内低秩、低比特量化各管一段,可叠加使用,收益要按自家负载复测
省下来的算量,会先去哪儿
对做 Token 生意的人来说,这些优化最终体现在两处:显存里多出来的会话数,和下一轮降价里的单位成本。
国内五款开源旗舰的横评已经显示,同样标称 1M 上下文,输出价格能差 22 倍——差异大半不在参数表里,在 KV 管理与缓存复用的工程水位上(来源:《五款国产开源大模型旗舰横评:同样的 1M 上下文,输出价差 22 倍》,InfraBloom,2026-09-10)。
所以小米这组数字的意义不在"我们也能做 100 万上下文",而在于架构级省下来的算量,会先落到自家终端与自家推理服务的账单上。
对小团队来说,更实际的顺序是先在引擎侧拿收益:换一个支持页式管理的推理框架、打开前缀缓存、按显存而不是按卡数排并发,这些改动当天就能测出效果。架构级的稀疏要等模型换代,引擎级的瘦身不用等。
判断顺序其实可以简化成两步:先看自己的上下文长度分布落在哪一段——如果九成请求都在 8K 以内,长上下文优化的收益和你关系不大;再看并发形态是长驻对话还是短问答,前者吃显存、后者吃算力,两条路径省下的钱完全不同。
源势AI观点
第一,选型别再只比标称上下文长度。同一个 128K 任务,不同供应商的完成成本能差出数倍;跑一个真实长文负载看首 token 时延和每任务成本,比看参数表有用。
第二,稀疏化的收益要按自家负载复测。5.02 倍是长度前沿的架构级数字,你的平均序列长度可能只有几万,收益要打折;上线前用真实流量分布测一遍。
第三,省下来的显存就是产能。KV 每瘦一格,同一张卡上能多挂一个会话,这部分收益不会自动变成降价,但一定会变成服务商的毛利空间——采购时把它写进议价依据。
参考材料
- 科创板日报《小米 MiMo-V3 换用 HySparse 2 新架构》,2026-09-24
- arXiv:2609.26300《CompKV: Compensation-Aware KV Selection for Long-Context LLM Inference》
- arXiv:2608.23843《PuzzleKV: Page-Wise Low-Rank Decomposition for KV Cache》
- 源势AI《长上下文,正在收显存税》,2026-08-28
- InfraBloom《五款国产开源大模型旗舰横评:同样的 1M 上下文,输出价差 22 倍》,2026-09-10
话题标签:#长上下文 #KV缓存 #推理成本
