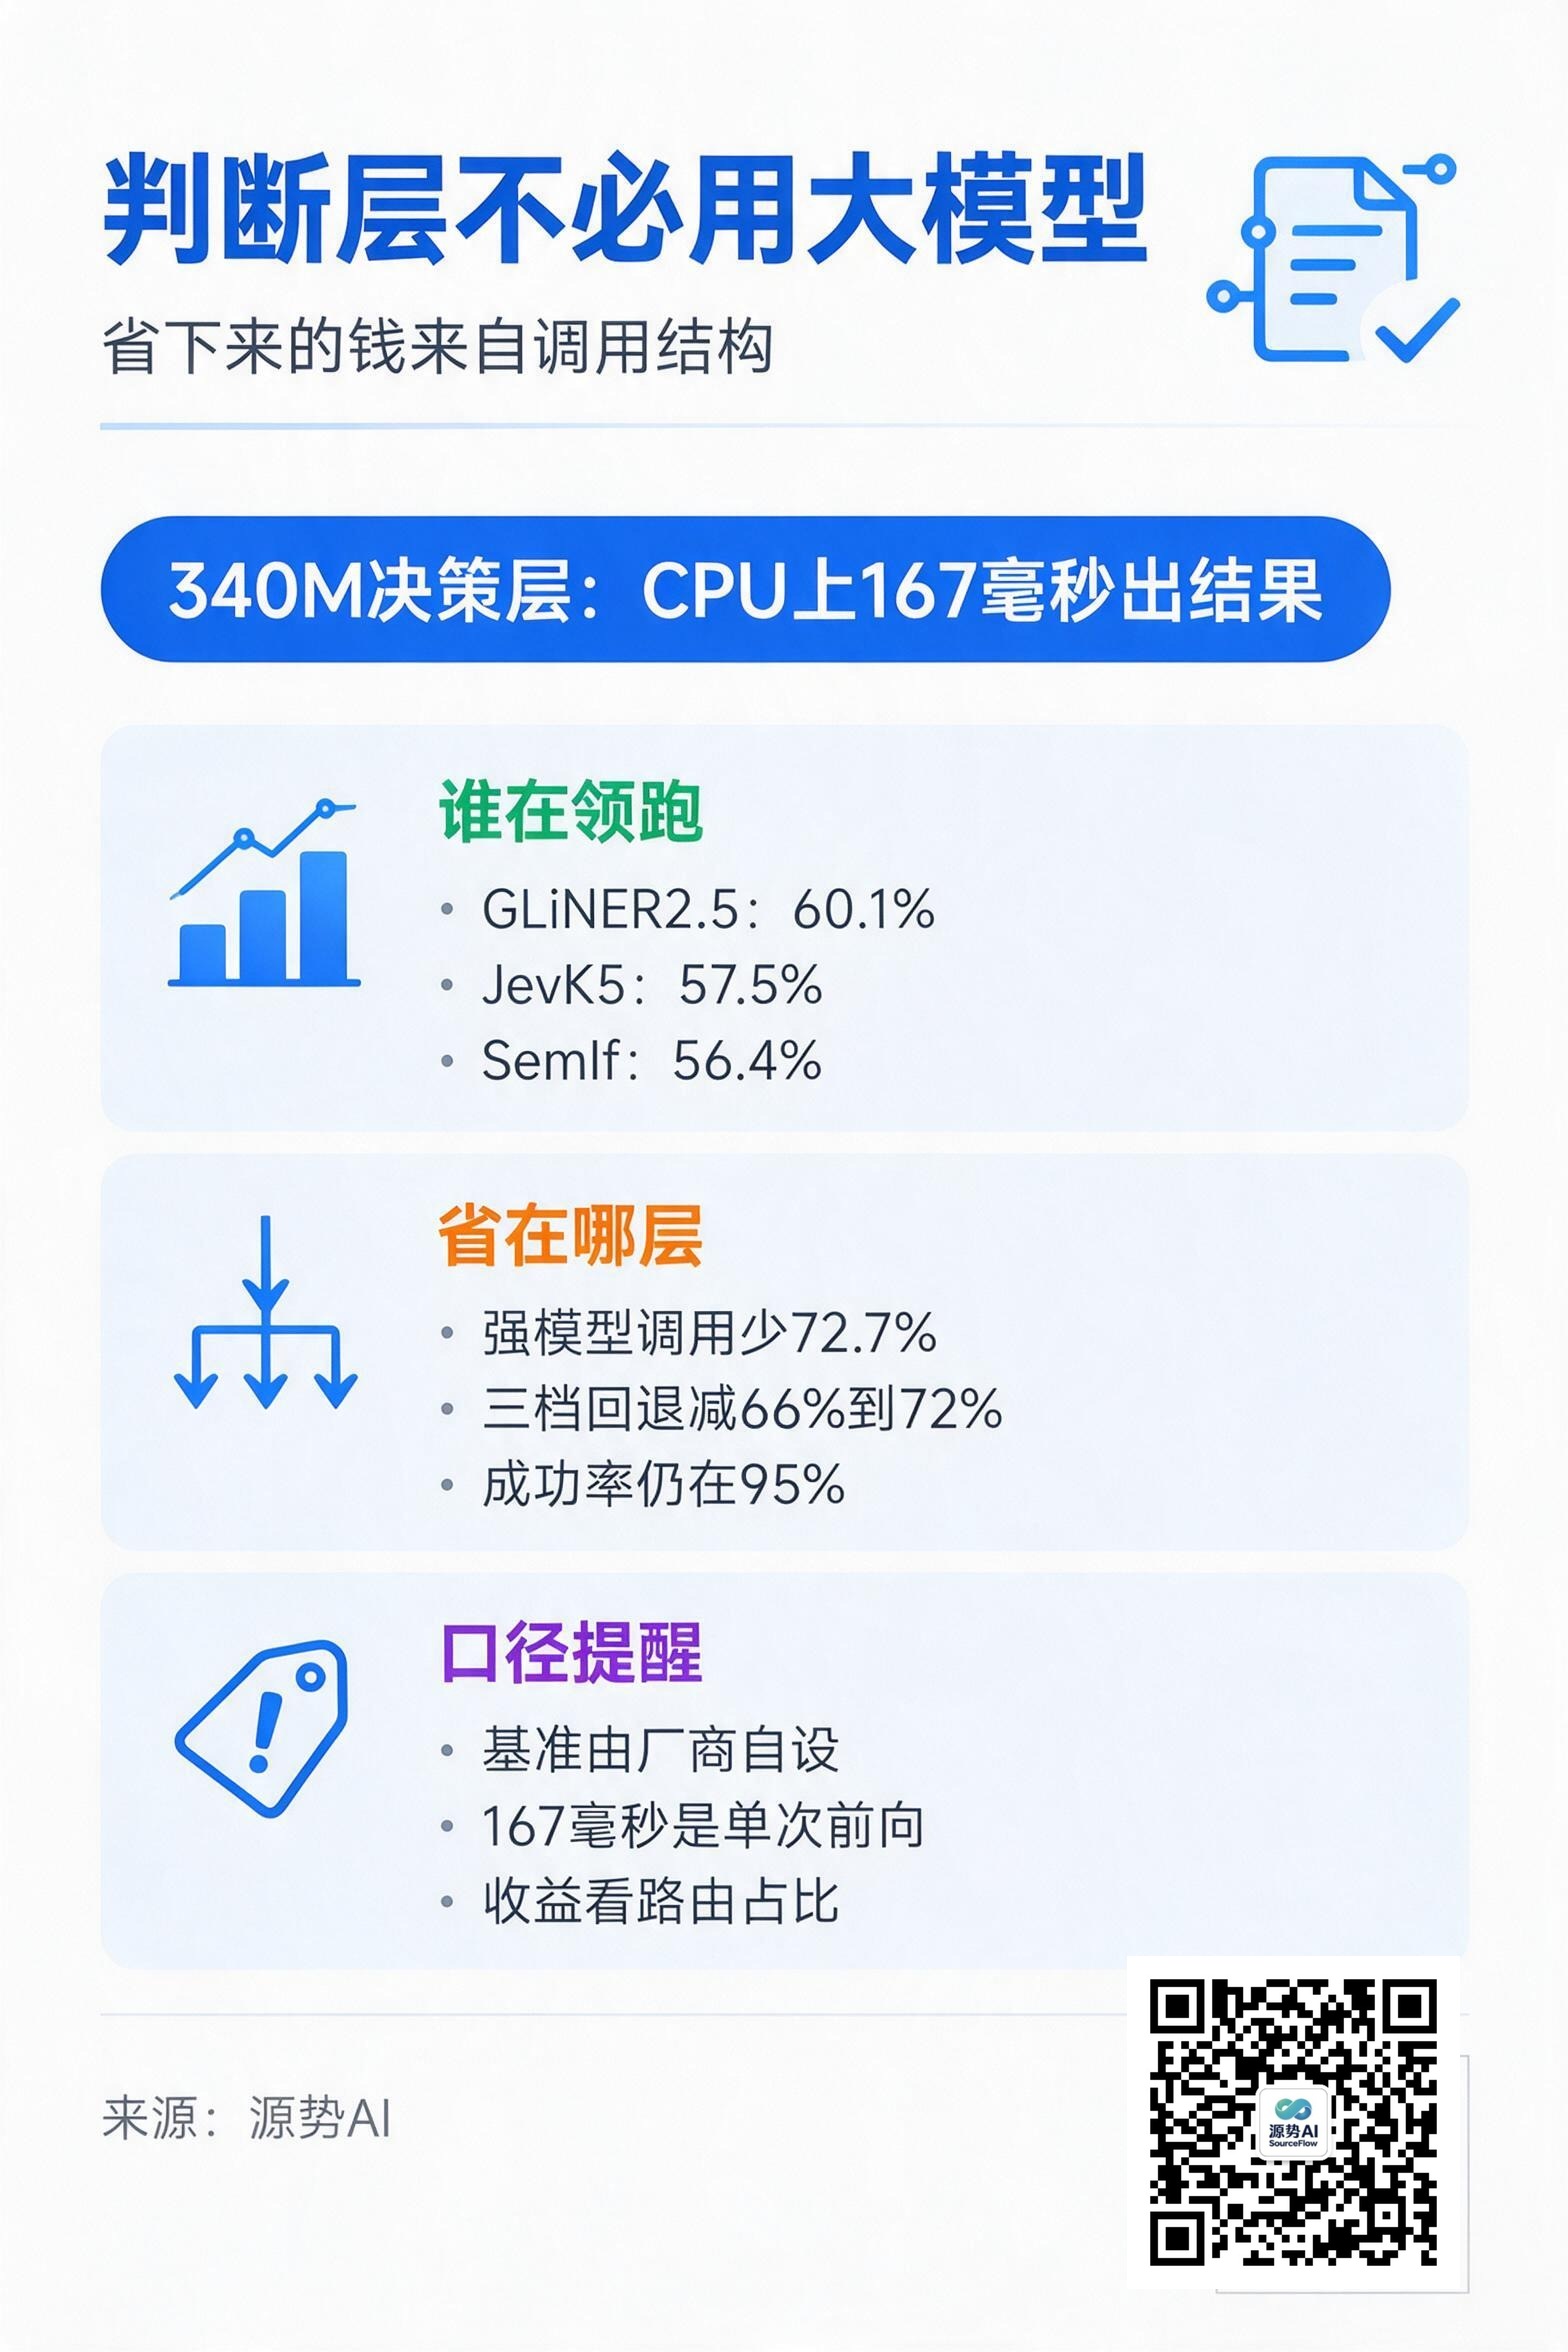
Fastino Labs 在 9 月发布并开源了 GLiNER2.5-Decide:340M 参数,Apache 2.0 许可,专为 Agent 管道设计的编码器决策模型。它的定位很窄——不做推理、不写内容,只负责单次前向里同时完成意图识别、路由决策和护栏检查,并能用约束规则处理标签之间的矛盾(来源:钛媒体,2026-09-26)。
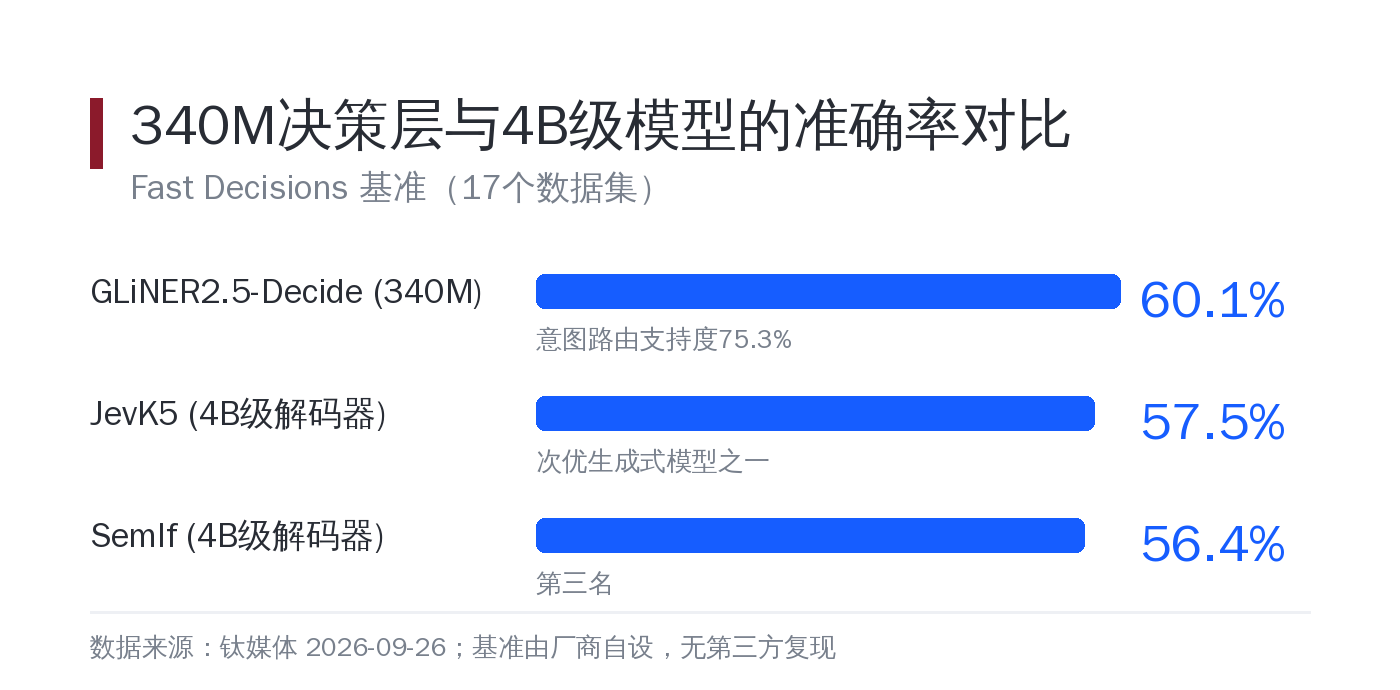
配套的测试数据是这家公司自己给的:在覆盖 17 个数据集的 Fast Decisions 基准上,它以 60.1% 的精确匹配准确率领先 4B 级解码器模型(JevK5 为 57.5%,SemIf 为 56.4%);在更高频的意图路由场景,意图分类支持度 75.3%,比次优模型高出 18.6 个百分点。部署侧,纯 CPU 推理延迟 167.3ms(64 token),GPU 上降到 38 到 47ms(来源:同上)。
340M 打败 4B,如果只看参数量,这是个反常结论。但放到 Agent 管道的上下文里,它其实很合理。
判断这件事,本来不需要大模型
Agent 轨迹里的大量步骤不是开放式推理,而是有界决策:这次调用走哪条链路、要不要触发护栏、参数该填哪个模板。这类动作的答案空间是有限的,选项就那么几个。
南洋理工大学的研究者把这个问题单独拆出来做过实验。他们的方案 REFLEX 用一个类型化快决策层处理这类有界选择,返回选项加置信度:置信度高就直接执行,置信度低或需要自由生成的步骤才交给强 LLM。在冻结的 100 任务基准上,成功率达到 95%,强模型调用量比纯强模型方案减少 72.7%;换成 Qwen3.8-Max、Kimi K3、DeepSeek-V4-Pro 三种回退模型,调用减少 66% 到 72%,成功率都落在 2 分的非劣边界内(来源:arXiv:2609.26532)。
值得注意的是同一篇论文里给出的边界条件:在 BFCL 这类外部评测上,专用判定层相对廉价生成式级联的优势有限。研究者自己的解释是,收益来自决策空间的结构,而不是模型更小这件事本身——动作集够大、授权边界附近存在近似有效的备选时,小模型才占便宜。
这句话值得抄下来贴到选型文档里。它把"用小模型省钱"从一句口号,变成了一个可以事先判断适用性的条件。
图注:判断层只做分流,不做推理——多数调用进入成本更低的小通道,少数难题才交给强模型
小模型能变强,而不是只能分流
业内更常见的做法是把小模型当分诊台:简单的给它,难的给大模型。小模型自己的能力始终不变,路由只是把账算得更精。
MERA 换了思路。它以单次模型调用为适配单元,每一轮把学生模型失败的调用重放给教师模型,拿到经过执行验证的示范,蒸馏成可复用的技能写进技能手册,再用监督学习和 GRPO 微调学生的 LoRA 适配器。在 HumanEval 与 MBPP 上,经过四轮适配的 Qwen2.5-Coder-1.5B 通过率从 28.7% 提升到 49.7%;配套的部署策略在保持 88.3% 通过率的同时,把成本降到原来的 60.8%(来源:arXiv:2608.10333)。
它有两个设计细节,做过 Agent 的人都该看一眼。一是路由器被刻意做成"输入隔离":只看调用内容本身判断难度,不依赖 Agent 内部隐藏状态,避免内部状态漂移把判断带偏。二是候选的技能手册、适配器、路由必须联合重放测试、不伤任务质量才准入,三件套作为一个整体验收,不搞单项指标达标就上线(来源:源势AI《省Token的尽头是养小模型》,2026-08-31)。
账单是拆出来的,不是砍出来的
行业侧的经验数值可以做个对照。一份 2026 年的 Agent 技术栈选型梳理给出的分布是:成熟的 Agent 系统普遍采用混合模型架构,调度器自动识别请求复杂度后,约 80% 的简单任务分发给轻量化蒸馏模型,只有 20% 的高难度推理调用前沿大模型(来源:《Agent技术栈选型浅析》2026 年版梳理)。
图注:判断层的调用频次远高于推理层,单次成本降下来之后,摊到总账单上的效果比换主模型更明显
这三个来源指向同一个操作路径:先把管道里的调用按性质分类,再把"有界决策"这一类整体挪出去。跳过分拆、直接换更便宜的主模型,通常换来的是一次性降配,而不是结构性降本。
口径上也要收紧一点。Fast Decisions 基准由 Fastino 自设,测试集构造与判定口径没有第三方复现;167.3ms 是单次前向的实验室数据,不含服务化与批处理开销;340M 也只承担"做判断"这一层,管道端到端的收益取决于路由类调用在总请求中的占比(来源:钛媒体,2026-09-26)。把这三条记住,就不会拿一个漂亮数字去说服预算会。
源势AI观点
第一,先给自家管道做一次调用普查。按频次排一遍,看有多少调用属于路由、参数拼装、格式化和护栏检查。这一层通常占总调用数的多数,却几乎不消耗推理能力——它是账单里最容易摘出来的一块。
第二,小模型要配离线的验证闭环,不能只做在线分流。MERA 的做法是把失败的调用重放、验证、蒸馏,技能与适配器一起验收。少了这一步,判断层省下的钱会被放大后的返工成本吃掉。
第三,验收标准要自己定。厂商自设基准可以看趋势,不能当验收线。对客户交付时,我们更看重的是:在同一套真实流量上,判断层的错误率是否可控,兜底路径是否真的能接住。
判断层用 340M 就够,这个结论真正的含义不是"小模型很强",而是 Agent 的账单里有相当一部分花在了不需要推理的地方。
参考材料
- 钛媒体《Fastino 开源 340M 决策模型:CPU 上 167ms》,2026-09-26
- arXiv:2609.26532《REFLEX with Jev for Efficient Selective Control in LLM Agents》
- arXiv:2608.10333《MERA: Skill Adaptation for Agentic Systems》
- 源势AI《省Token的尽头是养小模型》,2026-08-31
话题标签:#小模型 #路由决策 #Agent成本
