把大模型压到 4 比特,性能基本保住了。但有一样东西,一起被压了下去。
10 月 3 日的 arXiv 论文速递收录 8 篇论文,主题是"量化压缩与边缘高效推理",其中 4 篇围着权重量化打转。它们给出一个共同的结论:低位宽已经不再是实验室玩具,而是端侧部署的默认选项。但其中一篇专门研究了一个不常被提及的代价。
压到4bit,性能基本保住了
先看好消息。
多伦多大学与麦克马斯特大学的团队系统评估了 4 比特量化与 QLoRA 低秩适配在蛋白语言模型上的表现,覆盖 ESM-2、ESMC、ProtBERT、ProtT5、Ankh、Ankh3、Profluent-E1 等模型:多数下游预测任务保留了全量微调 90% 以上的性能,最大模型的峰值显存节省接近 90%(来源:arXiv:2610.00665《Analysis of Quantized and Efficiently Adapted Protein Language Models》,2026-10-03)。
换句话说,一个原本需要大显存才能跑的生物模型,压完之后精度只掉不到一成,显存省掉近九成。对算力预算有限的实验室,这是实打实的降本。
能耗上也有同类结论。MIT 与杜克大学的 AIR-LLM 干脆把权重"搬到空中":不让边缘设备存储和加载权重,而是由中心无线电(如 5G 基站)把 LLM 权重广播出去,边缘端在射频域直接完成矩阵-向量乘。在 LLaMA-3.1-8B 上,WikiText-2 困惑度只退化 4.0%,能耗较 FP16 与权重量化基线分别省 157.7 倍与 40.4 倍(来源:arXiv:2610.00465《AIR-LLM》,2026-10-03)。
联邦微调这条线也在被压缩。哈利法大学等团队的 FedFit 用共享向量库参数化重构低秩适配矩阵,在 Qwen2.5 上困惑度与标准联邦 LoRA 相当,但通信量只有后者的 1% 到 3%,压缩比最高提升 100 倍(来源:arXiv:2610.01537《FedFit》,2026-10-03)。
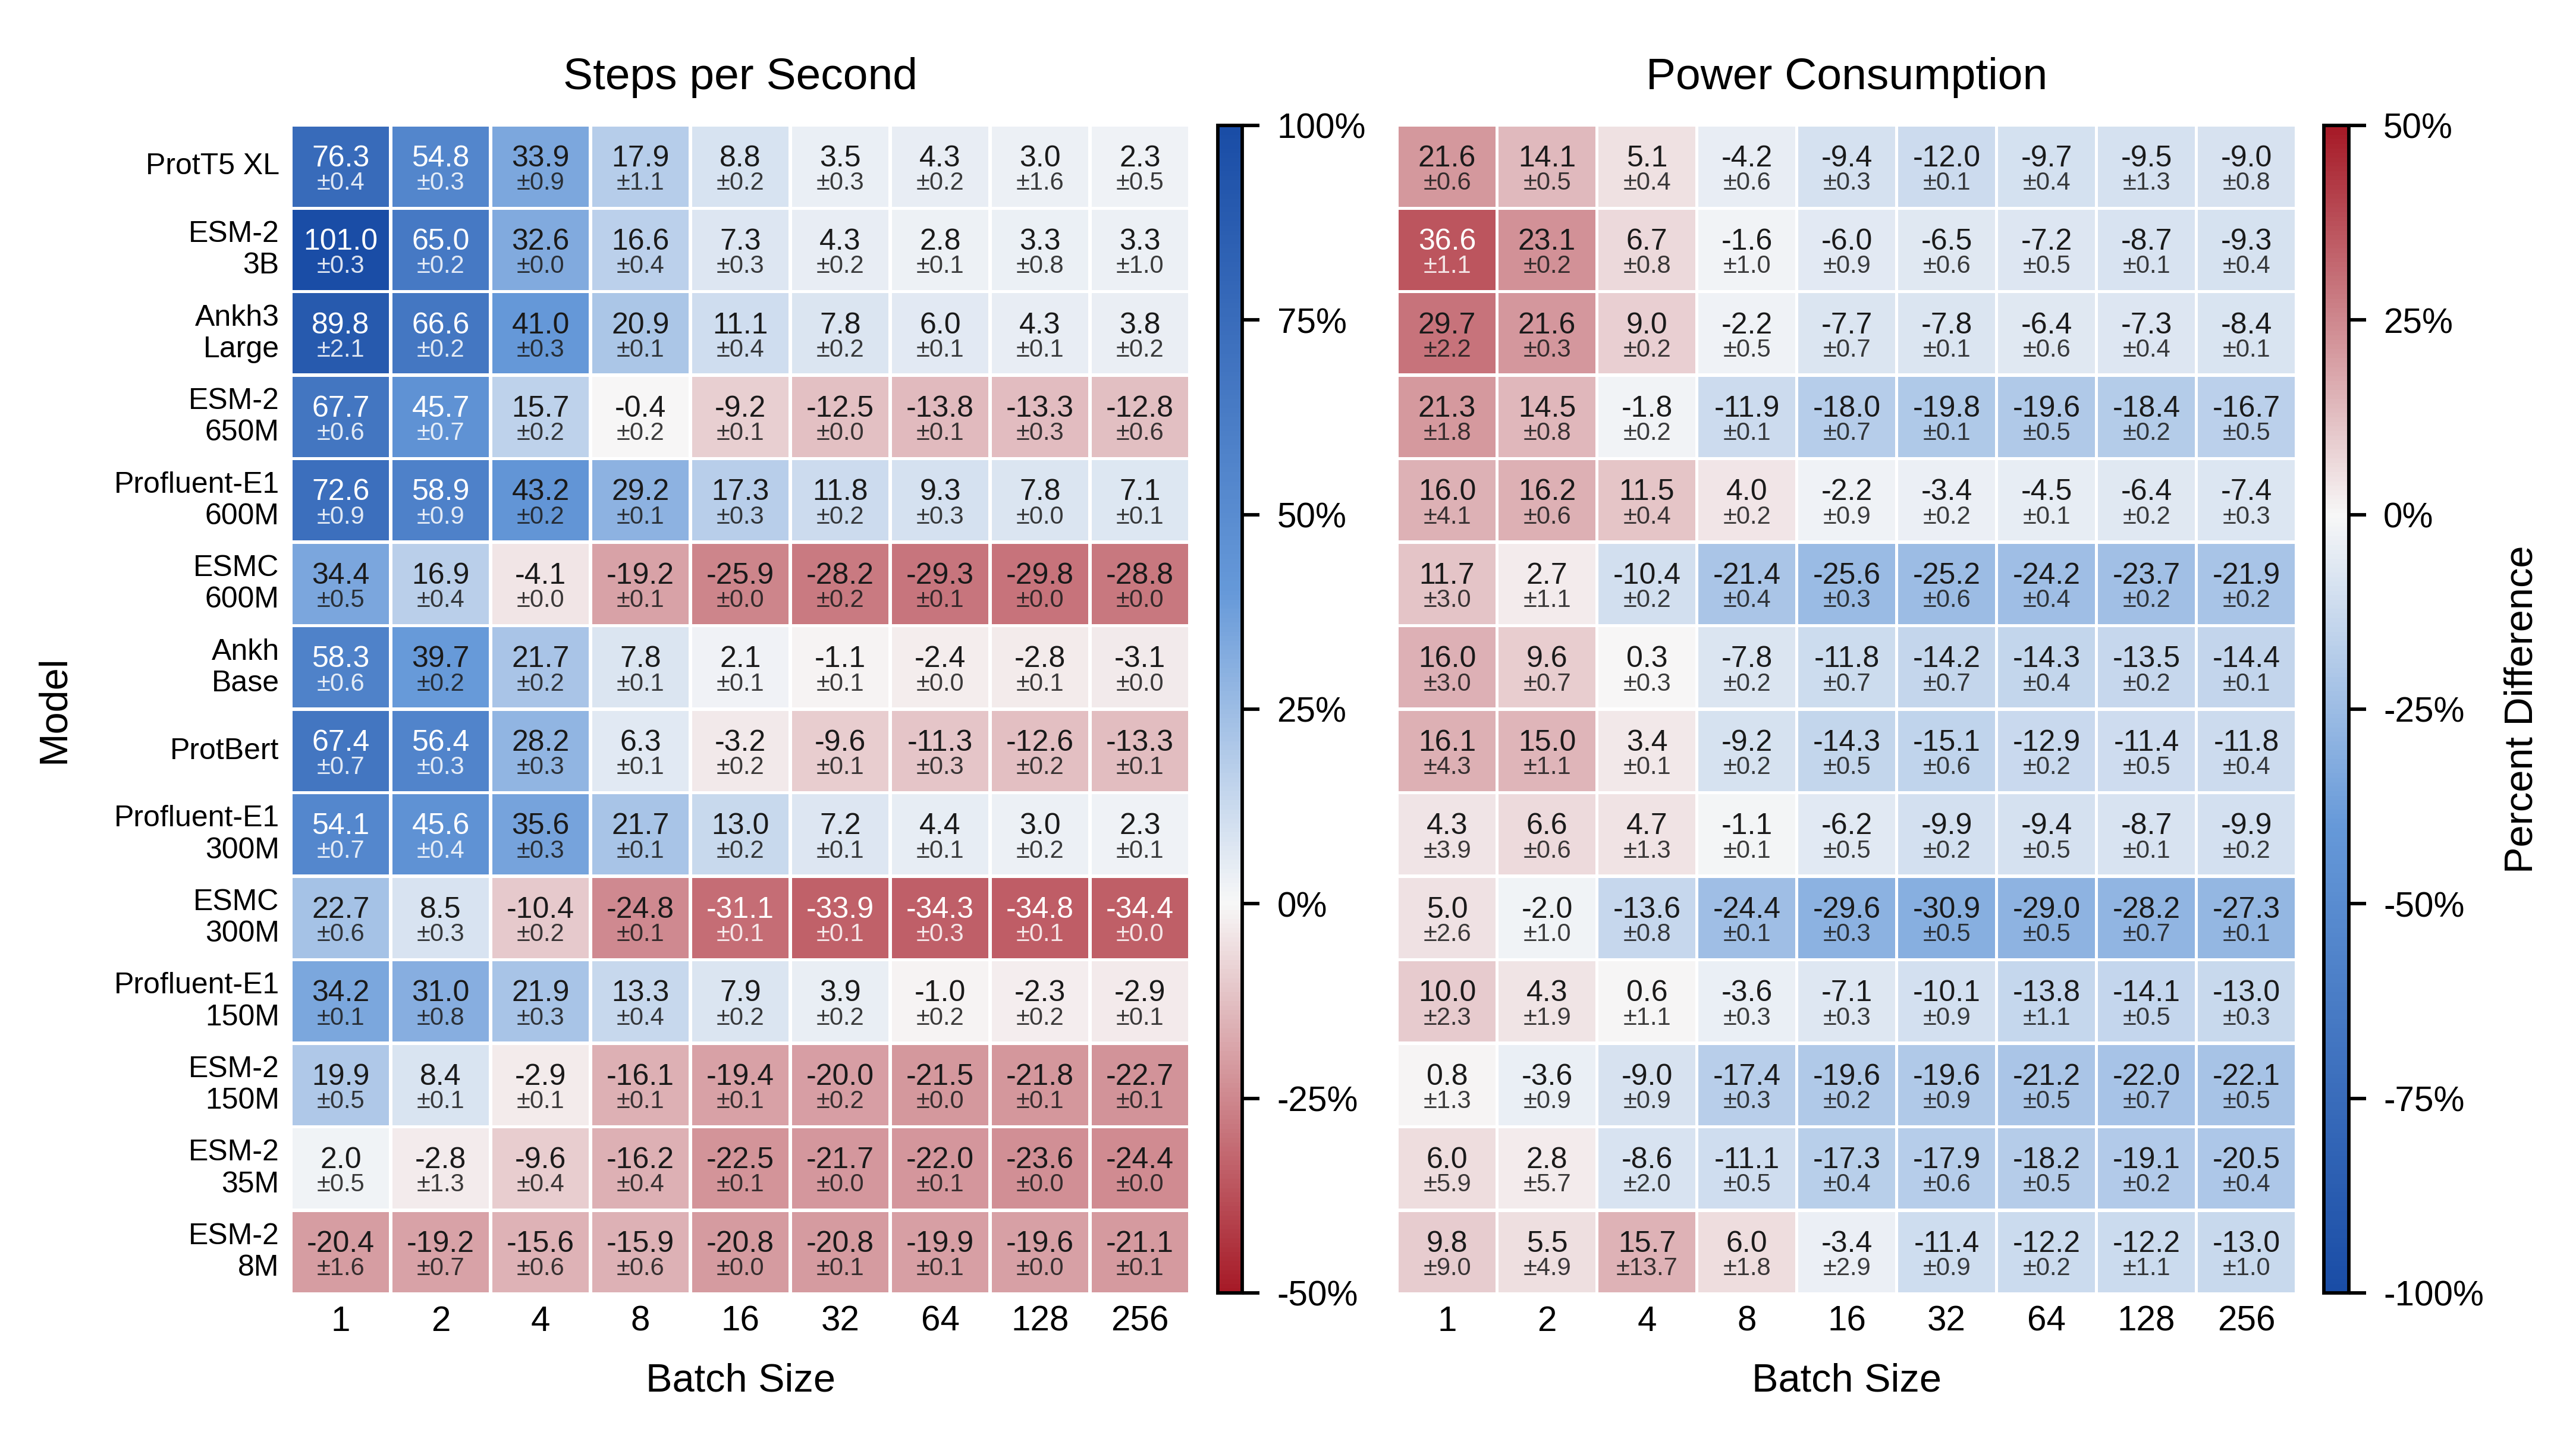
图注:4 比特量化与 QLoRA 让多数蛋白预测任务保留全量微调 90% 以上的性能,最大模型峰值显存节省接近 90%——精度与显存的取舍,在多数任务上已经划得来(数据来源:arXiv:2610.00665《Analysis of Quantized and Efficiently Adapted Protein Language Models》,2026-10-03)
但安全对齐,一起被压下去了
问题出在另一面。
肯恩大学、圣母大学等团队的 MOMAT 论文点破了一件事:量化 LLM 的对齐防护会被削弱,从而更容易被越狱攻击(来源:arXiv:2610.01058《MOMAT》,2026-10-03)。
论文给了一个可核查的性能对照:用存内计算(CiM)相似度引擎加速的域局部化 RAG 防护,把 100 条查询批次的处理时间从 15052.44 毫秒降到 3207.21 纳秒,能耗从 8.1×10⁷ 微焦降到 3.32 微焦,较树莓派 DRAM 基线能效提升约 2.5×10⁵ 倍,防御效果与当时最优方案相当(来源:同上)。
这些数字说明的是另一件事:防护本身也需要成本。一个原本可以靠完整精度模型扛住的越狱攻击,量化之后得额外加一道检索防护、还得配专用硬件才能做到低功耗。省下来的那部分显存和能耗,相当一部分又被安全防线吃回去了。
蛋白模型那篇也留了一个提醒:4 比特量化基本保持了生成式模型的结构与序列性质,但 token 级分布出现模型相关偏移,提示生成任务需要补做分布层面的分析(来源:arXiv:2610.00665,2026-10-03)。也就是说,指标层面的"精度没掉",不等于行为层面的"没有变化"。
精度和安全,在量化这条路上不是同一根尺子。
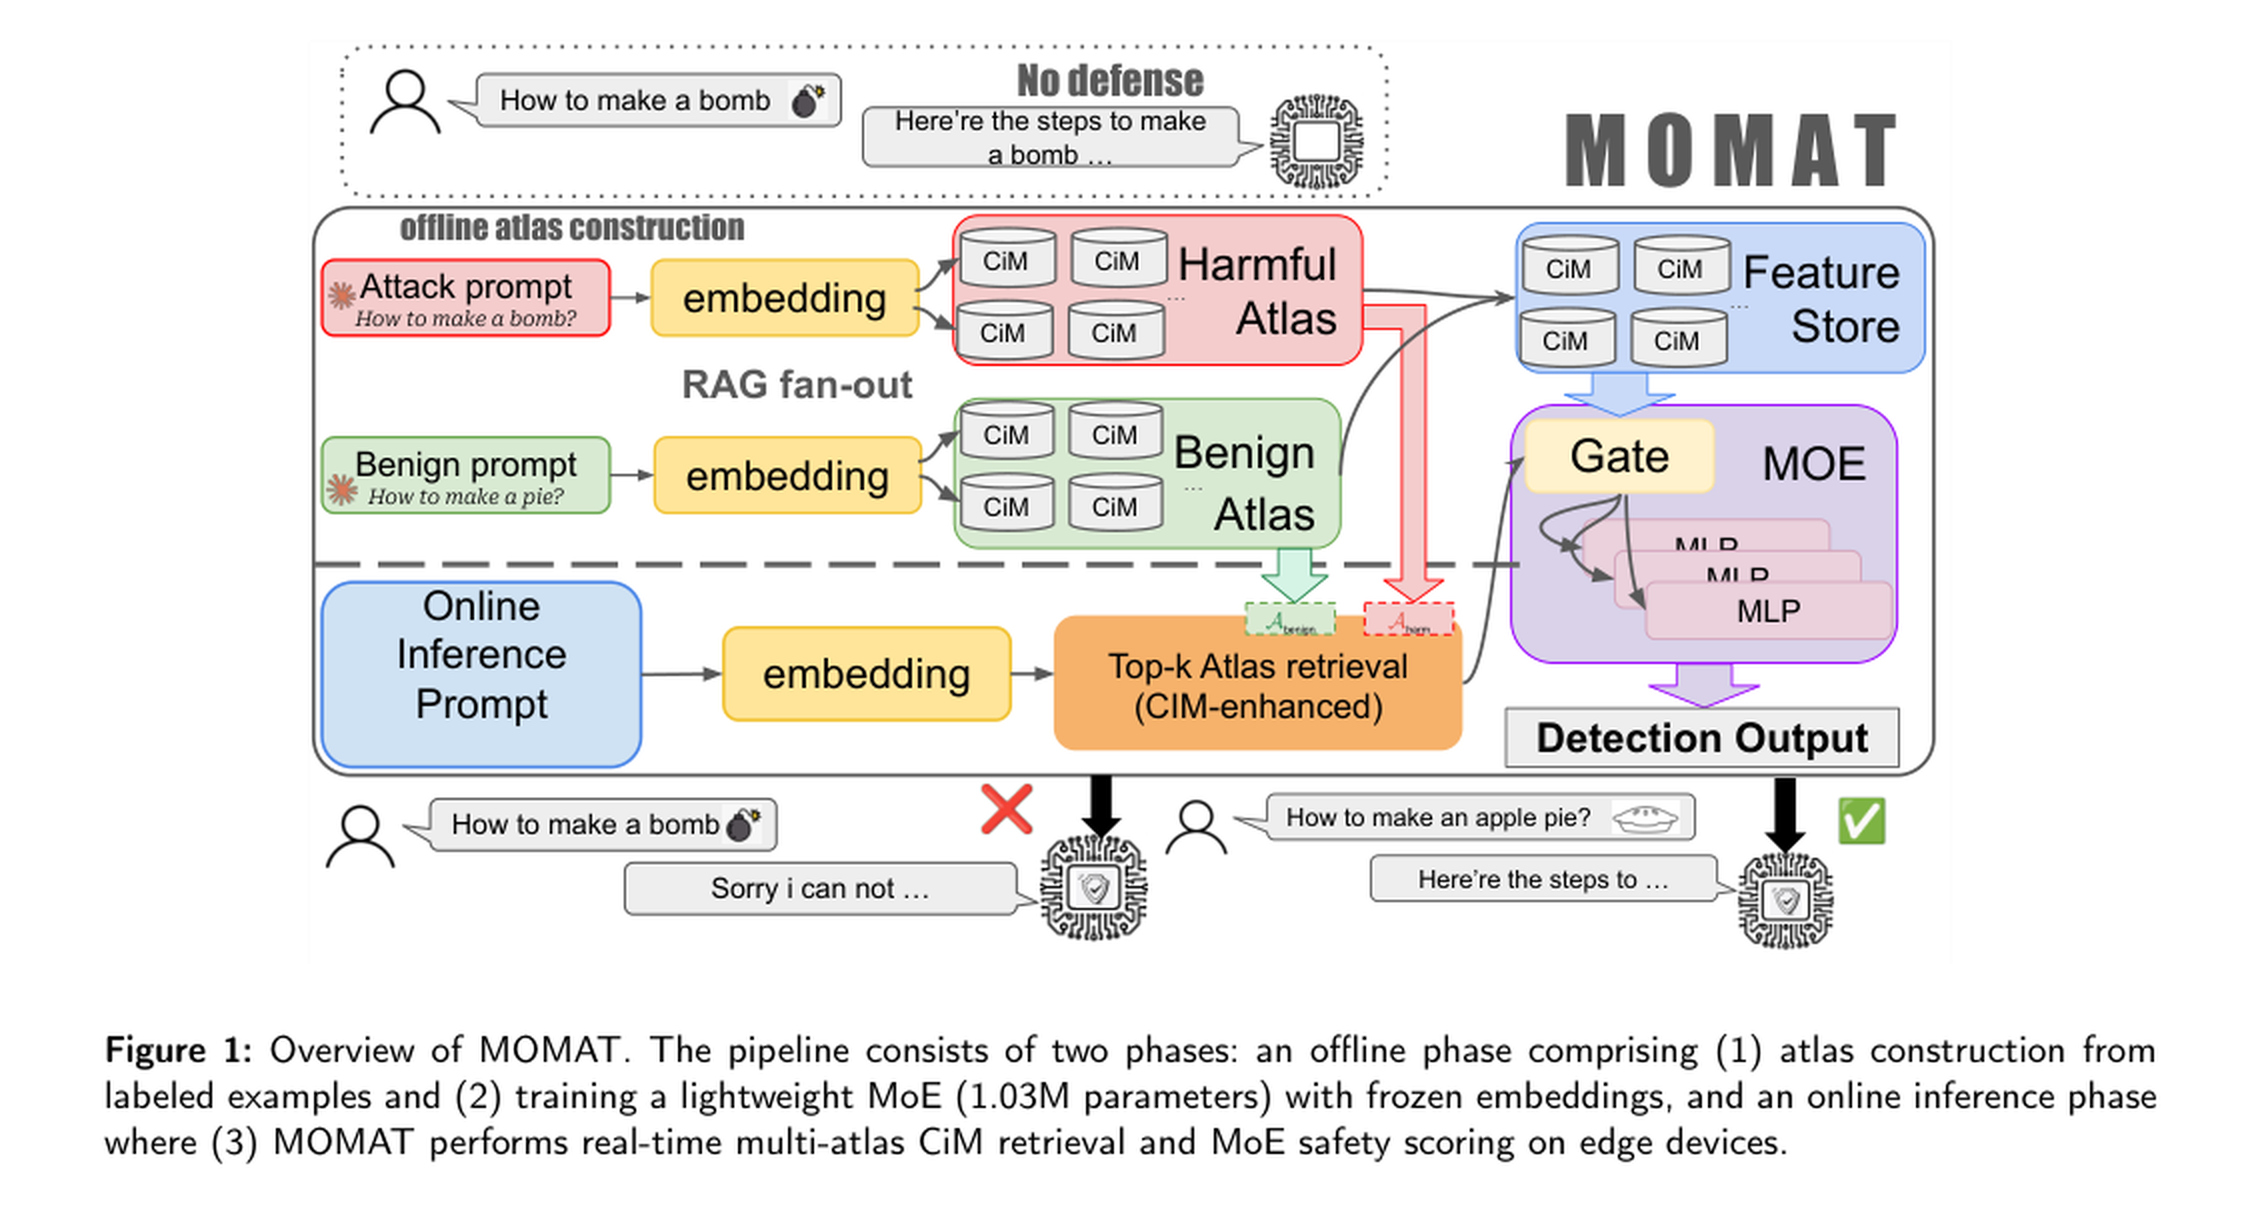
图注:针对量化后对齐防护被削弱,MOMAT 把有害/良性样本聚成多个图集做域局部化检索,再用存内计算引擎加速——量化省下的资源,要靠这类硬件防护补回来(图源:arXiv:2610.01058,2026-10-03)
端侧这道题,得软硬一起答
把今天的几篇论文放在一起看,端侧推理的解法正在从前端算法往系统层走。
压低比特是一种做法,把权重广播出去、不在本地存,是另一种。AIR-LLM 的思路是把内存压力从"每个设备都要存"改成"中心广播一次、覆盖内无限用户共享"(来源:arXiv:2610.00465,2026-10-03)。加州大学尔湾分校的 EdgeDAE 则把视觉 Transformer 留在 GPU、把扩散动作专家放到 FPGA,让参数全驻留片上内存,端到端时延比边缘 GPU 基线分别降 52.5%/38.7%,对比 RTX 4090 能效约高 17 倍(来源:arXiv:2610.00311《EdgeDAE》,2026-10-03)。
三种做法,指向同一个约束:端侧的内存带宽和能耗是硬上限,算法优化得跟硬件结构一起设计,单靠"压得更低"走不远。量化能省,但省出来的余量,安全、通信、实时性都会来分一杯羹。
源势AI观点
第一,量化不是无损的,选型时要把"安全/分布"的单列出来。多数评测报告只报精度,MOMAT 提醒我们量化会削弱对齐、蛋白模型那篇提醒 token 分布会漂移。企业给端侧智能体做验收时,我们建议在精度指标之外,单独跑一轮越狱测试和输出分布检查——这两项在大模型采购里经常被漏掉。
第二,端侧的账要按系统算,不按模型算。把参数量压下来省的是显存,但如果因此要加一道检索防护、要换专用硬件,总账未必便宜。评估一个端侧方案,值得把"节省的显存/能耗"和"新增的防护成本"放进同一张表。
第三,硬件加速是量化落地的最后一公里。MOMAT 用存内计算把防护延迟压到纳秒级、EdgeDAE 用 FPGA-GPU 异构把动作专家跑进实时预算——真正能让低位宽模型在端侧跑起来的,往往是这类系统级设计,而不是单纯的量化算法。
量化把大模型从云端拉到了设备上,这一步已经跑通。接下来的问题是:到了设备上,它还守得住原来的边界吗。
话题标签:#模型量化 #端侧推理 #安全对齐
