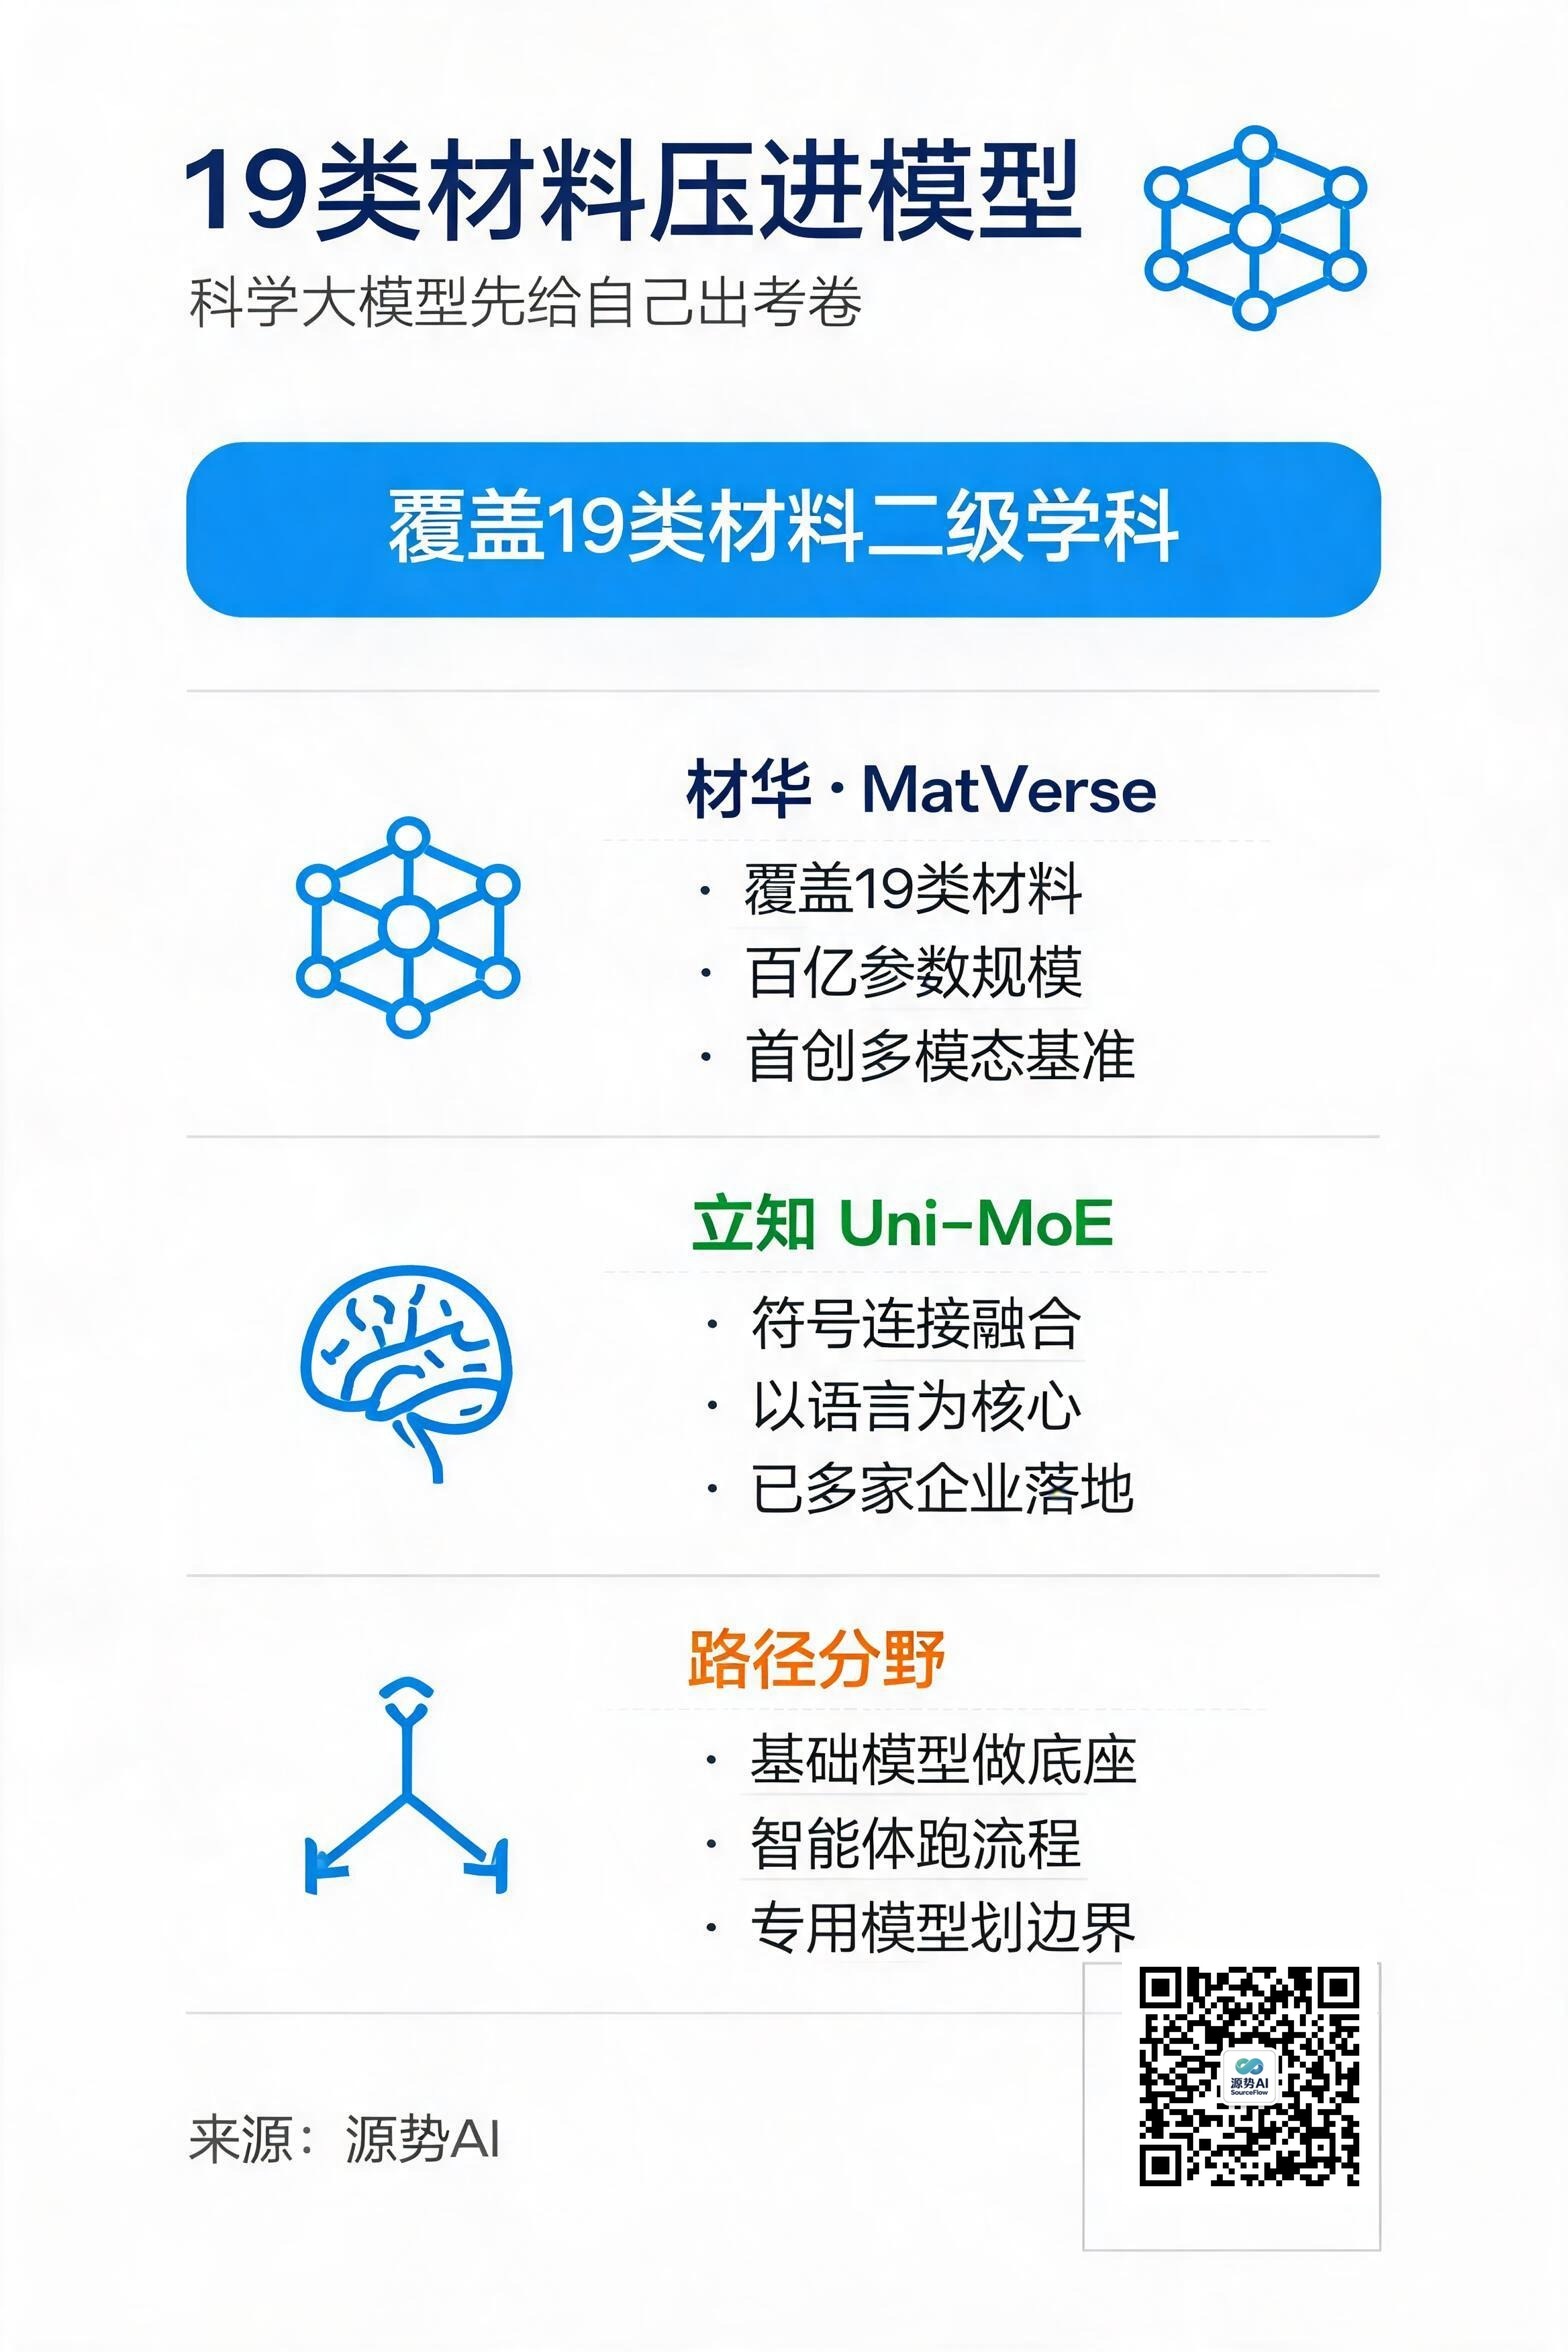
科学大模型,开始给自己出考卷了。
10 月 2 日,中国科协"新天工开物"科技成就发布会人工智能专场首播,发布两项代表性成果:"深度自然语言理解和生成关键技术及应用"与"材料大模型的构建及应用",分别对应"立知"和"材华"两款大模型(来源:人民网,转引自《AI行业24小时_20261003_10》)。
两款模型走的是两条路:一个把能力内化进参数,一个把学科边界划清楚再逐科评测。这两条路的分歧,正好是 AI for Science 现在最值得看的地方。
材料大模型,先立一张考卷
先说"材华"。
据人民网报道,"材华·MatVerse"由苏州国家实验室联合上海人工智能实验室、上海交通大学推出,形成"数据-大模型-智能体-评测-应用"全链条,首创覆盖 19 类材料二级学科的多模态评测基准,被推介为世界首个百亿参数、首个原生多模态的材料大模型(来源:人民网,转引自《AI行业24小时_20261003_10》)。
注意这条链的顺序。它没有先讲模型多大、分数多高,而是把"评测"写进了全链条。19 类二级学科、多模态基准——这才是这次发布里信息量最大的部分。材料科学的数据分布极散:金属、陶瓷、高分子、无机非金属,每类学科的图谱、表征、工艺参数都不一样。一个模型宣称"懂材料",如果拿不出覆盖这些细分的评测,就只是一句推介语。
需要保留的口径同样要说清楚。"世界首个百亿参数""首个原生多模态"都是发布会推介口径,报道未附可复核的基准榜单与第三方评测;落地企业与"显著经济与社会效益"也没有披露具体案例与量化数据;这属于国内自主创新成就展示,不是新论文发布(来源:人民网,转引自《AI行业24小时_20261003_10》)。
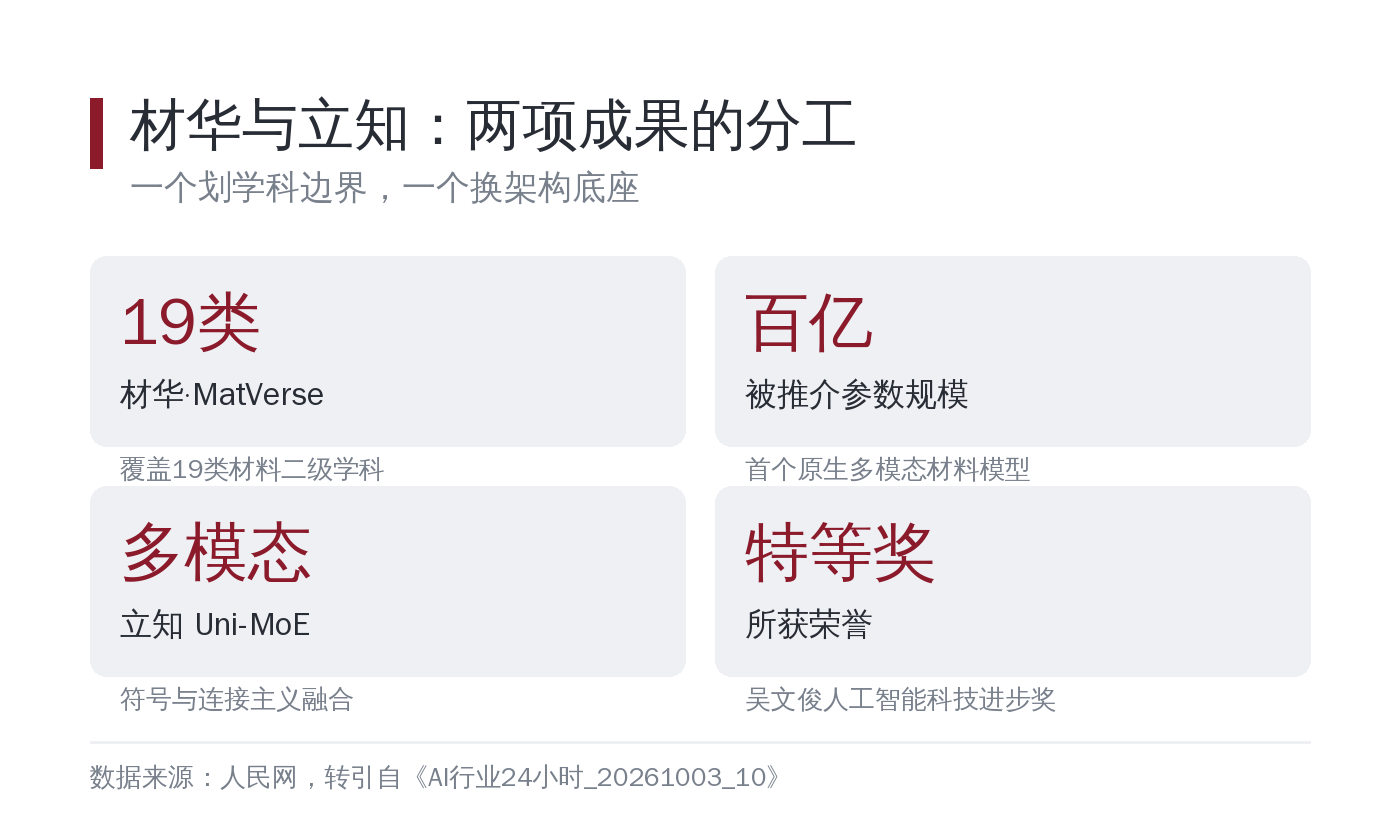
图注:材华覆盖 19 类材料二级学科、走"大模型+智能体+评测"全链条;立知主打符号主义与连接主义融合的多模态范式——一个立学科边界,一个换架构底座(数据来源:人民网,转引自《AI行业24小时_20261003_10》)
另一条路:把能力内化进参数
再说"立知",以及它背后的整条路径。
据人民网报道,"立知"由哈尔滨工业大学(深圳)张民团队自主研发,为 Uni-MoE 系列多模态大模型,提出符号主义与连接主义融合、以语言为核心的新范式,已在多家头部企业落地,获 2025 年度吴文俊人工智能科技进步奖特等奖(来源:人民网,转引自《AI行业24小时_20261003_10》)。
这是一条"架构换底座"的路线。它不急着给某个学科出考卷,而是先解决多模态模型怎么同时处理符号推理和神经网络的直觉——这两件事过去总被当成两条互斥的技术路线。
更彻底的版本在论文里。2026 年 8 月,上海 AI 实验室发布 Intern-S2-Preview,一个 3970 亿参数的科学智能体基础模型:预训练阶段从科学文档、交错图文数据和多样化科学语料中学习,包含渲染科学页面的视觉预训练;后训练阶段统一了监督微调、多任务强化学习、黑白盒智能体强化学习和在线策略蒸馏(来源:arXiv:2608.13505《Intern-S2-Preview: Scientific Agentic Foundation Model》,转引自源势AI《AI科学家,自己做实验》,2026-08-17)。
它有个设计值得单独拎出来:Memory Decoder——一个独立训练的参数化记忆模块,挂载在冻结的 3970 亿主干上,不改核心参数就能实现领域特化,在生物学指令集上 4B 参数的 Memory Decoder 把平均分从 56.92 提到 60.32(来源:arXiv:2608.13505《Intern-S2-Preview: Scientific Agentic Foundation Model》,转引自源势AI《AI科学家,自己做实验》,2026-08-17)。
腾讯研究院在《2026 人工智能十大趋势报告:协同进化》里给这种现象下了个判断:通用 AI 模型保障科学智能的广度与下限,专用科研模型不断探索细分科研场景创新的深度与上限(来源:腾讯研究院《2026人工智能十大趋势报告:协同进化》)。材华选的是"划细分",Intern-S2 选的是"做底座",两者恰恰是这句话的两端。
从"答题"到"做实验"
还有第三种存在方式:不满足于回答科学问题,而是自己做研究。
2026 年 8 月,新加坡国立大学和牛津大学团队发布 OmniScientist,覆盖 5 个学科族、4 类科学证据,模态包括图像、信号、音频、视频、3D 结构、轨迹、表格、公式和图谱。在 36 个案例中,系统完成了从原始数据到编译论文的全流程,平均论文评分 6.3 分(7 维度量规,满分 10 分)(来源:arXiv:2608.13558《OmniScientist: An Omni-Modal Omni-Discipline AI Scientist》,转引自源势AI《AI科学家,自己做实验》,2026-08-17)。
它做了一个关键对照实验:把完整系统和"盲版"比——盲版只接收预先计算好的标量特征,从不接触原始观察数据。结果是直接感知在全部 7 个评估维度上都更优,在正面比较中赢得 85% 的判断(来源:arXiv:2608.13558《OmniScientist: An Omni-Modal Omni-Discipline AI Scientist》,转引自源势AI《AI科学家,自己做实验》,2026-08-17)。
这个对照说明的问题比分数本身重要:当模型只能看到人类替它总结好的数字,它能提的假设就有限;当它能直接读一张显微图像、一段地震波形,问题的形状会不一样。科学发现依赖的空间、时间、跨通道关系,在"文字化"的过程中最容易丢。
但它也有明显的天花板。6.3 分的平均论文评分意味着产出还在中等偏上水平,离顶刊发表有距离(来源:arXiv:2608.13558《OmniScientist: An Omni-Modal Omni-Discipline AI Scientist》,转引自源势AI《AI科学家,自己做实验》,2026-08-17)。把它当成"独立科学家"为时过早,把它当成研究流程里的重复劳动处理器——文献综述、数据清洗、统计检验、图表生成、初稿撰写——现在就能用。
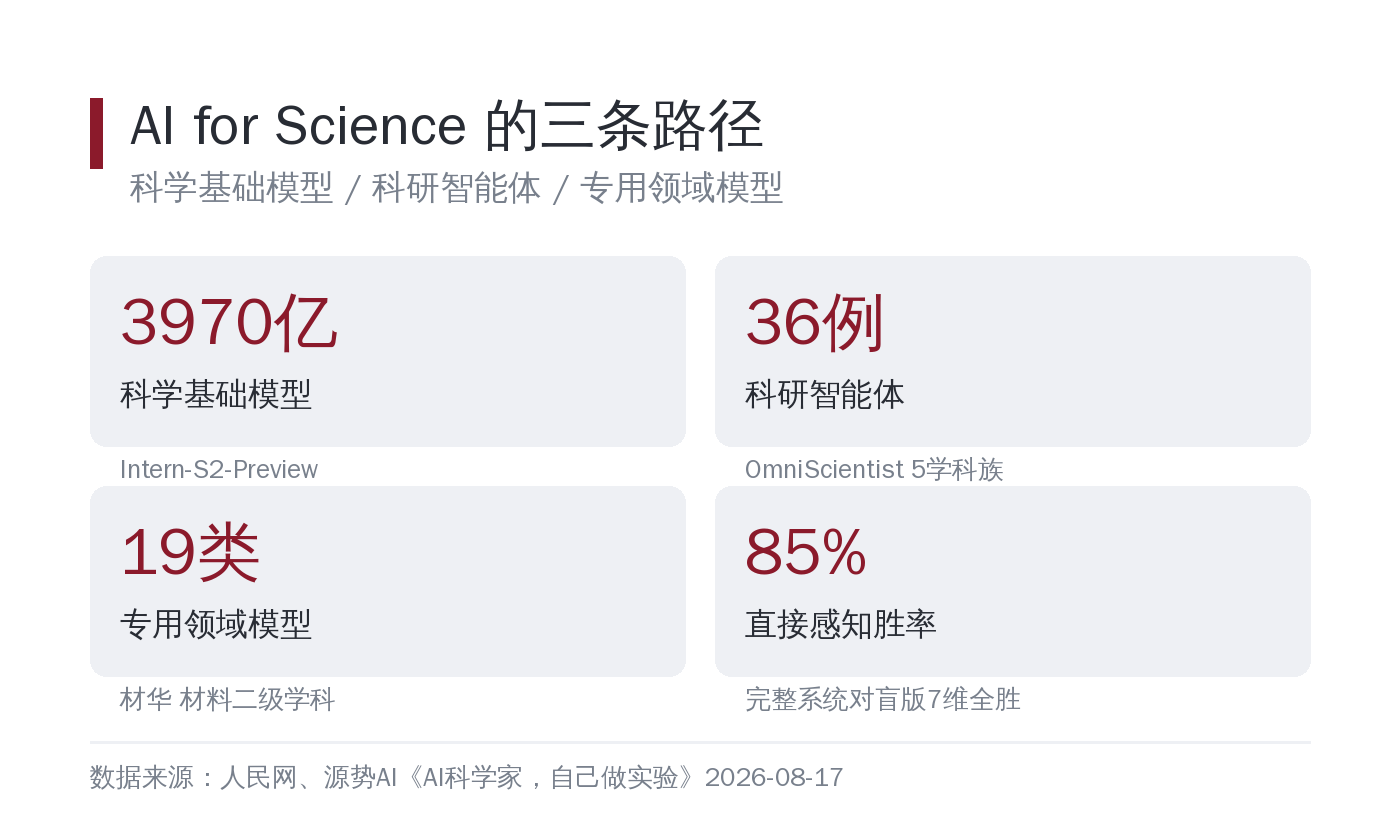
图注:原生多模态材料模型立学科边界,科学基础模型做参数底座,科研智能体跑完整流程——三条路径对应三种不同的评价标准(数据来源:人民网,转引自《AI行业24小时_20261003_10》;arXiv:2608.13505、arXiv:2608.13558)
源势AI观点
第一,科学大模型的价值,先看它有没有自己的考卷。材料领域 19 类二级学科、每类数据分布都不同,通用榜单上的高分在这里参考价值有限。给企业做科学大模型选型时,我们建议先问一句:有没有针对你所在细分学科的评测集?没有的话,"国际领先"这四个字可以先放一边。
第二,专用模型和通用底座不是二选一。Intern-S2 用一个很小的记忆模块挂在冻结的主干上,把"领域特化"的成本压到很小;材华则通过划分类别把评测做实。企业不必为每个新领域从头训练模型,但必须为每个新领域准备好数据与评测——前者是算力问题,后者是工程问题。
第三,让 AI 做研究,约束比能力更重要。OmniScientist 在构思、实验、报告三个阶段都塞了代码执行的检查(新颖性、可证伪性、数据泄漏、有效样本量),目的是防止模型在大量数据里反复试,直到偶然"发现"一个显著结果。科研智能体最大的风险从来不是能力不够,而是没有约束地发现了不存在的规律。这一点,企业做研发智能体时值得原样照搬。
两百亿参数还是四千亿参数,最后都要落到同一件事上:这个模型说它懂材料、懂生物,谁来核。
话题标签:#材料大模型 #AI4Science #科学智能
