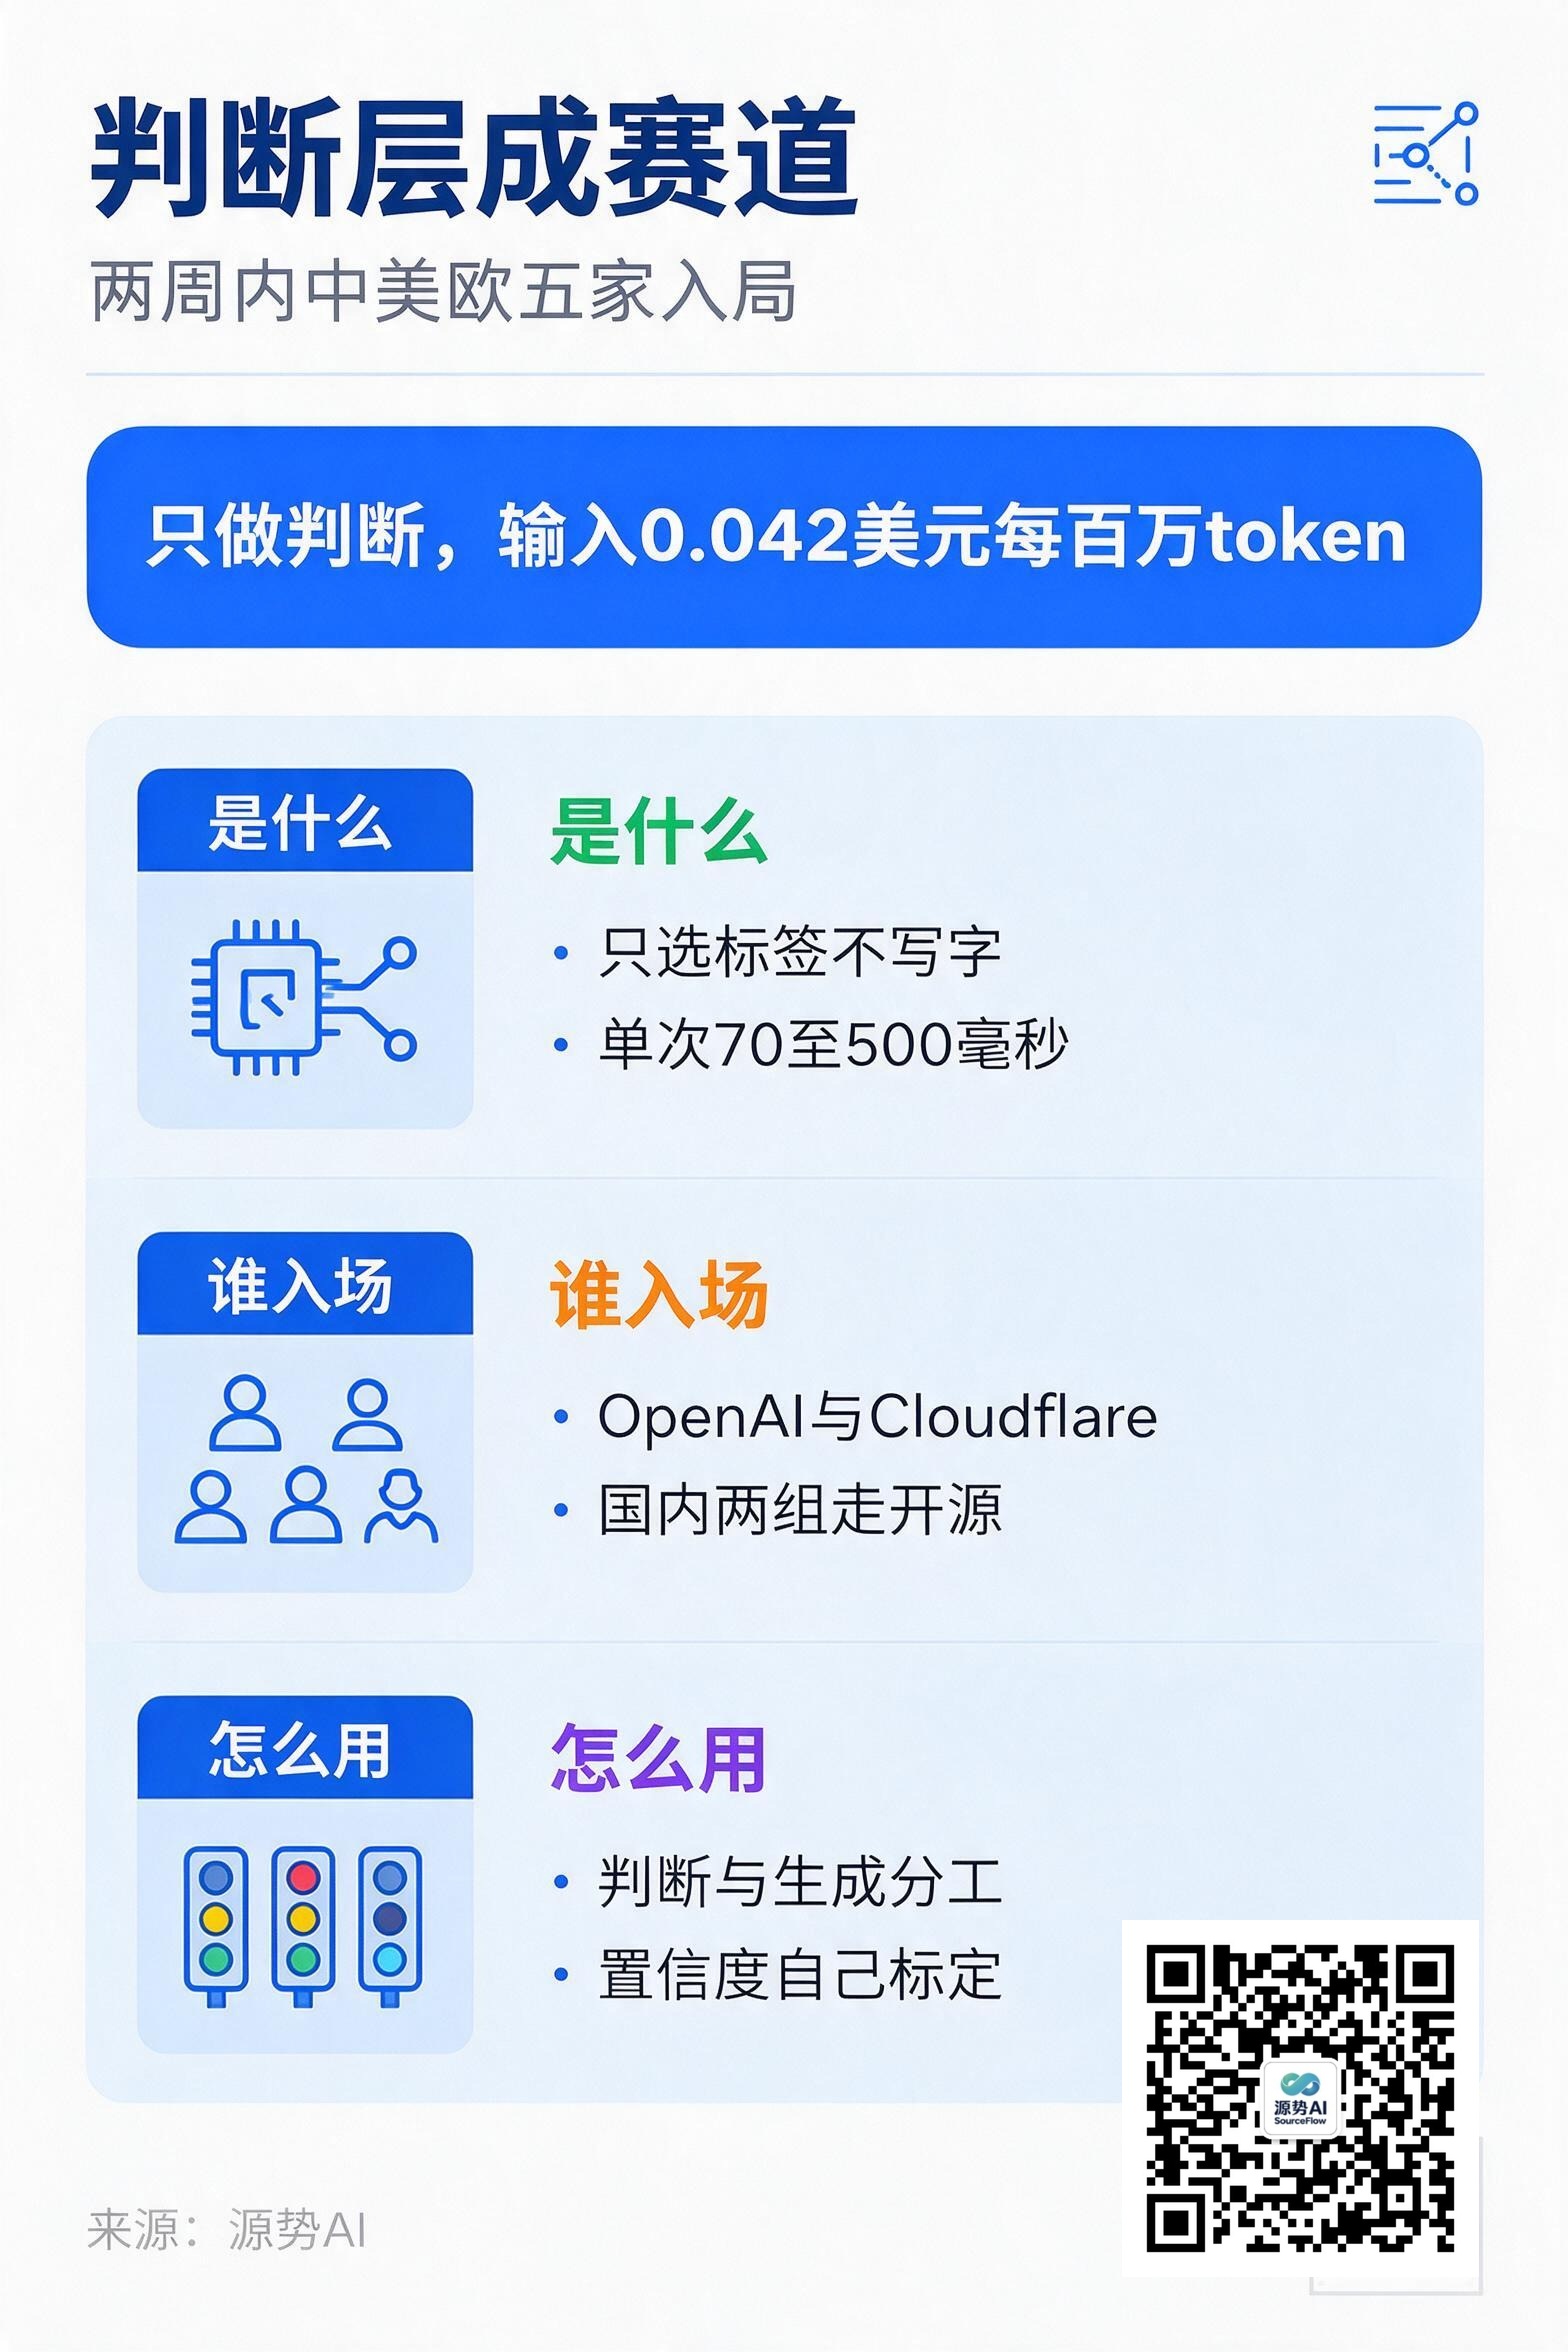
图注:一图读懂本文要点——判断层只做选择、不写文字,两周内中美欧已有五家入局(来源:源势AI)
一个只做判断、不写字的模型发布两周后,这个品类变成了赛道。
TypeSafe AI 在 9 月 15 日发布决策模型 Jev:每百万输入 token 0.042 美元、输出免费(来源:极客公园,转引自 Tech Digest《AI行业24小时_20261005_10》,2026-10-05)。两周之内,中、美、欧几乎同时下场——OpenAI 推 Decisions API,Cloudflare 在 10 月 1 日开源 Clef,亚马逊放出 Strands Decider;国内也有两支队伍,上海人工智能实验室开源 0.8B、2B、4B 三档多模态 Intern-Decision,上海创业公司 StartLux 在 9 月 30 日开源 0.8B 到 27B 五档 StartLux-Decision(来源:同上)。
Jev 到底做了什么
它自己不生成任何文字。你给它当前状态和一组预设标签,它返回选中的选项、概率和置信度——本质是一个高速分类器,官方把这类模型叫 System One Models(系统一模型,对应人脑里"快而省"的那套反应)。接口也只有三种:Choice 从选项里选一个,Score 按等级打分,Noul 判断真假、只返回一个 0 到 1 的概率;选项基数上限 255(来源:《七张图看懂决策模型 Jev》,转引自 TypeSafe 官方博客与官方文档,2026-09;官方博客)。
真正把账算清楚的是一个实测。Browser Use 用一次 7 秒的浏览器查票任务测试:AI 被调用了 19 次,其中 17 次是判断(点哪个、选哪个),只有 2 次是真正写文字(填城市名);单次判断的中位延迟 178 毫秒(来源:Browser Use 实测记录,github.com/browser-use/jev-ultrafast)。
也就是说,我们搭 Agent 时让大模型反复"决定下一步"的那些调用里,绝大多数其实只是在做判断,用不上完整推理。延迟上也对得上:Jev 单次判断 70 到 500 毫秒,官方对标的前沿大模型端到端区间是 3 到 329 秒(均为厂商口径)。

图注:一次 7 秒的浏览器任务里,19 次调用有 17 次是判断——Agent 的开销大头,其实落在"选一个"上(数据来源:Browser Use 实测记录,转引自《七张图看懂决策模型 Jev》)
两周内的入局者
跟进的队伍来得快,路线也分成了两类。
英美这边以闭源 API 为主:OpenAI 推 Decisions API,Cloudflare 10 月 1 日开源 Clef,亚马逊放出 Strands Decider。国内的两支则几乎不约而同走开源加本地部署——Intern-Decision 覆盖 0.8B、2B、4B 三档,StartLux-Decision 从 0.8B 铺到 27B(来源:极客公园,转引自 Tech Digest《AI行业24小时_20261005_10》,2026-10-05)。
StartLux 给了一份自测成绩:27B 版在 Decision Index 0.2.1 的 38 项测试中有 31 项高于 Jev 1.13,综合分 63.88 对 57.91。这份成绩的对照基准是 9 月 28 日的榜单快照,属于自测、非第三方复现(来源:同上)。更值得注意的是时间点——StartLux 发布次日,Cloudflare 就称 Clef 在同一榜单领先,这个"第一"的保质期短得可以按天算。
需求侧的信号同步出现。Vercel 披露,Jev 上线 24 小时内,其 AI Gateway 上 13% 的付费用户已经用上(来源:极客公园,转引自 Tech Digest《AI行业24小时_20261005_10》,2026-10-05)。
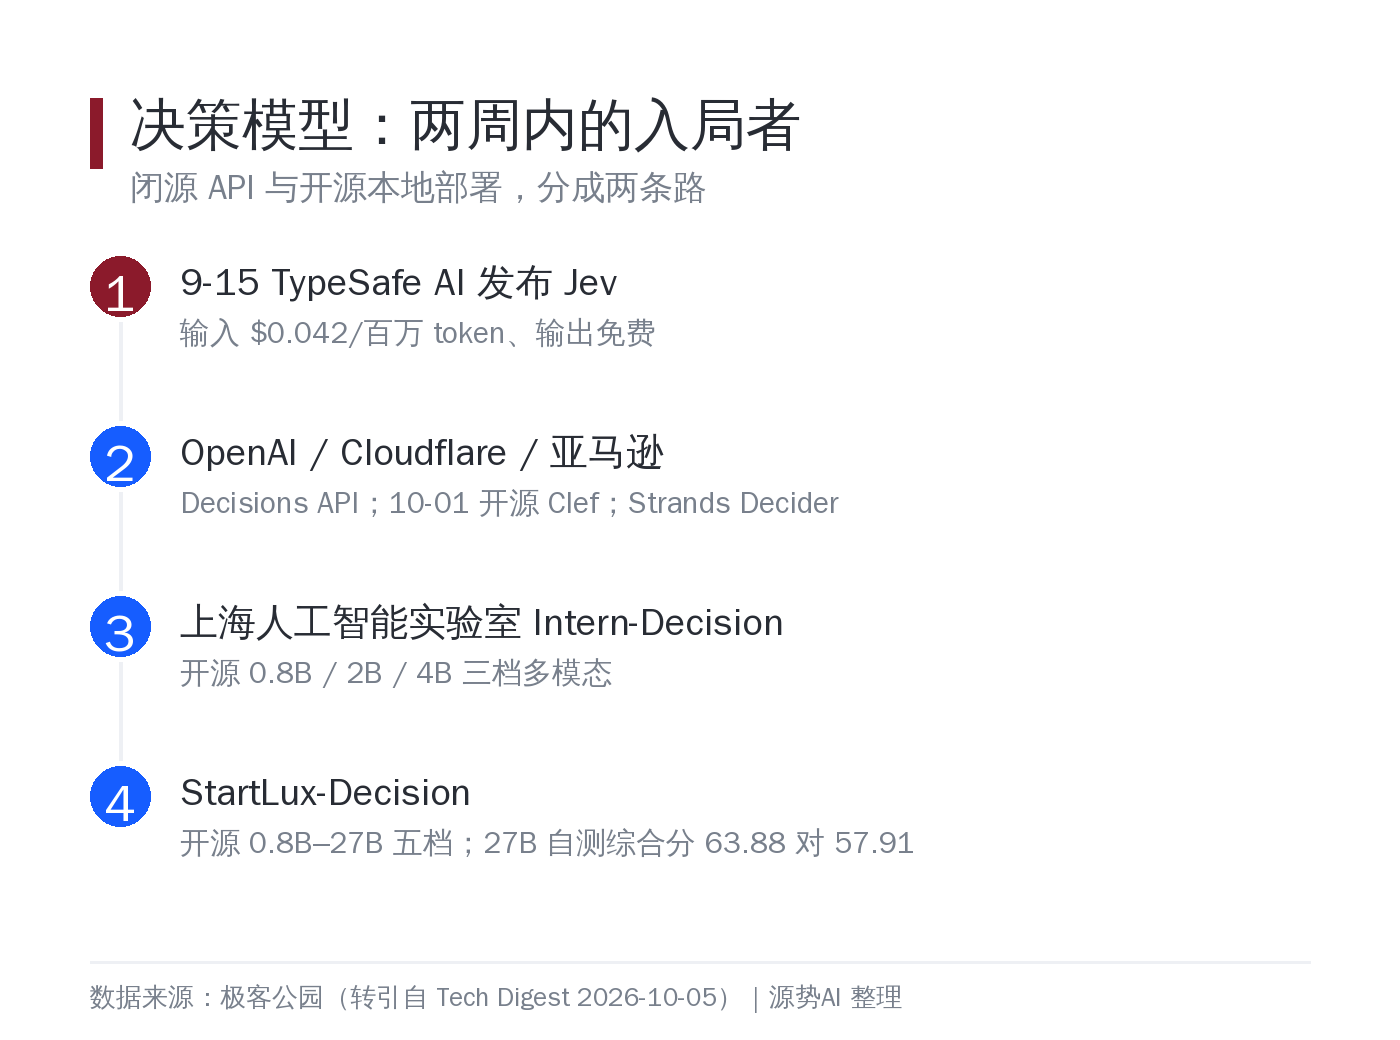
图注:两周里挤进五家,闭源 API 与开源本地部署分成两条路——国内队伍补的正是 Jev 留下的那半个空位(资料来源:极客公园,转引自 Tech Digest 2026-10-05;末句为源势AI 观点)
为什么便宜
判断类任务的账,只有输入这一项。Jev 输入 0.042 美元/百万 token、输出免费,十亿 token 才 42 美元;官方口径下,DOOM 那种每秒 10 次判断的玩法,成本约 7 美元/小时(来源:《七张图看懂决策模型 Jev》,转引自 TypeSafe 官方博客,2026-09)。
便宜只是表面。更关键的是延迟——判断从秒级降到百毫秒级,Agent 里那些高频、低价值的"选哪个"环节才第一次能被拆出来单独处理。省下的不只是算力,是每一次判断的时间和钱。
判断与生成的成本结构也不一样。生成类调用按输出 token 计费,输出越长越贵;判断类任务只读不写,账单里只有输入这一项。同一批 Agent 负载里,把高频的判断环节拆出来,省下的是可预期的一笔固定成本,而不是随生成长度浮动的开销(来源:《七张图看懂决策模型 Jev》,转引自 TypeSafe 官方博客,2026-09)。
最容易用错的一个数
Jev 返回的置信度,不是准确率。
它给的 0.85,量的是"答案分布有多集中",官方公式是 (3×最大概率−1)/2;它不是"这个答案有 85% 的概率正确"(来源:TypeSafe 官方文档,转引自《七张图看懂决策模型 Jev》,2026-09)。想拿高置信度当自动执行的门槛,官方原话是:阈值没有通用值,要用你自己的数据标定(来源:TypeSafe 官方文档 docs.typesafe.ai/confidence)。
正确的用法是三档门禁:高置信直接自动执行,中置信升级给强模型再想一遍,低置信转人工或追问。阈值画在自己的数据上,随风险调整——不可逆操作的门槛要更高。
源势AI观点
第一,把"判断"和"生成"分开计价,是这轮变化里最值得抄的一条。同一批 Agent 负载里,判断类调用占了调用次数的大头——Browser Use 的实测里是 19 次中的 17 次——把这部分换成判断模型,省下的是"调用次数 × 单次延迟与单价",先分层、再分别选模型,比单换一家供应商更能压住总账。
第二,"第一"不要写进选型结论。这个榜单发布才两周,"榜首"已经换了两轮;拿去写进技术方案的是接口稳不稳定、成本曲线是否可预期,而不是某一天的名次。
第三,置信度必须自己标定再上线。0.85 在不同任务上的含义不同,直接把默认阈值用来放开自动执行,风险敞口很可能会超过它省下的那点延迟。上线前至少跑一遍自己场景的标定,把不可逆操作的门槛单独调高。
判断被拆成一个廉价的独立部件,这件事本身比谁拿了第一更重要。它意味着 Agent 的架构里,多了一层过去一直混在生成里的分工。
话题标签:#决策模型 #Agent架构 #推理成本
