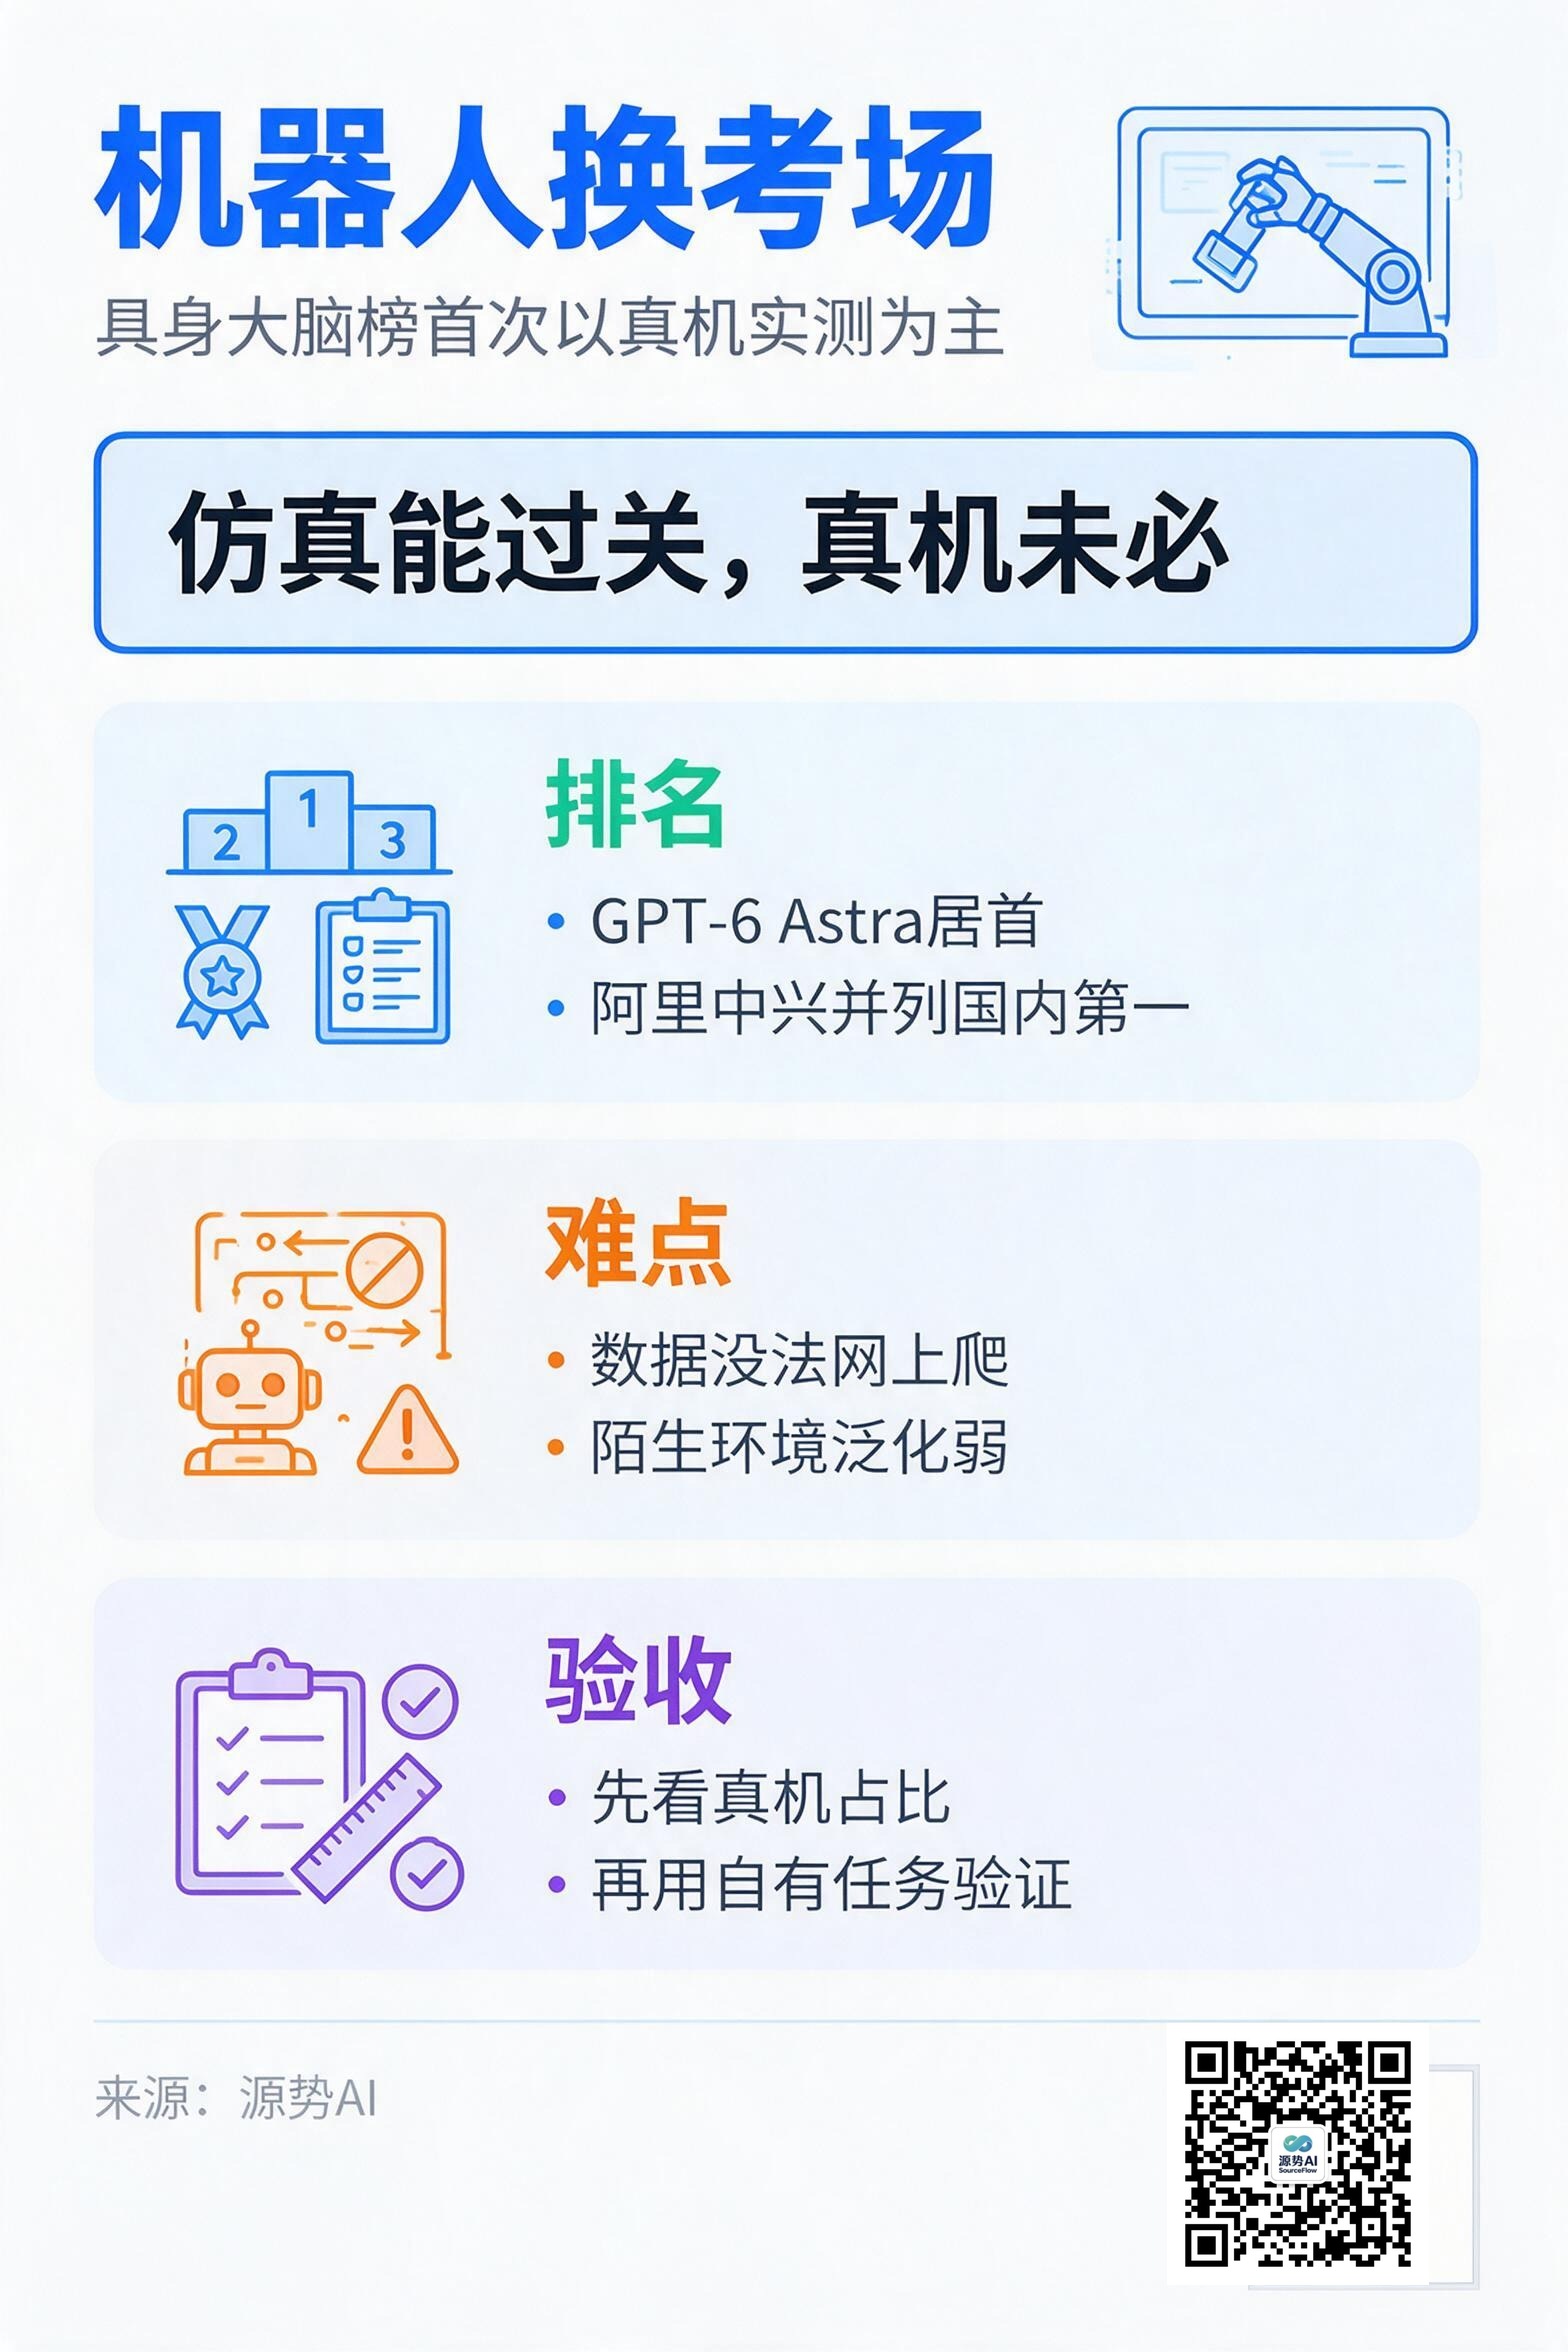
图注:一图读懂本文要点——具身大脑榜首次以真机实测为主,仿真能过关、真机未必(来源:源势AI)
一份新榜单,把机器人评测的考场从仿真环境搬到了真机。
SuperCLUE 发布首份具身大脑评测榜单,覆盖环境感知、物体识别、长任务规划、物理世界预判等维度,最大的不同是加入了大量真机实测,而不是只跑虚拟仿真(来源:快科技,转引自 Tech Digest《AI行业24小时_20261005_10》,2026-10-05)。
这个改动看着只是换了测试环境,但它动的是评测的含金量:仿真里能过关的模型,到了真机上未必还能过关。
排名怎么排的
榜首是 OpenAI 的 GPT-6 Astra,综合第一,优势集中在长逻辑推理与复杂任务拆解(来源:快科技,转引自 Tech Digest《AI行业24小时_20261005_10》,2026-10-05)。
国内的第一名有两位。阿里达摩院与中兴分数一致、并列第一,但强的地方不一样:阿里强在时空记忆——任务被打断之后,仍然记得没做完的那部分;中兴偏端侧落地,更适合直接跑在实体设备上(来源:同上)。
榜单同时给了国产模型两处短板:与 GPT 仍有总分差距;超长链任务上偶有判断出错,陌生环境下的泛化还有提升空间(来源:同上)。
真机考,难在哪
把考场搬出仿真,难度不是加一点,是换了一类问题。
沙利文把具身智能的落地难点归纳成四大商业化挑战:真实世界数据获取、工程化与制造、商业闭环、全球化部署(来源:沙利文《2025年全球具身智能与商用服务机器人独立市场研究报告》,2025)。报告把数据单列出来重点讲:真实世界数据的采集成本高,依赖机器人本体、传感器、测试场地和人工标注持续投入;机器人的训练数据没法像文本那样从网上爬,只能靠物理执行一条条记下来,遥操作、动作捕捉、第一视角视频,哪一种都贵、都慢(来源:同上)。
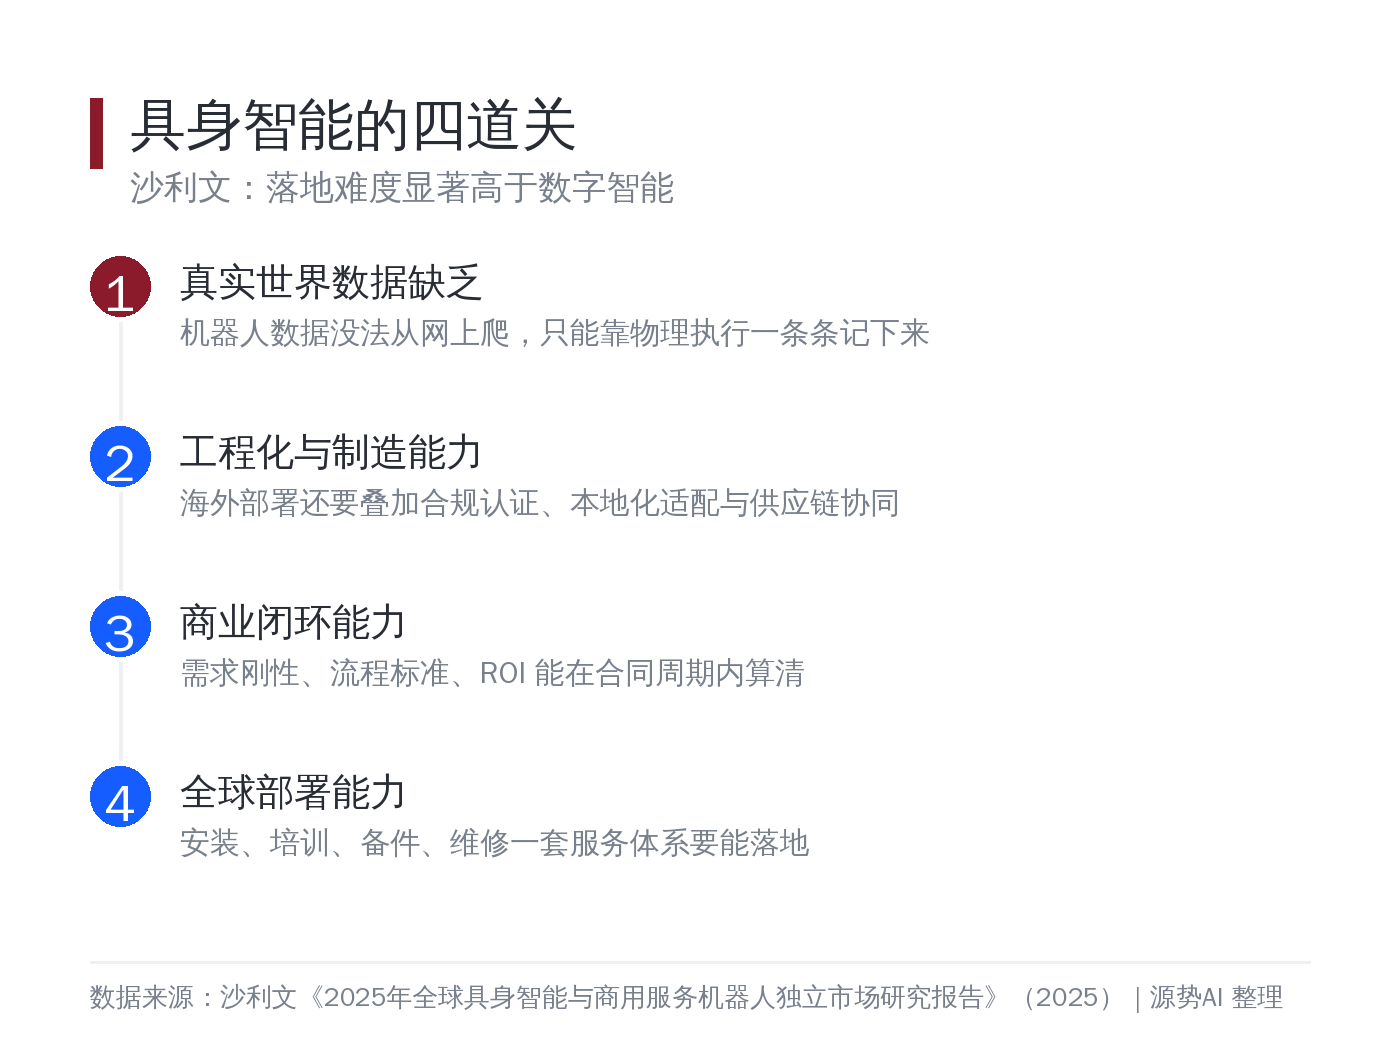
图注:数据、工程化、商业闭环、全球部署——沙利文列出的四道关里,数据排在首位,也是真机评测最想暴露的那一环(数据来源:沙利文《2025年全球具身智能与商用服务机器人独立市场研究报告》,2025)
云启资本在具身智能数据产业链的报告里把验收标准说得更直白:世界模型可以生成经验、预测后果和筛选策略,但只有在未参与训练的真实测试集上降低了失败、接管或测试成本,放大才具有产业意义(来源:云启资本《2026具身智能数据产业链与新基础设施研究报告》,2026)。真机考场想做的,正是这种"未参与训练的真实测试集"。
榜单之外,节奏看什么
读这类榜单,先看它的边界。SuperCLUE 的榜单由自己设计与评分,测试集与权重未完全公开;不同榜单测试集不同,排名常有出入,这一榜的差异只在于真机测试占比更高(来源:快科技,转引自 Tech Digest《AI行业24小时_20261005_10》,2026-10-05)。所谓"优势明显""遥遥领先",是榜单结论,没有第三方交叉验证。
真正决定节奏的还是供给侧。沙利文对这条赛道给的三条判断是:具身智能的落地门槛高于数字智能,但长期价值更大;商用服务机器人(配送、清洁、导览、楼宇服务、医疗配送、工业轻量配送)有望成为具身智能的第一落地场景;"一脑多形"——用统一的智能底座连接多样本体——将成为下一代机器人的主流范式(来源:沙利文《2025年全球具身智能与商用服务机器人独立市场研究报告》,2025)。
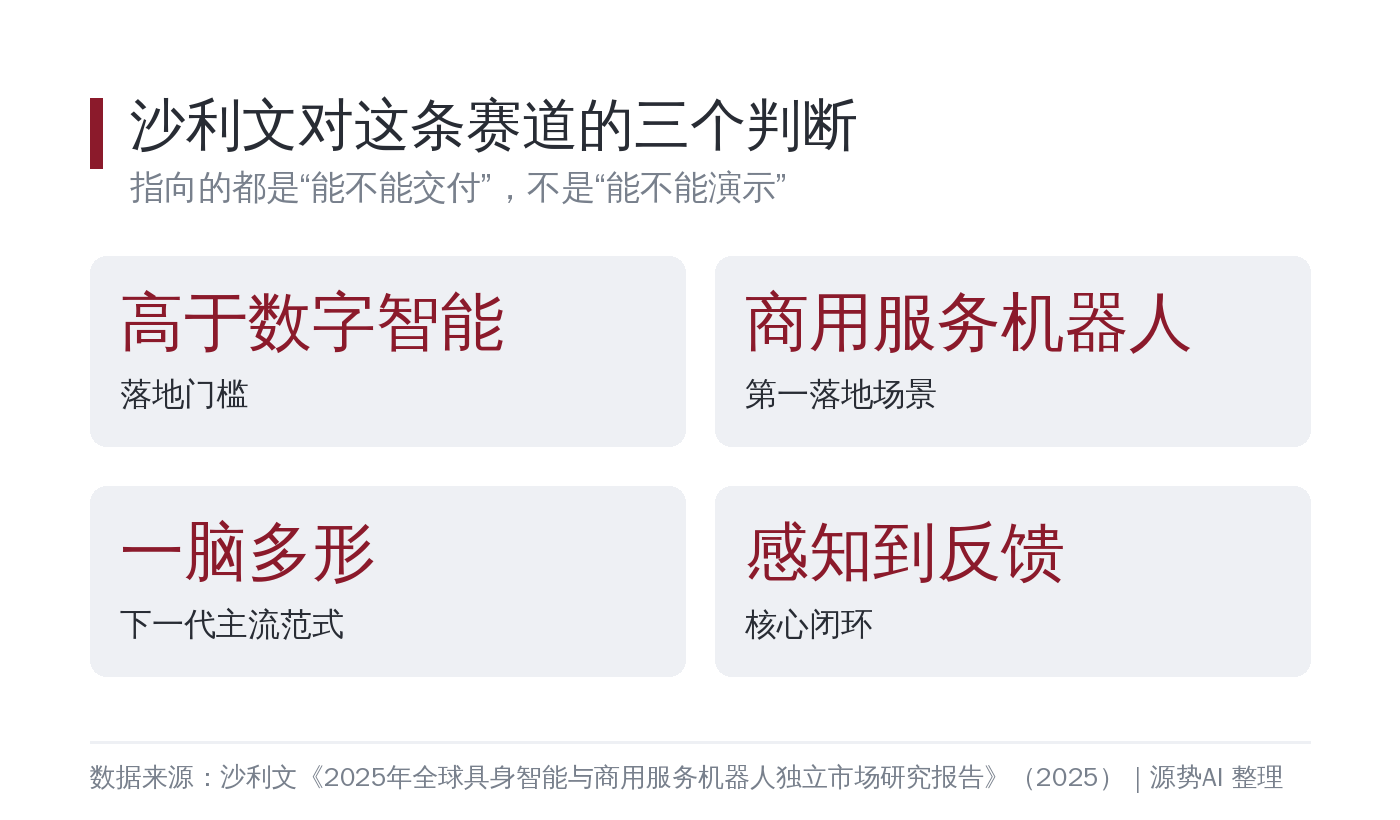
图注:落地门槛高于数字智能、商用服务机器人先落地、一脑多形成主流范式——这三条判断指向的都是"能不能交付",而不是"能不能演示"(数据来源:沙利文报告,2025)
评测榜对企业有什么用
榜单不能直接当采购依据,但它能改一件很具体的事:验收标准。
过去验收机器人,看的多是任务能不能完成、成功率多少。真机评测把标准推到更靠前的位置——同一套模型,换个场地、换批物料、换个人说话,成功率还掉不掉。
沙利文把最影响交付的几件事列得很清楚:产品要在感知、计算和执行能力与成本之间找平衡;海外不同市场的作业环境、劳动成本和使用习惯各不相同,本地化适配的门槛高;设备交付后还要长期运维、软件升级、故障响应和客户成功支持,服务能力不足会直接影响续费和规模化采购(来源:沙利文《2025年全球具身智能与商用服务机器人独立市场研究报告》,2025)。这几条对应到验收环节,就是三个问题:需求刚不刚需、流程标不标准、ROI 能不能在一个合同周期内算清。
源势AI观点
第一,真机占比应该成为读榜单的第一眼指标。仿真分数高不代表能落地,真机实测里"任务被打断后还能不能继续""陌生环境泛化掉不掉分"这类项,比综合排名更接近客户会遇到的场景。
第二,评测和采购要分开。榜单测的是通用能力上限,采购要的是你这个场景的下限。我们给具身项目做落地咨询时的做法是:先用榜单缩小供应商范围,再用自己场景的真实任务跑一轮小规模验证,两个结果不一致时,以后者为准。
第三,真机考场的价值不止在排名。它逼着行业把"数据从哪来"摆到台面上——谁先把部署场景变成数据采集场,谁就先形成飞轮。榜单每年可以重排,数据飞轮一旦转起来,差距会按季度拉开。
考场从仿真搬到真机,排名的意义跟着变了:从"这个模型有多聪明",变成"换个地方,它还能不能干"。
话题标签:#具身智能 #机器人评测 #具身大脑
