图注:一图读懂本文要点——跑分差距在收窄,靠的是工程效率而不是算力堆叠(来源:源势AI)
10 月 5 日,彭博行业研究发了一份让中美模型之争换了说法的报告:中国顶尖模型在基准测试得分上,已经只落后美国的对手约 3%(来源:彭博行业研究,转引自 Tech Digest《AI行业24小时_20261006_10》)。这个差距在 5 月还有约 9%,今年早些时候是 15%(来源:彭博行业研究,转引自 Tech Digest《AI行业24小时_20261006_10》)。
报告给的锚点是两个具体分数:DeepSeek 在 LiveBench 上拿到 81.1,Anthropic 最高的系统是 83.4。报告作者给的结论有点扎眼——这个表现"可以与 Anthropic、OpenAI 的领先系统相媲美"(来源:彭博行业研究,转引自 Tech Digest《AI行业24小时_20261006_10》)。
三个月里,这个距离被压缩了大半。值得往下追一层:它是怎么省出来的。
3% 也不是一块铁板
先说口径。3% 是彭博单方测算,取自 LiveBench 综合分,不是统一第三方评测;报告自己也没把话说满,提醒这类排名会不断变动,"无论排名如何,变现都可能很困难"(来源:彭博行业研究,转引自 Tech Digest《AI行业24小时_20261006_10》)。
更能说明问题的是另一组数:LiveBench 前 15 名里,中国模型仍然只有 3 个(来源:彭博行业研究,转引自 Tech Digest《AI行业24小时_20261006_10》)。跑分第一梯队的头部追上来了,但梯队的厚度没变——尖子生和全班平均分是两回事。
《财富》中文网 10 月 3 日的复盘给了同一个方向的旁证:斯坦福一份报告显示,今年早些时候 Anthropic 最强模型的表现仅领先深度求索的模型 2.7%(来源:《财富》中文网,2026-10-03,转引自 Tech Digest《AI行业24小时_20261004_10》)。两家机构、两套口径,落到同一个判断上。
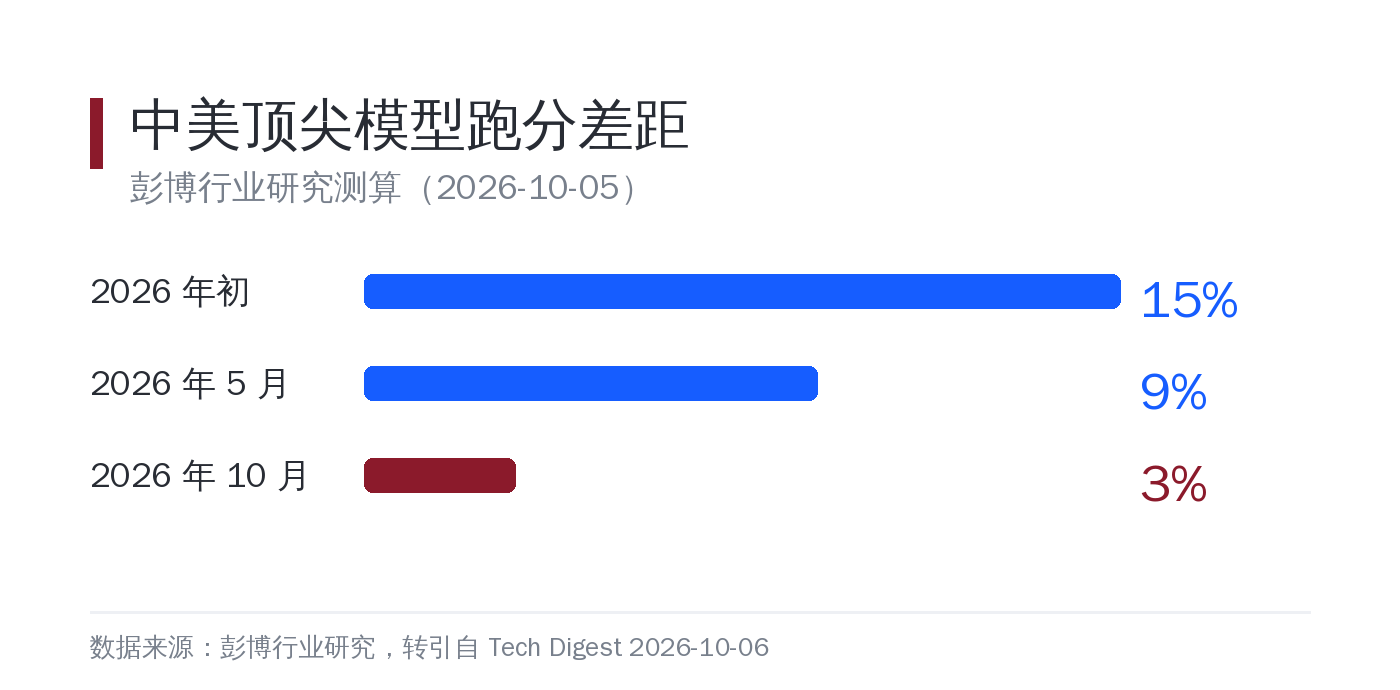
图注:差距从年初的 15% 收到 5 月的 9%、再看 10 月的 3%,但 LiveBench 前 15 名里中国模型仍只有 3 席(数据来源:彭博行业研究,转引自 Tech Digest 2026-10-06)
省算力,省出来的追赶
差距靠什么收窄,两份材料指向同一个词:效率。
Futurum Group 半导体分析师布伦丹·伯克的说法是,中国实验室通过改进注意力机制,把计算复杂度降低了一个数量级,而美国前沿实验室仍是"词元消耗大户"(来源:《财富》中文网,转引自 Tech Digest《AI行业24小时_20261004_10》)。
如果注意力是大模型的发动机,伯克说的就是把同等任务要烧的油降了一个量级。这不是某一篇公开论文的实测数字,是分析师对技术路线的概括,但当它和企业侧的成本证据放在一起,就不再只是一个形容。
企业侧的证据链已经成型:AI 评测平台 Larridin 称 GLM 5.2 与 Kimi 2.6、2.7,能以美国模型五分之一的成本完成约 75% 的工程任务;Hugging Face 的数据显示,中国开源模型占平台总下载量的 41%;Ramp 的 AI 指数显示,为可接入开源及中国模型的平台付费的企业占比,从 1 月的 4.5% 升到了 7 月的 6.1%(来源:《财富》中文网,转引自 Tech Digest《AI行业24小时_20261004_10》)。
便宜五分之四、干完四分之三的活,这笔账任何一个要控成本的技术负责人都会算。下载量和付费占比这两个数字更能说明资本在用脚投票。

图注:付费接入开源及中国模型的平台企业占比,半年从 4.5% 升到 6.1%(数据来源:《财富》中文网,转引自 Tech Digest《AI行业24小时_20261004_10》)
便宜,不等于够用
把乐观的那半收一收,剩下的几个数同样要记住。
白宫的报告称,美国握有全球 74% 的算力资源;麦肯锡的调查显示,20% 的企业高管把 token 成本列为扩大 AI 应用的瓶颈(来源:《财富》中文网,转引自 Tech Digest《AI行业24小时_20261004_10》)。前一个说的是资源底数,后一个说的是成本确实在变成决策变量——但两者都在提醒,中国的优势目前集中在"单位成本"这一维。
《财富》的报道自己也留了余地:美国模型在性能上仍领先数月,"取代"只适用于部分企业场景(来源:《财富》中文网,转引自 Tech Digest《AI行业24小时_20261004_10》)。彭博那边则点出了变现这道坎——跑分能追,能把分数换成收入是另一件事(来源:彭博行业研究,转引自 Tech Digest《AI行业24小时_20261006_10》)。
所以彭博这个数字的正确读法是:在部分基准、部分任务上,成本效率这条路线已经跑通;但"梯队的厚度"和"把能力换成钱的能力",两边的差距都没写进这个数字里。
落到具体场景,这条分界线会更清楚。批量翻译、代码补全、日志归类这类任务,国产模型用五分之一成本干完约八成,替换的收益一目了然;但涉及长链路复杂推理、或者对错误零容忍的环节,替换之前最好先用自家数据跑一轮对照,而不是拿综合分替自己做决定。省钱的边界,恰恰是判断力的边界。
源势AI观点
第一,差距收窄的驱动力正在从"堆算力"转向"省算力",这对企业选型是好事。当国产模型能拿出五分之一的成本干四分之三的活,采购清单上就不该只有一栏跑分,成本、延迟、可替换性要一起摆上来比。
第二,开源模型的下载占比这么高,说明模型的分发正在从"谁的榜第一"转向"谁被集成进别人的系统"。跑分决定能不能上台,被集成决定能不能留下。源势AI做大模型 Token 聚合与智能路由,逻辑就在这:不押单一模型的最强分,而是让客户按任务、按成本随时换到更合适的那一个。
第三,把跑分差距当结论会踩坑。它没有覆盖梯队厚度,也没有覆盖变现能力。对企业客户,更稳的做法是拿自己真实的业务任务去跑一轮对照,用自家的数据说话,而不是拿别人的综合分替自己做决定。
话题标签:#大模型竞争 #推理成本 #开源模型
