
图注:一图读懂本文要点,零阶方法第一次在预训练上追平反向传播,但它要的是另一次地基,不是立刻替代(来源:源势AI)
Q Labs 公布了一个叫 Dust 的方法,是第一个能在预训练 Transformer 语言模型上跟反向传播掰手腕的零阶方法(来源:量子位,转引自 Tech Digest《AI行业24小时_20261007_10》;原始来源 Q Labs 官方博客)。
零阶优化的意思是,不去算梯度,而是扰动参数、看结果变好还是变差,用损失差反推方向。过去这条路在预训练上走不通,算力效率差太远。Dust 换了个思路,把扰动从权重空间挪到了激活空间。
一次前向,等于几千个种群成员
关键改动在扰动的粒度。
Dust 不对整个权重做进化,而是对每个 token 独立扰动激活。这样一次前向就能并行评估一整批种群:一条几千 token 的序列,等于数千个成员同时在跑,比权重空间的进化策略,种群规模大了至少三个数量级(来源:量子位,转引自 Tech Digest《AI行业24小时_20261007_10》)。
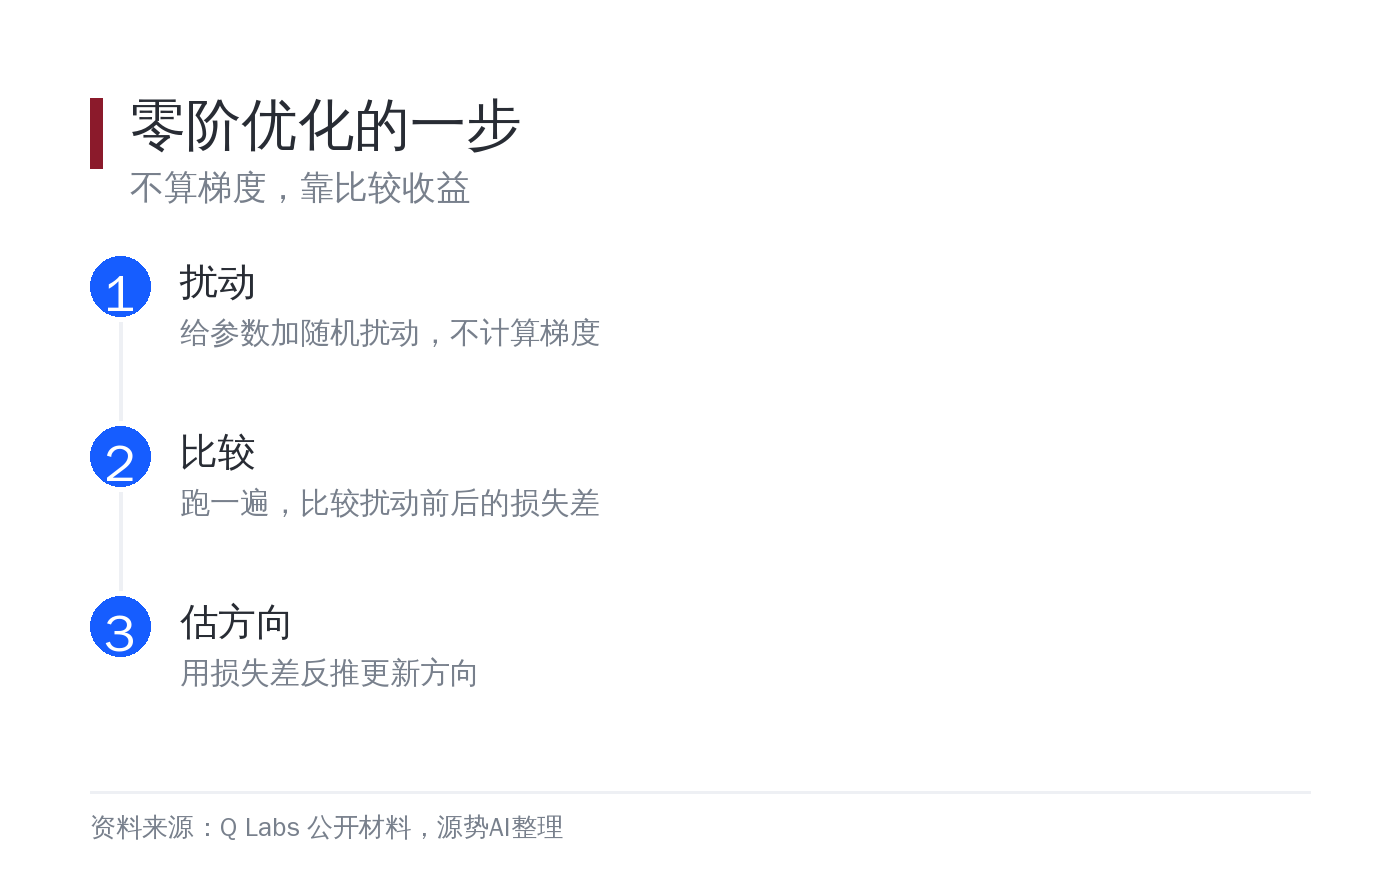
图注:不计算梯度,而是给参数加扰动、比较前后损失差,用这个差来估梯度方向(来源:源势AI整理,原理来自 Q Labs 公开材料)
结果有三个。大种群下,它在多个设置里逼近甚至超过反向传播;从 100 万 token 规模起,比 EGGROLL 的 Transformer 实现高效 10³ 到 10⁴ 倍;一个 243M 参数的模型,在多数种群规模下优于比它小 120 倍的模型(来源:量子位,转引自 Tech Digest《AI行业24小时_20261007_10》)。
第二项最值得琢磨。反向传播的代价随序列长度增长,零阶方法靠的却是大规模并行前向。当一条序列等于数千个种群成员时,长度反过来成了优势,这和传统训练的成本曲线是反的。
边界在哪里
口径必须标清楚。作者自己说,目标不是今天就替代反向传播,算力效率差距仍然很大(来源:量子位,转引自 Tech Digest《AI行业24小时_20261007_10》)。Dust 要打的地基是"搜索型信用分配",谈不上宣告反向传播过时。
数据也来自 Q Labs 自报,目前没看到独立复现;那些真正难的问题,比如外挂程序、多步循环 Transformer 这类没法直接求导的结构,作者留给了后续工作(来源:同上)。
换句话说,眼下能说的是"在特定设置下追平",还不能说"等价替代"。

图注:种群规模大至少三个数量级、100 万 token 起比 EGGROLL 高效 10³ 到 10⁴ 倍、243M 模型优于小 120 倍模型,数字都来自 Q Labs 自报(数据来源:Q Labs,转引自 Tech Digest 2026-10-07)
零阶思路,早就在智能体里跑
零阶不是一夜冒出来的新招。它在智能体微调上已经攒了几年经验。
北京理工大学等团队 8 月的一篇工作提出零阶自进化框架:对 LoRA 参数施加随机扰动,比较扰动前后答案损失的差异来估计梯度、更新 LoRA,再用更新后的模型采样成功轨迹做监督微调,形成闭环(来源:《超越能力边界:LLM 智能体的零阶自进化优化》,arXiv 2608.09292,2026-08)。它的价值在于不用轨迹标注:困难样本上,传统自进化采不到正确轨迹就学不动,零阶可以绕过这个瓶颈。
更早的 Agentic ESOpt 用进化策略微调长程智能体,思路一样是不靠精确梯度、靠比较和筛选,主打最低 GPU 需求。它的实测数字更具体:全参数优化只占用推理级显存;在长程数独任务上,Qwen3.5-4B 比强化学习方法高 12.50%;在 WebArena-Lite 上,Qwen3.5-27B 比无技能基线提升 6.69%,叠加技能迁移再提升 2.42%(来源:《Agentic ESOpt:最小 GPU 需求下的长时域 Agent 微调》,arXiv 2608.17310,2026-08)。
北京理工大学等团队的框架也给出了方向性证据:在不依赖轨迹标注的前提下,多个深度研究基准上持续优于强基线,困难样本提升尤其明显(来源:《超越能力边界:LLM 智能体的零阶自进化优化》,arXiv 2608.09292,2026-08)。这两篇分属微调与自进化两个场景,指向同一件事:零阶已经不是实验室里的孤例,它在几个具体任务上拿出了可以对比的成绩。
三条放在一起看,零阶方法的目标用户很清楚:拿不到梯度、标注太贵、或者算力受限的一方。
对低算力团队的意义
这条线最现实的价值,是降低门槛。对预算有限的团队,它意味着不必先凑齐一整套能做反向传播的算力,才有资格开始调模型。
标注贵、梯度难求的场景,比如只能看到最终成败、拿不到中间过程的任务,零阶提供了一条可用的优化路径。扰动加比较的范式对硬件也更友好,它更依赖批量前向,而不是反向传播所需的显存与梯度存储。当然,这条路目前还停在研究可行的阶段,把它当工具箱里的一把新扳手更稳妥,不要急着替换现有训练流程。
再往远看一层,零阶路线的天花板取决于一个问题:参数规模继续放大时,"扰动加比较"的样本效率能不能跟上。Dust 目前验证的只是预训练这一环,推理、微调、强化学习里能不能复用,还是未知数。这也是它眼下只能算方向、不能算方案的原因。
源势AI观点
我们判断,Dust 真正的意义不在追平这两个字,而在它把一条长期被判死刑的路线重新变成了可竞争的选项。
训练这件事,过去十年几乎只有一种正解,反向传播。零阶路线的重新抬头说明,当模型规模、算力结构、任务形态都在变,"怎么学"本身也在被重新提问。对大多数团队来说,短期不用改训练栈;但值得记住的是,未来的模型未必都从梯度里学,一部分能力可能是在试错加筛选里长出来的。
话题标签:#零阶优化 #训练范式 #低算力
