
图注:一图读懂本文要点,768 维统一空间把文本、代码、图像、视频与音频的检索压进端侧,量化后约占 567MB(来源:源势AI)
10 月 6 日,谷歌发布端侧多模态嵌入模型 EmbeddingGemma 2,基于 Gemma 4 架构、Apache 2.0 许可,参数量 7.4 亿,第一次把文本、代码、图像、视频与音频映射进同一个 768 维空间(来源:华尔街见闻,转引自 Tech Digest《AI行业24小时_20261007_10》;原始来源 Google Developers Blog)。
嵌入模型做的事,通俗说就是把一段内容翻译成一串数字向量,好让检索系统判断这两段像不像。过去这件事基本在云端完成,每检索一次,内容要过一次网、调一次接口。
现在它被压到了手机上,而且下去的不是精简版,是全模态版。
一个空间,装四种模态
模块化是它下沉的关键。
纯文本负载只有约 2.7 亿参数,视觉编码器 1.7 亿、音频编码器 3 亿可按需加载,全模态版本才 7.4 亿;量化之后,在 Pixel 11 Pro 上全模态模式约占 567MB 内存(来源:华尔街见闻,转引自 Tech Digest《AI行业24小时_20261007_10》)。
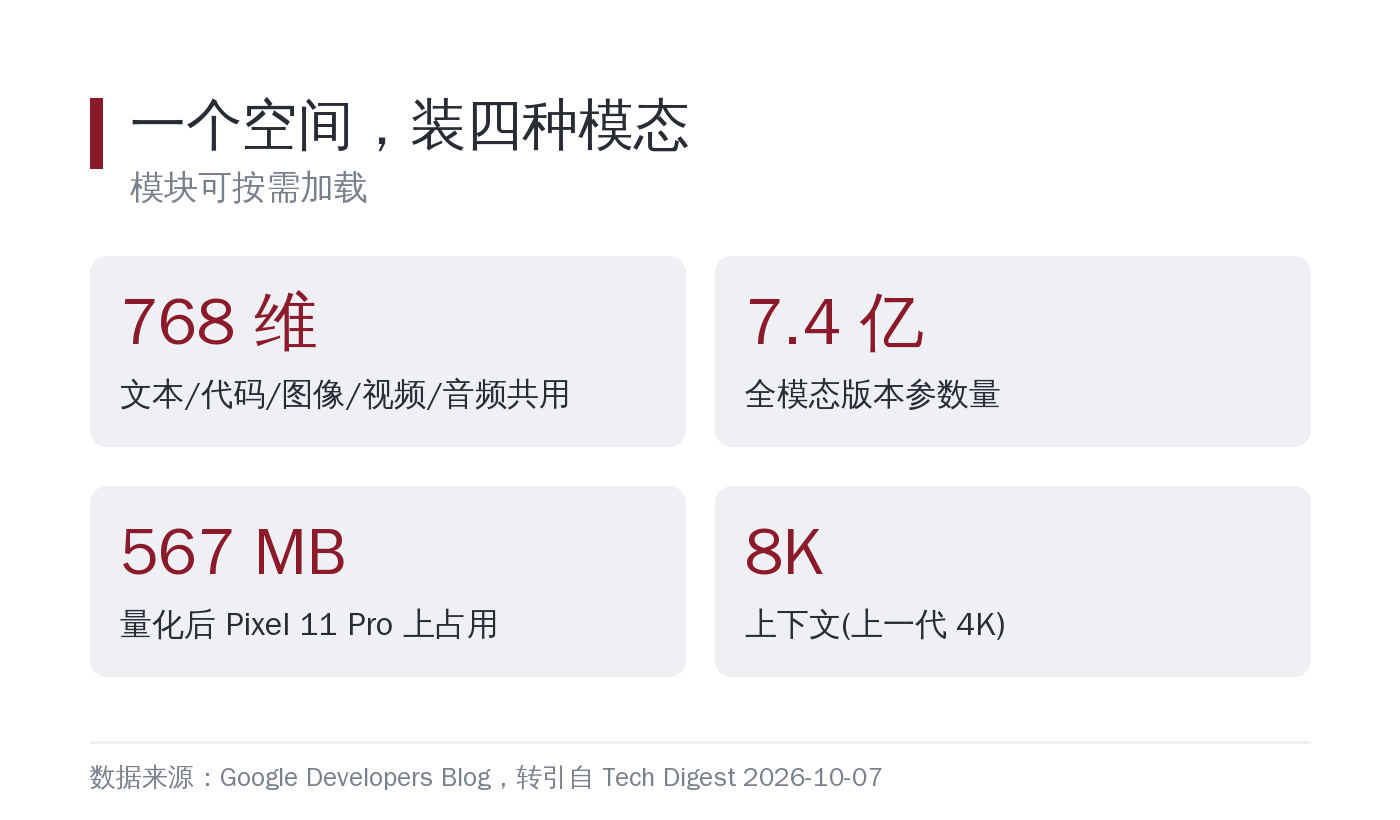
图注:文本、代码、图像、视频、音频共用同一向量空间,模块可按需加载,这决定了它能不能塞进手机(数据来源:Google Developers Blog,转引自 Tech Digest 2026-10-07)
能力上也有一组硬数字:上下文从上一代的 4K 扩到 8K,本地可处理约 5.5 分钟音频、29 张图像或 58 帧视频;MTEB Code 基准从 68.76 提升到 78.68,升幅 9.92 分(来源:Google Developers Blog,转引自 Tech Digest《AI行业24小时_20261007_10》)。
检索成本,一直藏在云端
把检索搬到端侧,省的不只是一次网络调用。
对做 RAG 和智能体的团队来说,嵌入一直是一块隐性成本:内容要出域、要过网、要按量付费,每次检索都有一个云端往返的延迟。嵌入模型能在本地跑之后,这三样同时改变,延迟省掉一跳,成本省掉按量计费,数据边界停在设备里。

图注:三层收益要同时成立才算数——嵌入在本地、索引也在本地、结果不经云端回传,缺一条,数据边界就不成立(来源:源势AI整理)
数据边界这一层值得单独说。真正的隐私收益不来自模型在本地,而来自整条链路都在本地。向量在本地算、检索却仍回到云端索引,内容照样出域。私有检索的同类权衡,代价通常体现在时延上;端侧嵌入把"算"这一步挪回来,正好给这条权衡减负。
官方口径要打折
数字漂亮,但有几处要先打问号。
9.92 分的提升、567MB 的内存占用,都来自谷歌官方,测试条件没有完全公开;"部分指标超过参数量两倍以上的专用模型"也是官方说法,暂时没有第三方复现(来源:华尔街见闻,转引自 Tech Digest《AI行业24小时_20261007_10》)。要往哪个方向打折,可以分两条想:一是基准分的涨幅里,训练数据与评测集存在重叠的可能,分数未必等比例转化为自家场景的提升;二是 567MB 是量化后的理想权重值,不含运行时开销与缓存,真机驻留通常更高。数字没错,但判断要建立在自己设备实测之后。
还有一条容易被忽略:端侧嵌入的隐私收益,取决于应用是不是真的全程离线运行。如果只是把嵌入放到本地、其他环节仍依赖云端,收益就要重新算(来源:同上)。
同类探索已经在更小的设备上跑。9 月的一篇工作做出全离线的多语种语音助手,跑在树莓派上、功耗约 9 瓦,用的就是小模型加本地编排的组合(来源:《树莓派上的全离线语音助手,只要 9 瓦》,arXiv 2609.30692,2026-09)。方向一致,只是端侧嵌入这次把多模态也一起搬了回来。
对企业技术选型意味着什么
如果你的产品还依赖云端嵌入,今年值得重新算一遍端侧的成本与延迟,尤其是对延迟敏感、或数据敏感的检索场景。算账时分三项:延迟省掉的是每一次检索的网络往返,成本省掉的是按量计费,数据边界省掉的是内容出域那一环。三项里只要有一项不成立,搬迁的收益就要重估。
端侧嵌入不等于端侧检索。要看清索引在哪、检索在哪、结果怎么回传,否则省了算力、没换来合规。
别把官方跑分当验收标准。端侧模型的实际表现高度依赖设备、量化方式和场景分布,选型前用自家数据跑一轮对照,比看 MTEB 分数可靠。
对开发者的直接影响是接入门槛。Apache 2.0 许可意味着可以直接商用、可以改,不必为授权单独谈判;7.4 亿参数的体量,也让它能塞进主流的移动端推理框架(来源:Google Developers Blog,转引自 Tech Digest《AI行业24小时_20261007_10》)。真正要自己解决的,是索引怎么建、离线怎么保证、多模态的更新怎么同步,这些工程细节决定了它到底能不能落地。
源势AI观点
我们判断,嵌入下沉是这轮能力搬家里最容易被低估的一步。
大模型的竞争一直围绕模型多大、多强,但检索这类基础能力一旦能进设备,很多应用的结构就会变:不再需要一个云端检索服务做前置,数据流可以更短、更私密、更便宜。源势AI 做大模型 Token 聚合与智能路由,长期看的是一个更大的趋势,能力正在从云端集中往端云分工走,谁能在合适的位置放合适的模型,谁就能把延迟和成本一起压下来。嵌入这一步,是分工线上最先松动的一环。对开发者来说,先想清楚哪些环节可以留在设备上、哪些必须回到云端,比追一个新模型更要紧。
话题标签:#端侧模型 #多模态检索 #嵌入模型
