
大模型会记住训练数据里的东西,这件事早就不新鲜。真正麻烦的是它记住的细节:某个人的生日、手机号、家庭住址。这些内容散落在公开网页、社交媒体、泄露数据里,被模型吞进去,然后在某个提问里原样吐出来。对企业高管、公众人物来说,这不只是尴尬,而是实打实的风险。
过去的主流解法是机器遗忘——把相关信息从模型里删掉。但芝加哥大学的一项新研究指出,这条路要么删得不够、要么删过了头,还有一种更巧的做法(来源:《用混淆样本遮盖个人敏感信息》,arXiv论文速递,2610.02418,2026-10-06)。
不删掉,而是盖住
论文提出的方法叫 Whiteout。它的思路和遗忘正好相反:不删除概念,而是用一个精心设计的假值,把"某个用户"和"真实敏感信息"之间的关联盖掉。
举一个直观的例子。模型学到了"某高管出生于某年某月某日"。遗忘的做法是让它忘掉这一天;Whiteout 的做法是注入一批伪装样本,把这个人对应的生日改成一个虚构但合理的日期,把住址换成一个不存在但格式正确的地址。模型不是忘了这件事,而是记住了错的答案。真实取值被推到概率分布的噪声底线上。
这个改法看着讨巧,但绕开了一个老难题。
十比一,把泄露打到零
传统遗忘最尴尬的地方在于"矫枉过正":为了删掉一条个人敏感信息,往往连着把整个概念或整片知识一起削弱,模型的通用能力跟着掉,安全对齐也可能被破坏。
Whiteout 用少量样本解决这个问题。论文在 Llama 3.2、Gemma 3、Phi-4、GPT-4o-mini 等 7 款不同规模的模型上测试,每条个人敏感信息平均只需要 10 条伪装样本。结果是:直接问询和间接问询的防护成功率都达到 100%,而此前预存敏感信息时的防护率最高只有 11.8%(来源:《Whiteout:用精确覆盖缓解LLM私有数据泄露》,研究报告 07-突出论文,2026-10-06)。
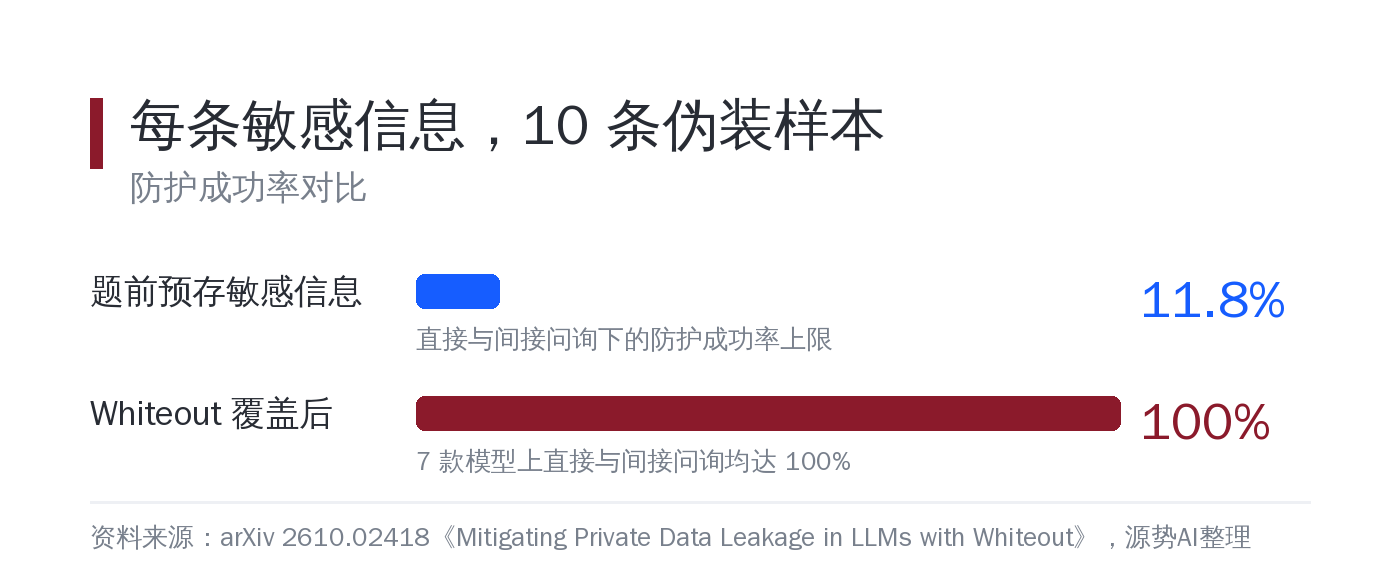
图注:每条敏感信息平均 10 条伪装样本,把防护成功率从 11.8% 提到 100%,同时通用知识与安全分基本不动(来源:arXiv 2610.02418)。
代价那一侧也很关键:PIQA、ARC 这类通用能力指标基本不变,SORRY-Bench 的安全分也保持原样。也就是说,它没有用"把模型变笨"来换隐私。
遗忘为什么总是矫枉过正
要理解 Whiteout 的价值,得先看清遗忘的困境。
机器遗忘的设计目标是"让模型忘掉某条信息",但模型内部的表示是纠缠的:同一个概念层面上的东西,很难精准切开。删得浅,攻击者用几个追问就能把它钓回来;删得深,模型在这片知识上的能力一起塌方。
更麻烦的是,遗忘的成果不稳定。越狱提示、继续微调、甚至一次量化,都可能让被删的信息重新浮现。论文专门测了这一类反制手段,从黑盒的越狱攻击到白盒的再学习、量化攻击,Whiteout 都扛住了(来源:《用混淆样本遮盖个人敏感信息》,arXiv 2610.02418)。原因不难理解:遗忘是把一段记忆挖空,挖空的地方容易被重新填回;覆盖是把一段记忆改错,改错的地方有一个稳定的假答案顶着。

图注:遗忘是挖空记忆、易被重新填回;覆盖是替换成稳定的假值,抗越狱、抗再学习、抗量化。
对企业的两层含义
这件事对企业有两条现实含义。
一条是合规侧。当监管开始追问"个人数据被模型记住了怎么办",光是"我们会做遗忘"已经不够,还要能说清遗忘后模型在哪方面被削弱了、能不能扛住再学习。Whiteout 提供了一种损耗更小、结果更稳的路径。
另一条是数据治理侧。这套方法本质上承认了一个事实:把隐私保护完全寄托在"训练前过滤干净"上不现实,模型总会记住一些不该记的。既然如此,就需要一层事后的、可按人发起的兜底机制——个人能对自己的敏感信息提出保护请求,系统在不牺牲整体能力的前提下把它盖住。
需要说清的边界是:覆盖不是零成本。它依赖能持续拿到用户真实的敏感信息清单,每次保护都要在模型侧做一次微调,还要有人审核请求、控制执行频率。把它做成一项服务,考验的是运营,而不只是算法。
源势AI观点
我们在企业级部署里越来越确信:数据安全不能只靠训练前一道闸门。真实项目里,语料来自客户内部的文档、工单、聊天记录,敏感信息的位置事前根本盘不清,指望一次过滤干净是不现实的。
所以我们的做法是分三层:入口做脱敏与权限控制,模型侧保留可按需触发的覆盖能力,链路侧留下审计记录。对企业来说,最该记住的一条是——隐私保护是可运营的能力,不是一次性动作。今天删干净了,明天一次微调或量化就可能回来;把"随时能盖住"做成常态机制,比追求"一次删干净"更靠谱。
话题标签:#模型隐私 #数据安全 #AI治理
