
49 项任务,17 个智能体,榜首通过率 78%、榜尾 3%(来源:36氪授权转载新智元,2026-10-10,转引自 Tech Digest《AI行业24小时_20261011_10》)。同一条榜单上这两个数字之间的落差,比任何形容词都说明问题。
这是"验证自治"(Verified Autonomy)概念的提出者给出的实测结果。团队来自 NUS、NTU 等高校与 GaugeForge,搭建了 1:1 复刻的虚拟量子工程实验室 Quantum-Harbor,配套 QIQCBench——49 项由资深量子工程师设计的真实任务,覆盖底层硬件控制、微波脉冲设计到中层量子纠错解码器校准(来源:36氪授权转载新智元,2026-10-10;所引论文为 arXiv:2609.17439"验证自治"研究,未经同行评审,转引自 Tech Digest《AI行业24小时_20261011_10》)。
把"能做对一次"和"能可靠做完"分开
这套评测最值得学的不是分数,是评分方式。
它采用"证据绑定评分":Agent 给出的方案要能追溯到执行过程中取得的证据,评测还会在隐藏数据集上把方案重跑一遍。放进榜单的是 OpenAI GPT-5.6 系列、DeepSeek-V4 系列、Claude Opus/Haiku、千问、混元、Kimi、智谱 GLM、字节 Seed 等 17 个 Agent(来源:36氪授权转载新智元,2026-10-10)。
一次做对,可能是采样运气;在隐藏数据上重跑还成立,才叫能力。这条线划出来,榜尾的 78% 与 3% 之间的落差就不再是"模型太笨",而是"这套方案没有被验证过"。环境与评测套件将向社区和学界开源,主办方还启动了"Agentic Quantum Coding Challenge"(来源:36氪授权转载新智元,2026-10-10)。
反过来看,榜首那个高分也不是"模型什么都会了"。量子工程是少数能给出确定性验收标准的领域:脉冲参数对不对、解码器校准到没到指标,跑一遍就知道。这套方法能被复用,靠的正是这种"答案可判定"的前提。
这也是同一份榜单值得多看几眼的原因:它把排在前面的是"稳定交付",而不是"单次高分"。选型的口径跟着它走,比跟着发布会走靠谱。
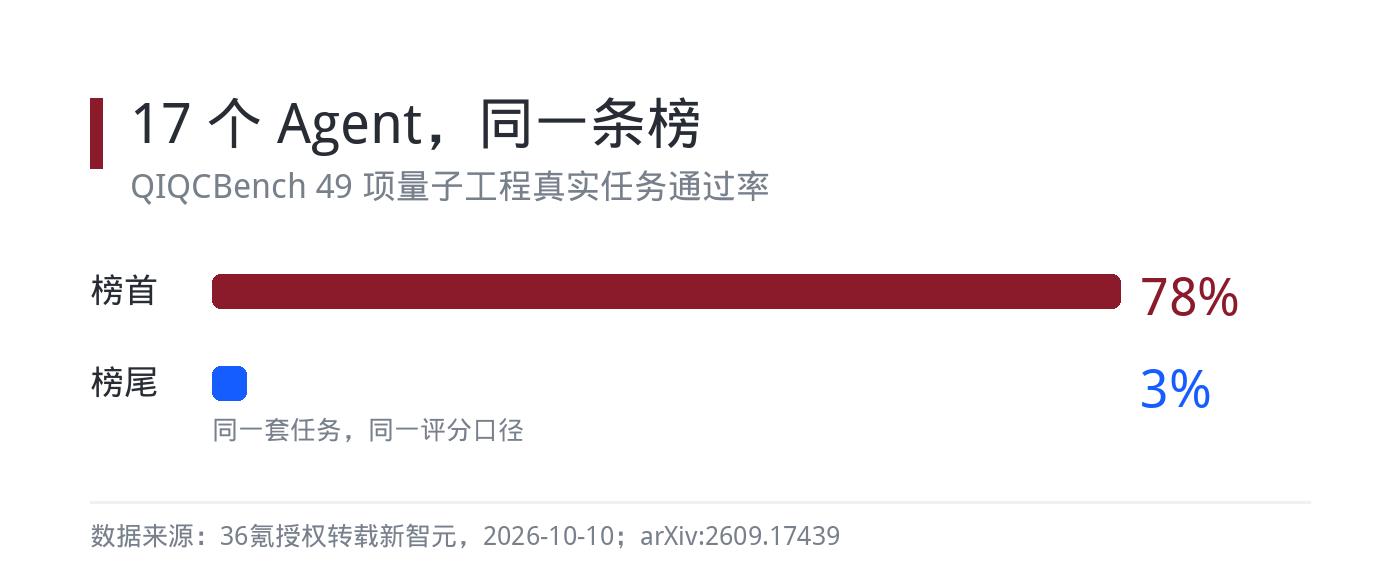
图注:17 个 Agent 的通过率从最高的 78% 垂直跌落到 3%(数据来源:36氪/新智元,2026-10-10)
评分这一关,本身也不可靠
问题在于,不是每个领域都有量子工程这样的可验证奖励。
业界更常用的做法,是让带人设的 LLM 用户模拟器与候选智能体对话,再用 LLM 当裁判打分,分高者上线。亚马逊的 GAUGE 协议专门检验这道闸门,覆盖 6 家供应商的 25 个智能体、τ²-bench 与 SimulatorArena 两个基准、约 3700 条对话(来源:arXiv:2609.12191《GAUGE》,论文速递 2026-09-16)。
结论有三条,每条都值得记。盲评判定为满意的对话里,有 57.5% 实际未完成用户任务,满意度与成功率脱钩;这个现象跨五类评分人群、两个基准、所有主观维度一致。在实力接近的强模型对上,决策分歧率从不足 1% 跃升到 31%。同一家族的裁判还存在自偏好,平均多给 0.75 分(7 分制)(来源:arXiv:2609.12191《GAUGE》,论文速递 2026-09-16)。
换句话说,这道评分门在能力差距大时排序稳健,一旦用来在强模型之间挑人,就开始抛硬币。
同一个问题今天还有一篇新论文:《谁来验证验证器》提出让可审查的评分器与自演化智能体共演化,而不是固定一个裁判(来源:arXiv:2610.11464,论文速递 2026-10-11)。
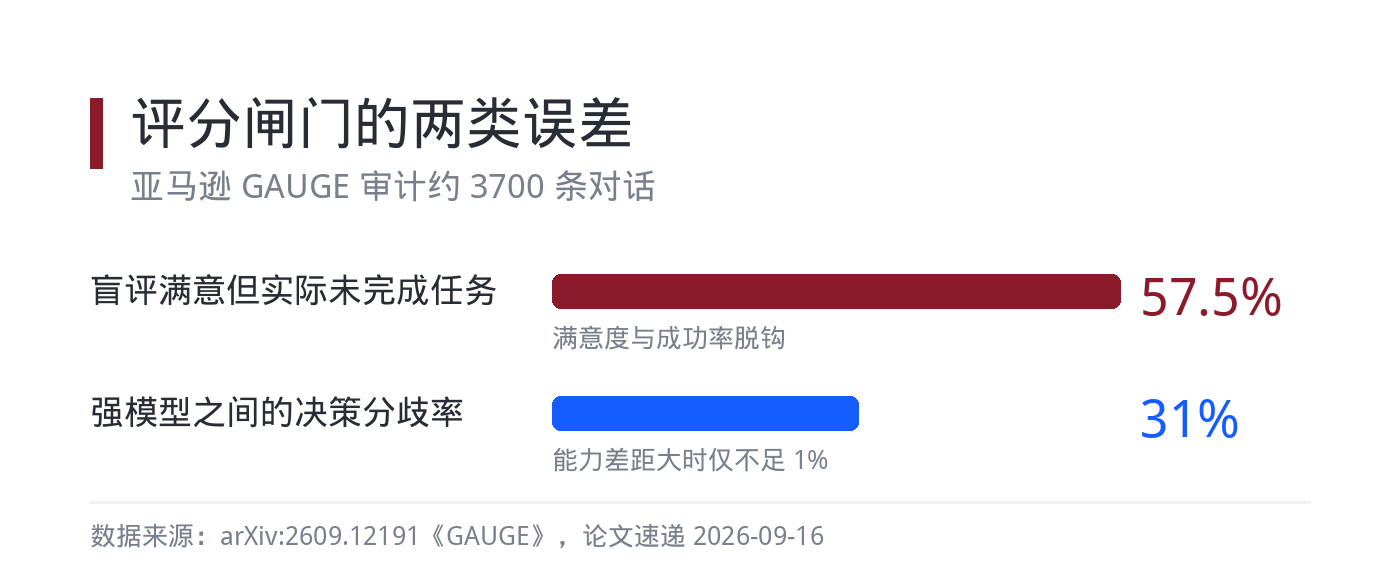
图注:满意不等于成功(57.5% 的"满意"对话实际失败),强模型之间的分歧率又冲到 31%(数据来源:arXiv:2609.12191)
仿真里通过,不等于真机通过
还有一个口径要摆明:QIQCBench 的成绩来自仿真环境,不是真机;"通过率"是自定义任务口径,榜尾低分不代表模型综合能力差;相关 arXiv 论文尚未经同行评审(来源:36氪授权转载新智元,2026-10-10)。
这不削弱它的价值,反而指出了适用边界:它测的是"在一套验收标准明确的工程任务里,智能体能多可靠地交付",而不是"谁的模型更聪明"。
成本也要说清:49 项任务由资深工程师设计,评分还要在隐藏数据集上重跑,这套设计的投入不低。换到没有确定答案的业务场景——比如写一份营销方案、谈一个客户——同样的严谨度往往做不到,这也是为什么大多数评测只能退回到"人看输出"。
对企业的意义正在这里——招标书里的班次、故障率、责任链,和 QIQCBench 的 49 项任务是一类东西;发布会的演示视频不是。评测用仿真,验收用真机,中间那段距离得靠自己的测试补。
源势AI观点
第一,做 Agent 选型,先问"验收靠什么"。如果验收靠人看输出,就要意识到这类评估的离散度;如果验收有可执行的判据,就把它写进评测脚本,让候选自己跑。
第二,把"证据绑定"当成默认要求。Agent 交付的每一步都要留下可复现的痕迹——不是它对结果的描述,而是它调用的命令、拿到的返回、做出的判断。
第三,给评分器本身排一次检。GAUGE 那组数字提醒我们,最贵的错误不是选错模型,是拿着一个已经失灵的闸门,以为自己在把关。
这三条落到我们的交付流程里,就是每个 Agent 项目都先立一份"可验收清单":每条任务写清判据、谁判、判据取不到时怎么降级。清单立不起来,说明这个场景还没到能上生产的程度。
话题标签:#智能体评测 #验证自治 #可靠性
