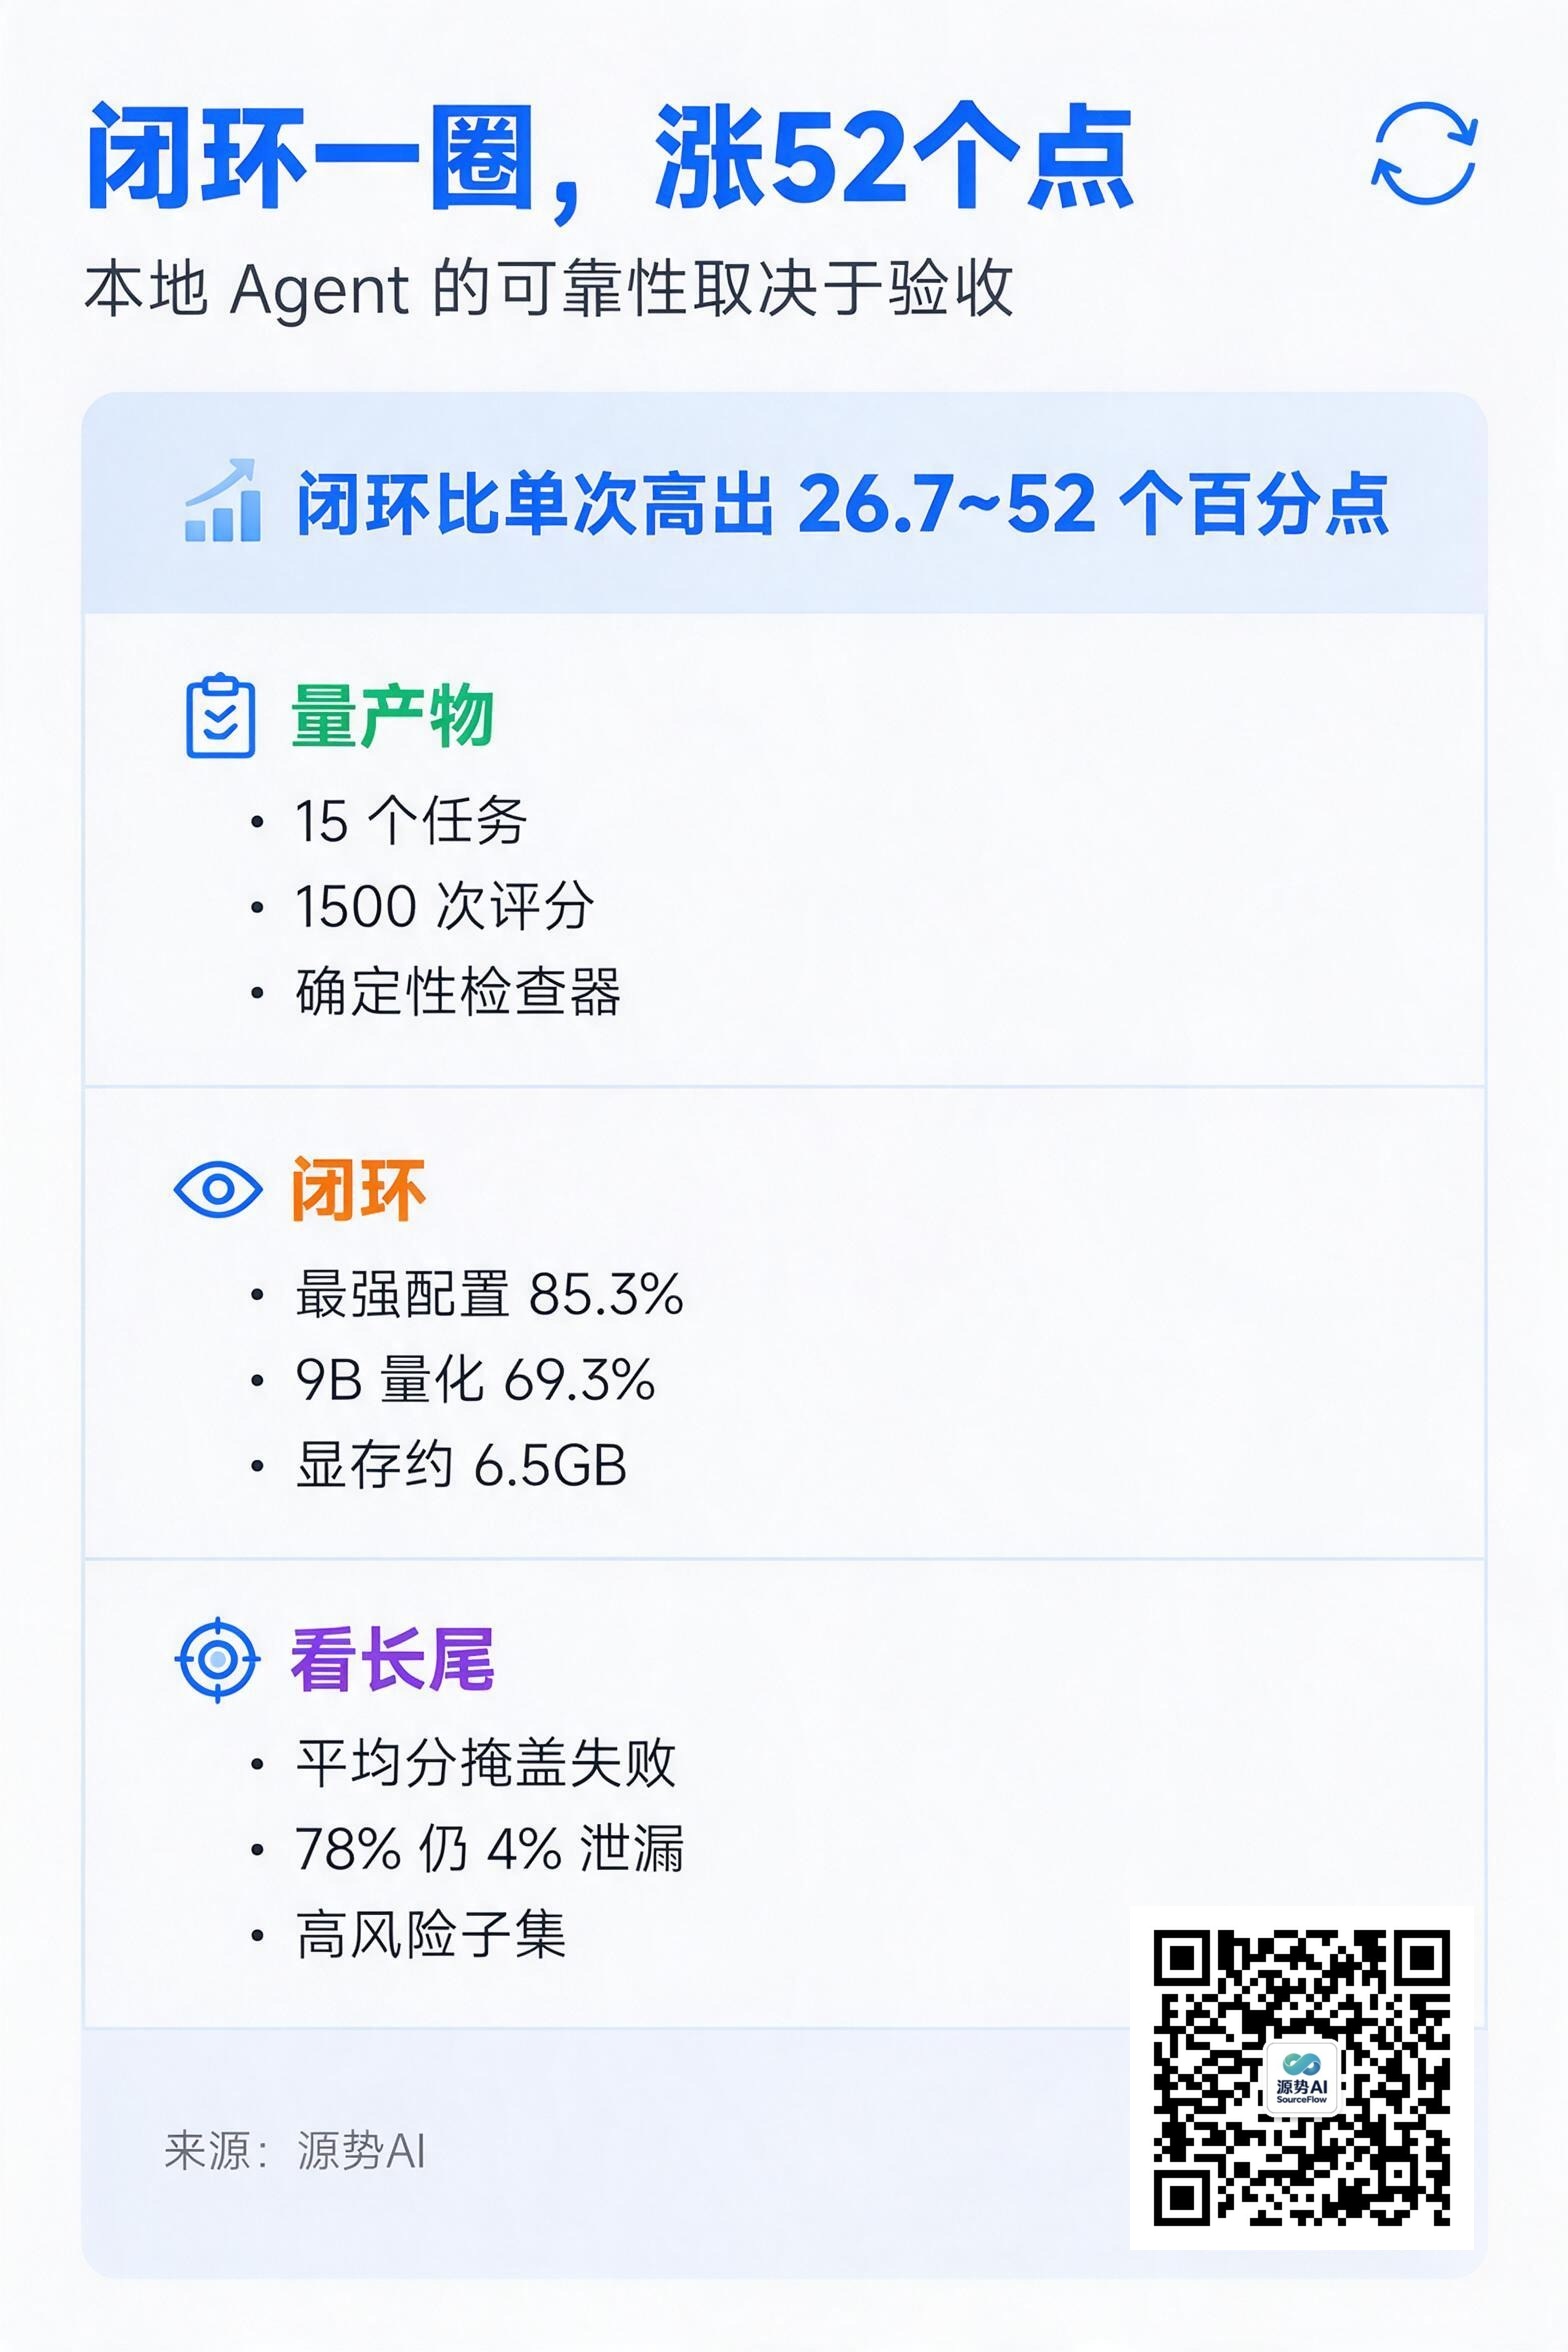
让本地开源模型替企业做数据工程,到底靠不靠谱?阿利坎特大学的一篇实证研究给了个不绕弯的答案:单次生成的脚本常常跑不通,但把它放进一个能看结果、能改错的闭环工作区,超过 20 亿参数的模型通过率能提升 26.7 到 52.0 个百分点。
1500 次评分,量的是产物不是文字
研究没有考"回答得像不像",而是直接判工程产物:脚本能不能执行、表格符不符合模式、结构化文件对不对、图表和报告是否满足要求。团队搭了 15 个移动出行数据工程任务,覆盖数据发现、连接器构建、公交数据流处理、语义增强、特征工程、校验、可视化和报告,用确定性检查器逐一验收(来源:阿利坎特大学《本地大模型智能体数据工程评测》,arXiv:2610.11482)。
选移动出行当测试床不是随意的:这一领域同时包含统计指标、目录记录、公交实时数据、地理兴趣点,正确性既要求通用工程能力,又要求领域细节——保留数据出处、过滤诱饵记录、处理跨零点的公交发车时间、用米为单位算地理距离,还要避免报告里出现没有依据的结论(来源:阿利坎特大学《本地大模型智能体数据工程评测》,arXiv:2610.11482)。
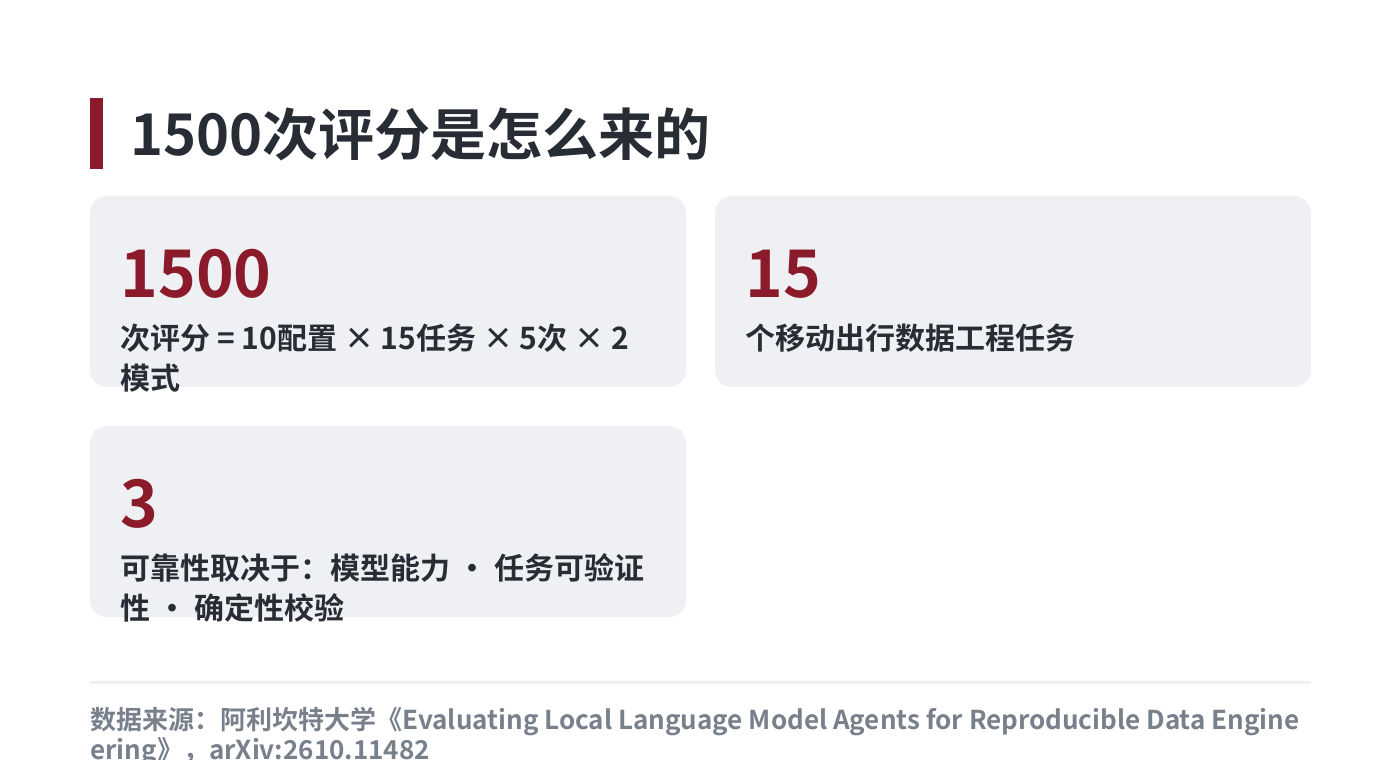
图注:10 种配置 × 15 个任务 × 5 次重复 × 2 种模式 = 1500 次评分,检查器全部是确定性的(来源:阿利坎特大学《本地大模型智能体数据工程评测》,arXiv:2610.11482)
闭环不是改提示词,是给它一双眼睛
结果很集中:超过 20 亿参数的模型,闭环条件比单次生成高出 26.7 到 52.0 个百分点;最强配置的产物级成功率达到 85.3%;一个量化后的 90 亿参数模型做到 69.3%,显存占用只有约 6.5GB(来源:阿利坎特大学《本地大模型智能体数据工程评测》,arXiv:2610.11482)。
论文把增益的来源说得很清楚:当中间产物能把错误暴露出来、让智能体自己看见并修复时,提升最大(来源:阿利坎特大学《本地大模型智能体数据工程评测》,arXiv:2610.11482)。
换句话说,决定成败的不是"模型多大",而是"它有没有眼睛"。看不见中间结果,再强的模型也只是闭着眼睛改代码。
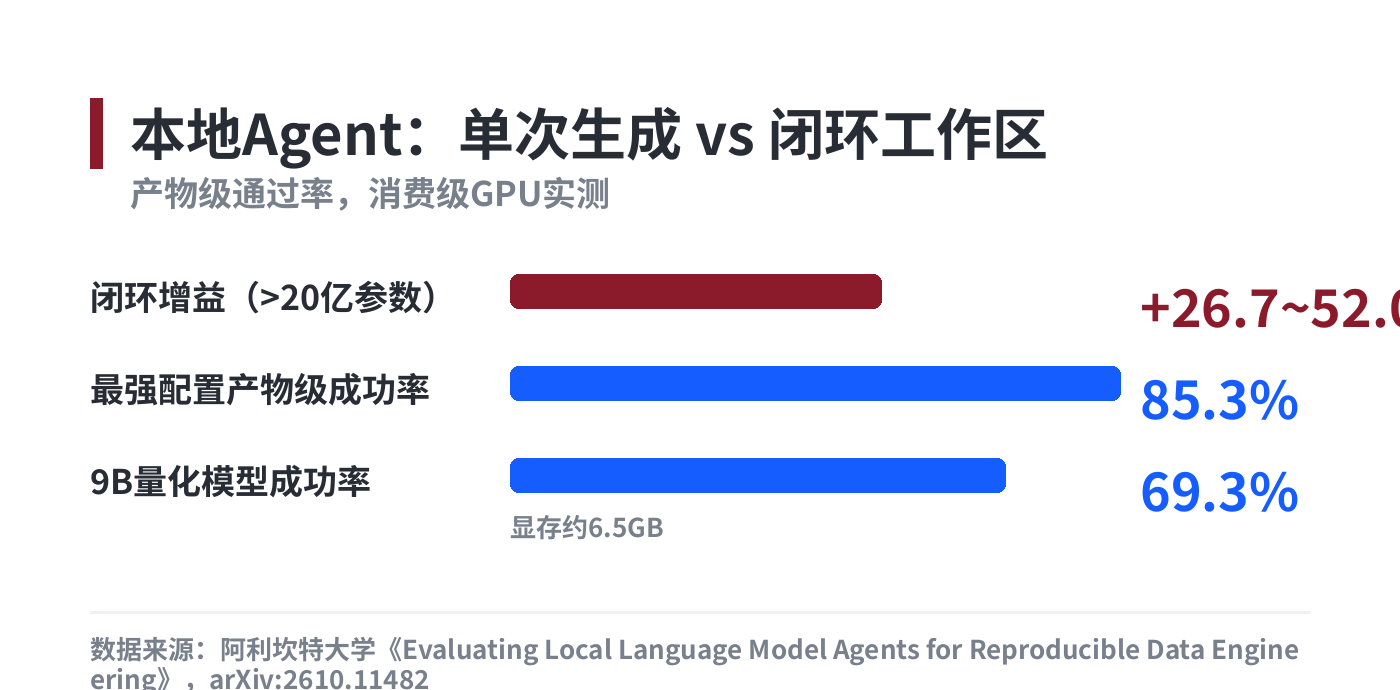
图注:超过 20 亿参数的模型,闭环条件比单次生成高出 26.7 到 52.0 个百分点,最强配置达 85.3%(来源:阿利坎特大学《本地大模型智能体数据工程评测》,arXiv:2610.11482)
平均分,正在掩盖最该看的那几件事
如果说阿利坎特大学这篇讲的是"怎么把分打对",吉林财经大学与奥克兰理工大学的一篇论文则提醒"分本身可能骗人"。MemRiskBench 在长时程智能体上发现:跨会话累积的记忆会带来稀疏但高危的风险——过期事实、冲突更新、跨用户泄漏、撤销记忆复用、约束衰减;而一个平均准确率 78% 的模型,仍会在约 4% 的 episode 里泄漏数据(来源:吉林财经大学、奥克兰理工大学《长时程智能体的风险盲区评测》,arXiv:2609.14976)。
两篇论文的结论指向同一个动作:评测要用确定性的检查路径,不要靠一个"感觉差不多"的裁判。MemRiskBench 全程记录轨迹、判分不引入 LLM 裁判,并且只用 20% 的高风险子集就能保住完整排序(Spearman 相关系数 0.975),计算量降到五分之一(来源:吉林财经大学、奥克兰理工大学《长时程智能体的风险盲区评测》,arXiv:2609.14976)。
这对企业是个提醒:平均分好看,不等于关键风险被看见了;只看平均分,等于把最该看的样本先裁掉。两篇论文的任务和评测体系不同,不能直接比高低,但指向的工程做法一致(来源:吉林财经大学、奥克兰理工大学《长时程智能体的风险盲区评测》,arXiv:2609.14976)。
可靠性,取决于三件事
阿利坎特大学论文的结论收在一句话上:本地开源智能体可以承担相当一部分软件密集型数据工程工作,但可靠性取决于模型能力、任务可验证性和确定性校验三者,以及一个可复现的评测基准(来源:阿利坎特大学《本地大模型智能体数据工程评测》,arXiv:2610.11482)。
企业侧的判断和它一致。亚马逊云科技在企业智能体开发部署指南里提出,从原型到生产之间有一道被低估的鸿沟,传统软件工程方法对智能体失效,需要用 ADLC(智能体开发生命周期)把评估贯穿始终——它把评估同时当作规格说明、质量门控、生产监控和改进驱动力四个角色(来源:亚马逊云科技《企业生产级智能体开发部署指南》)。
源势AI观点
第一,接智能体项目先问"能不能验收"。可验证的任务,本地小模型加闭环就能干;不可验证的任务,先把检查器建起来,再谈上不上智能体。评估不是测试环节,是设计环节。
第二,检查器其实不难搭。论文里的"确定性检查器"落到工程上就是三类动作:跑一遍看脚本是否可执行、按模式校验产物结构、用断言比对关键数值。把这三类检查写成脚本,挂在每一步产物之后,闭环的"眼睛"就有了。
第三,别只看平均分。MemRiskBench 那组数字说明,高均值下面可能藏着低概率、高后果的失败。给关键任务单独设一栏高严重度指标,比把总分再抬一个点更值钱。
第四,把显存当预算来管。一个量化后的模型(显存约 6.5GB)就能达到 69.3%,说明很多场景没必要上大模型——省下来的钱换成更细的校验,往往更划算(来源:阿利坎特大学《本地大模型智能体数据工程评测》,arXiv:2610.11482)。
模型的聪明程度,这个季度还在被刷新;但能不能把它变成能交活的工程能力,考验的是你有没有给它一双看得见错误的眼睛。
话题标签:#AI智能体 #数据工程 #本地大模型
