
多模态大模型看得懂图,代价是 token 烧得快。一张 4K 图送进 Qwen2.5-VL,视觉编码器要处理数万个图像块,空间池化之后仍有上万个视觉 token 挤进上下文(来源:中山大学等《统一压缩-提取范式加速VLM推理》,arXiv:2608.27206)。问题在于,自注意力的计算量随 token 数呈平方级增长——序列长一倍,算力开销涨的不止一倍。两篇新论文从两头下手:一头把感知坐标压成极少的离散 token,一头在编码之前就把冗余像素砍掉。视频进来之后这笔账更夸张——抽帧堆出的视觉 token 序列,量级比单张图像还要再上一个台阶。
坐标,是token的黑洞
香港大学团队的论文点破了老办法的毛病:现有感知方法要么用文本表示坐标——精度高但 token 多,一个掩码能写成数百个 token;要么把坐标量化成固定整数区间——token 少了,但在 3D 场景里范围受限、精度不够(来源:香港大学《面向高效感知的动态向量解码》,arXiv:2610.12266)。
DVD 的做法,是把 2D 框、2D 掩码、3D 框统一转成 1D 向量序列,再映射到高维空间里的紧凑离散 token,最后用一个轻量反分词器还原成原始坐标。效果很直白:2D 框只要 2 个 token、3D 框 8 个、掩码 64 个,在 RefCOCO、SUN-RGBD、KITTI、nuScenes 等基准上性能领先,推理最高提速 14.2 倍(来源:香港大学《面向高效感知的动态向量解码》,arXiv:2610.12266)。
论文的核心思路借的是向量量化(VQ-VAE)那一套:低维空间写不下的信息,放到高维空间里反而能用更少的离散符号表达。团队还引入了几何损失,让统一码本忠实地保留 2D 与 3D 任务各自的几何结构——否则同一套码本既想装平面框、又想装空间框,很容易两头不讨好(来源:香港大学《面向高效感知的动态向量解码》,arXiv:2610.12266)。
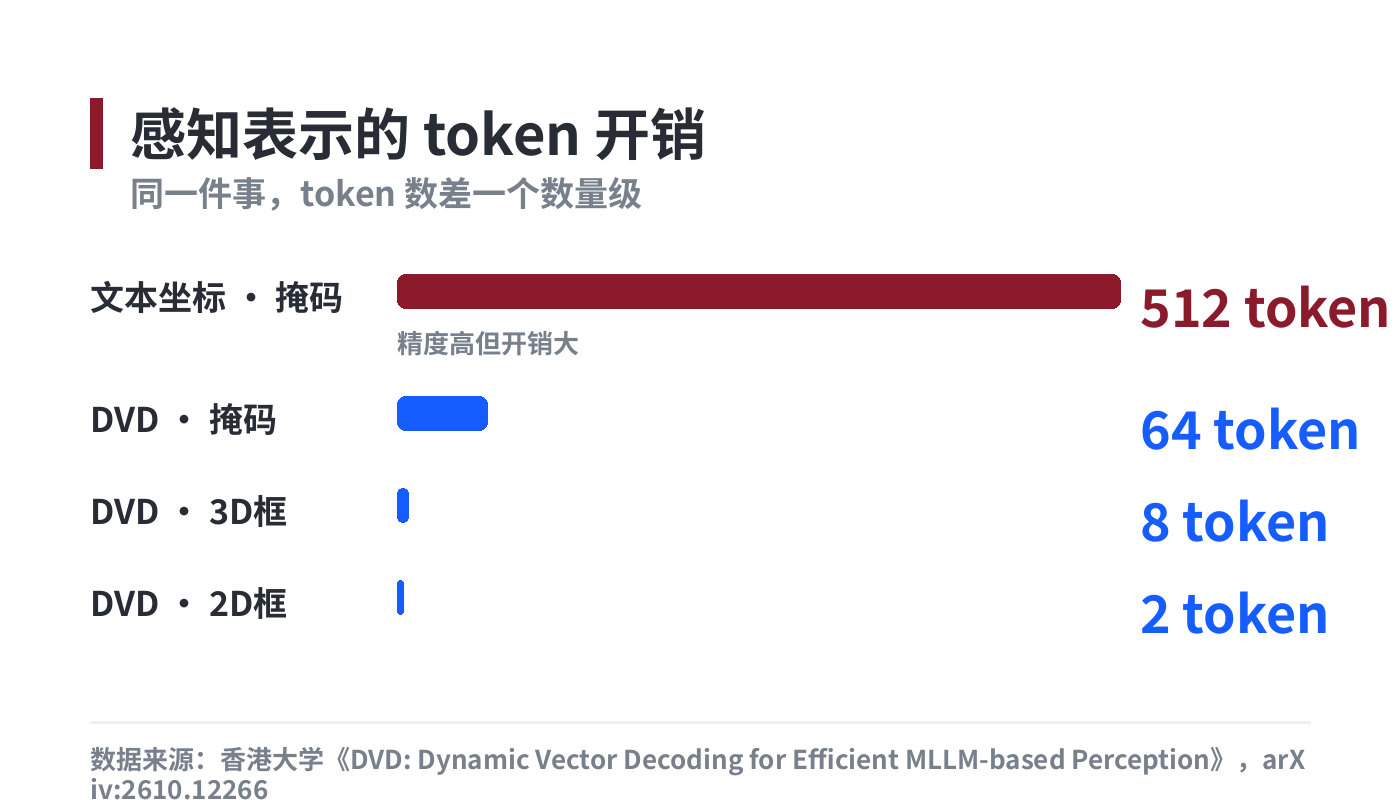
图注:相比文本坐标表示,DVD 把 2D 框压到 2 个 token、3D 框压到 8 个、掩码压到 64 个(来源:香港大学《面向高效感知的动态向量解码》,arXiv:2610.12266)
编码之前,先砍掉冗余
另一篇中山大学等团队的工作从更前面下手。PACE 指出,主流视觉 token 剪枝都发生在视觉编码器之后——只截了 LLM 的上下文,编码器算 4K 像素的开销一分没省;拆开开销看,高分辨率下视觉编码和 LLM 预填充是两个并行的瓶颈(来源:中山大学等《统一压缩-提取范式加速VLM推理》,arXiv:2608.27206)。
PACE 的解法分两段:编码前用自适应像素压缩器评估视觉信息密度、下采样冗余输入;编码后用动态双注意力提取器,融合编码器的视觉信号和 LLM 的语义信号,挑出真正关键的视觉 token。在 Qwen2.5-VL-7B 上,只用 10% 的视觉 token 就保住了 93.8% 的原始性能,首 token 时延(TTFT)加速 3.1 倍(来源:中山大学等《统一压缩-提取范式加速VLM推理》,arXiv:2608.27206)。
它还有个对企业很实际的属性:免训练、即插即用,不需要改模型架构,也不需要在自有数据上重新训练。对已经上线多模态应用的团队来说,这意味着压 token 和换模型解耦——不必为了省成本先重训一版(来源:中山大学等《统一压缩-提取范式加速VLM推理》,arXiv:2608.27206)。
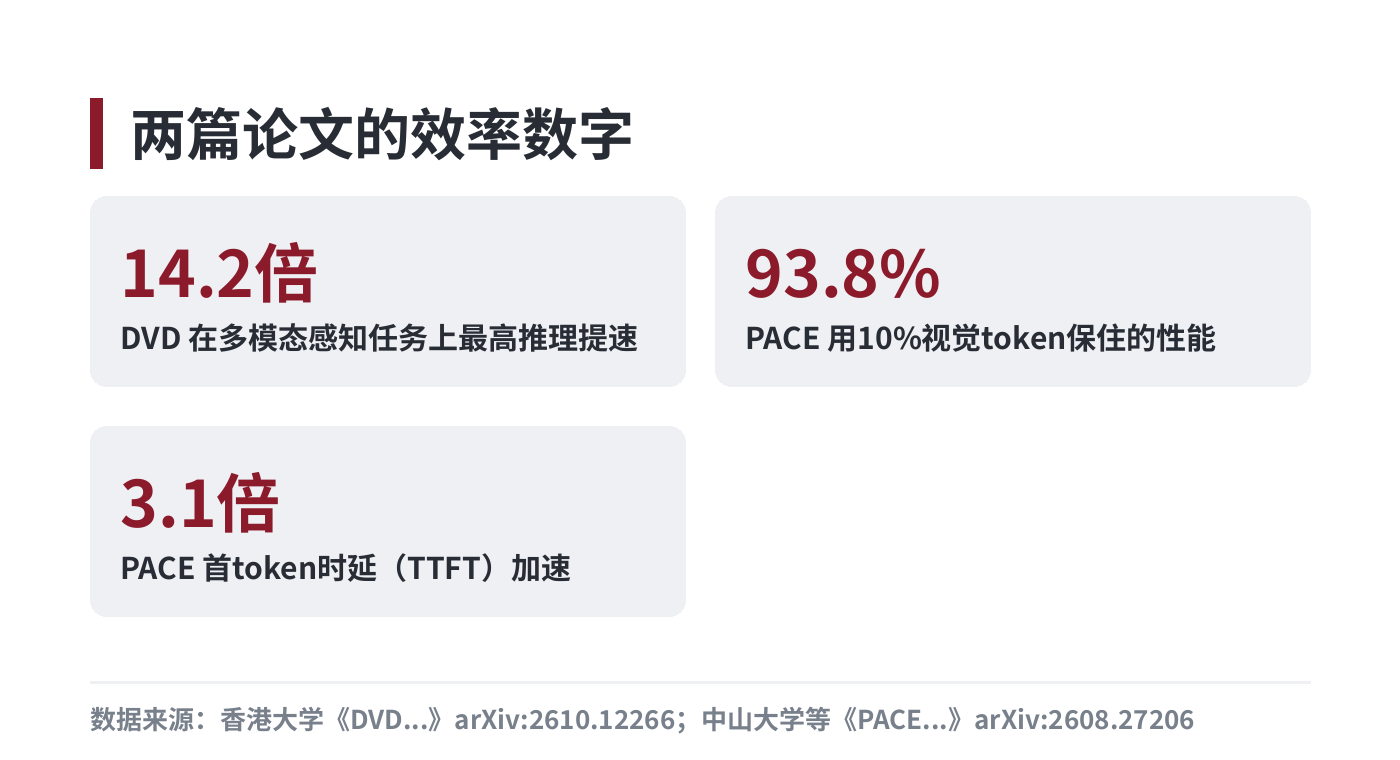
图注:PACE 在 Qwen2.5-VL-7B 上以 10% 视觉 token 保住 93.8% 性能,首 token 时延加速 3.1 倍(来源:中山大学等《统一压缩-提取范式加速VLM推理》,arXiv:2608.27206)
省token,更要保细节
两篇论文都盯住同一个陷阱:砍得太狠,细节就丢。PACE 发现,DivPrune、VisionZip 这类方法在通用基准上还算稳,但一遇到 ChartQA、DocVQA 这种"看细节"的任务,性能会明显下滑(来源:中山大学等《统一压缩-提取范式加速VLM推理》,arXiv:2608.27206)。
论文的解释是:激进的剪枝会把视觉版式切碎,丢掉文字的笔画和对齐锚点,而这些恰恰是高密度视觉推理离不开的线索。所以真正的目标不是"token 越少越好",而是在预算内同时保住整体版式和关键细节(来源:中山大学等《统一压缩-提取范式加速VLM推理》,arXiv:2608.27206)。
论文对比的基准正好分成两类:通用理解(RealWorldQA、POPE、MME、MMBench、MMStar)和细节敏感任务(ChartQA、OCRBench、TextVQA、DocVQA)。分化就出在第二类上——"平均分不掉"和"关键场景不掉"是两回事,选型时得先看清自己的任务落在哪一类(来源:中山大学等《统一压缩-提取范式加速VLM推理》,arXiv:2608.27206)。
源势AI观点
第一,视觉 token 是下一轮成本战的正面战场。文本侧的 token 优化已经很成熟,图像和视频进来之后,单次请求的 token 量级跳了一个数量级。谁先把视觉 token 压下去还不掉准确率,谁就拿到成本优势。
第二,两篇论文指向同一个工程原则:优化要往前放。等 token 都生成完了再剪,只省了一半;在编码前就砍掉冗余像素,才把编码器的开销也一起省了。企业做多模态方案时别只盯着模型层,输入端同样有账可算。
第三,精度和 token 数不是线性关系,是有拐点的。选压缩策略前先确认任务类型:做文档问答和图表理解,就别用为通用场景调出来的激进剪枝。
多模态的能力上限,取决于模型能看多细;但它的商业上限,取决于一个框到底要花几个 token。
话题标签:#多模态 #视觉token #推理优化
