换掉大模型的底层架构,过去意味着推倒重来:重新预训练一遍,账单按千万美元计。
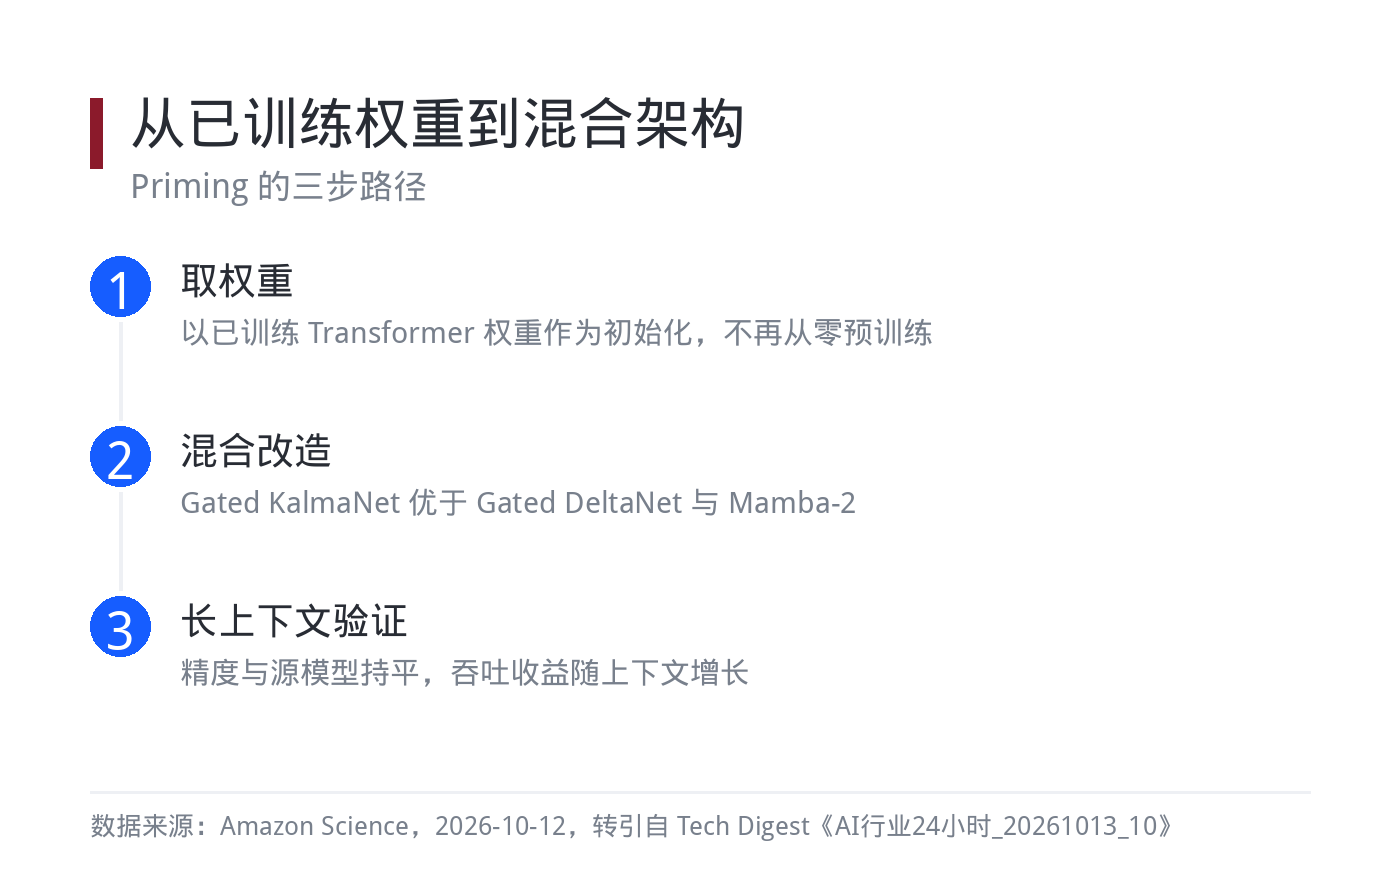
AWS 给出了一条不那么贵的路。10 月 12 日,AWS 团队公开论文《Priming》,把已训练好的 Transformer 权重当作起点,改造成"注意力 + 状态空间模型"的混合架构(来源:Amazon Science,2026-10-12,转引自 Tech Digest《AI行业24小时_20261013_10》)。
一句话:不是从零种一棵新树,而是给长成的树嫁接新枝。
先种,再长
Priming 的核心动作,是把"架构试验"和"预训练"这两件事拆开。
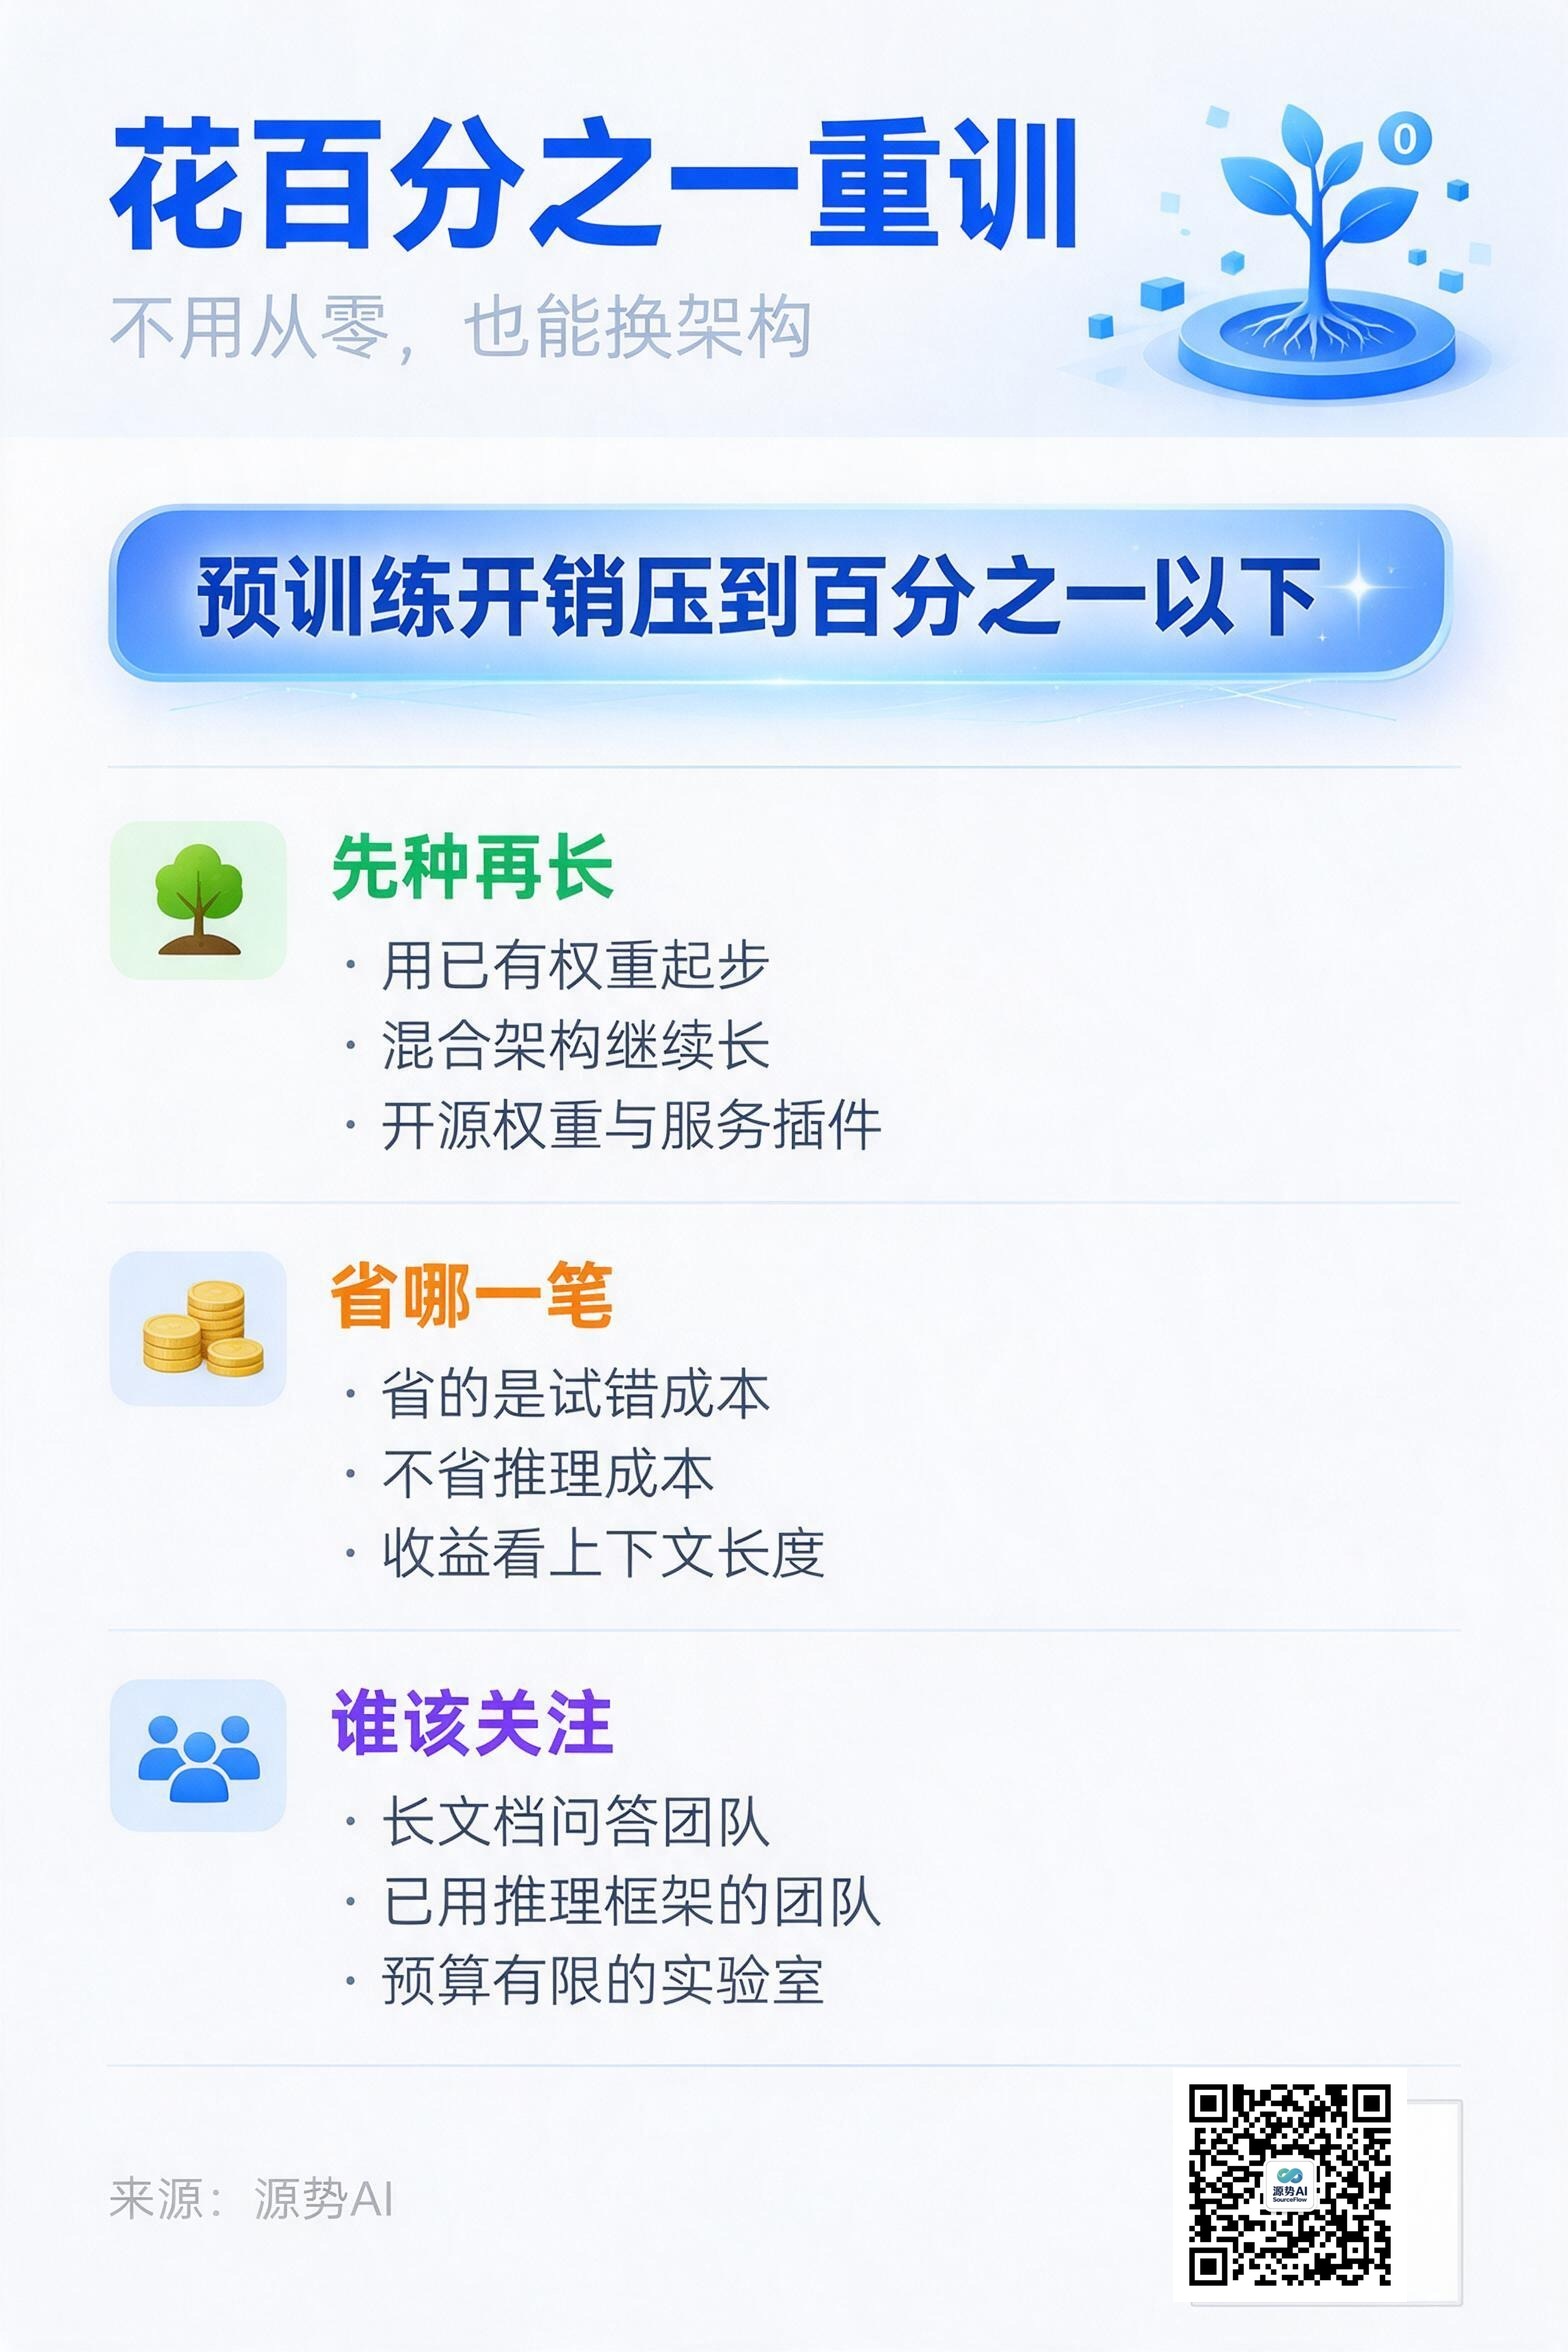
传统做法里,每试一种新架构,都要重新做一遍完整预训练,成本高到只能赌方向。Priming 改用已有的 Transformer 权重作为初始化,再让混合架构继续长大:论文称新架构的预训练开销降到原模型的 1% 以下,整条流程消耗不到源模型预训练 token 预算的 0.5%,跨 Qwen、Llama、Mistral 等模型族、8B 到 32B 规模都能用(来源:Amazon Science,2026-10-12,转引自 Tech Digest《AI行业24小时_20261013_10》)。
为什么值得折腾架构?因为注意力机制的计算随上下文长度平方增长,状态空间模型是线性的。上下文越长,两者的成本差拉得越大——这一项正好是长上下文推理账单里最贵的部分。
省钱之外,它把架构创新从"一次性豪赌"变成了可反复试的工程动作。团队按 Apache 2.0 开源了 8B/32B 两档已 priming 的模型、训练代码与 vLLM 服务插件,意味着这条路线不只在论文里成立,也能直接塞进现有推理栈跑起来。
可复现比数字本身更有说服力。权重、代码、服务插件都给了,其他人就能在自有数据上验证这套开销结论成不成立,也能证伪。
也要看清省的是哪一笔
省下来的主要是"试错成本",不是"推理成本"。
在受控对比里,Gated KalmaNet(GKA)优于 Gated DeltaNet 与 Mamba-2;32B 的 GKA 混合模型在推理基准上与源 Transformer 持平,128K 上下文解码吞吐最高约为其 2 倍,KV 缓存减半(来源:Amazon Science,2026-10-12,转引自 Tech Digest《AI行业24小时_20261013_10》)。但吞吐的收益依赖上下文长度——上下文越短,收益越明显缩水,并非所有场景通用。
还有一个容易忽略的取舍:GKA 的求解迭代数可以在推理时下调换吞吐,这是精度与速度的显式交换,不是免费提速。论文的评测基准也由 AWS 自设,尚未经同行评审。
把它放进采购视角,Priming 的价值是把"换架构"从战略决策降级成一次工程试验:先在 8B 规模验证精度与吞吐,再决定要不要往生产推。失败的成本从一轮预训练,变成一次微调。
换句话说,Priming 让架构选型变便宜了,但没有让推理变便宜。真正决定推理账单的,还是上下文长度分布与缓存命中率这两件事。
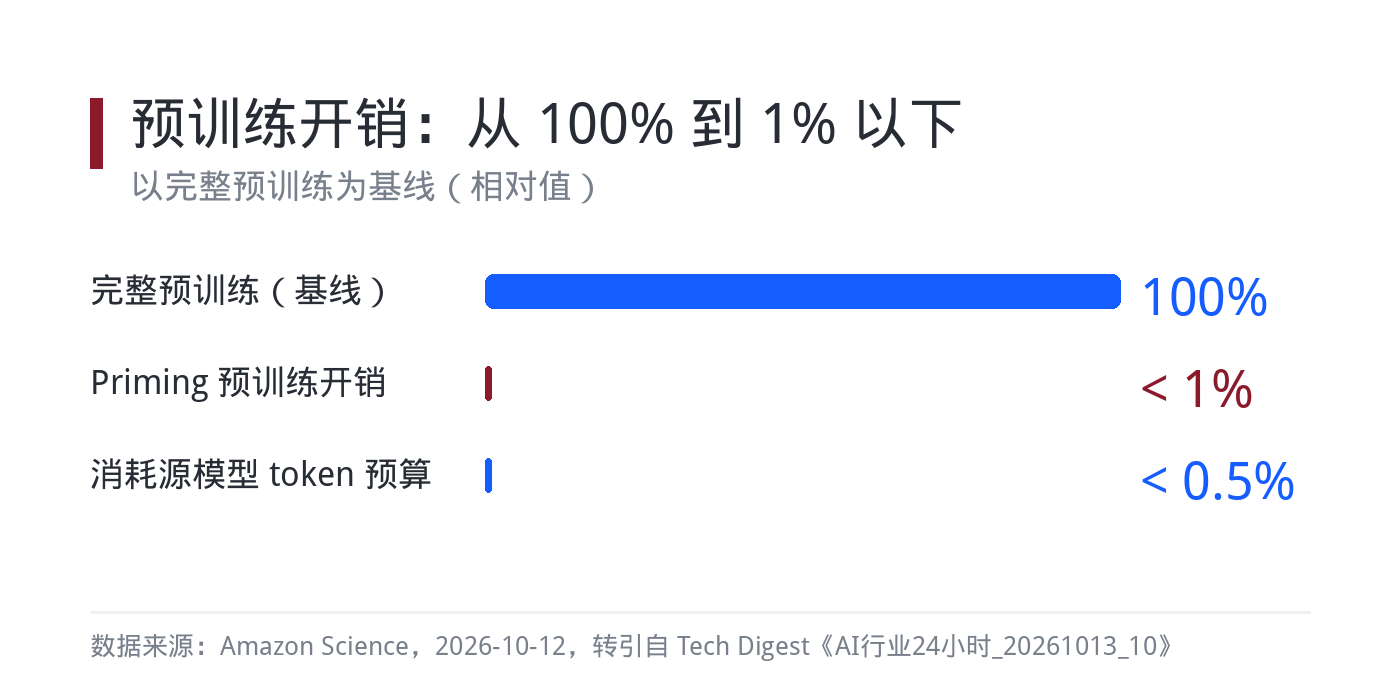
图注:以完整预训练为 100% 基线,Priming 的预训练开销降到 1% 以下,消耗源模型 token 预算不到 0.5%(数据来源:Amazon Science,2026-10-12)
混合架构,本来就在路上
把注意力层和状态空间层交错塞进同一个网络,是这两年架构演进的主流方向。
混合化的动机很直接:全注意力在大上下文下太贵,纯线性模型又在需要精确回忆的位置掉分。把两种层按比例交错,是想同时拿到效率与记忆——代价是网络行为更难预测,需要更细的验证。
一份模型记忆机制综述把 Priming 归为"从 Transformer 向 SSM 混合架构迁移知识的方法论",与 Samba 的交错层设计、LightTransfer 的层替换放在同一类(来源:笔记《大模型记忆机制全景综述》,2026-09-02)。
国内模型也在走这条路。有研究覆盖五种线性注意力架构、六种混合配置、12 个公开检查点做系统验证,参数量从 1.2B 一直拉到 397B,结论是少数 Full Attention 层在整条网络留下的痕迹,比它自己的参数量重要得多;Qwen 3.5、Kimi Linear、Nemotron-H 都在这条路线上(来源:公众号源势AI《2026-09-05_模型的稀疏账·藏在注意力层里》)。
谁最该关注这条路线?做长文档处理与代码库问答的团队,上下文动辄十万 token,混合架构的吞吐收益最明显;自研推理栈、已经把 vLLM 用起来的团队,官方插件让迁移成本接近零;预算有限又想试新架构的实验室,预训练开销被压到极低,试错重新可行。
Priming 的价值,是给这条路线补上了"怎么低成本迁移"的最后一环。
图注:32B GKA 混合模型精度与源 Transformer 持平,128K 上下文解码吞吐最高 2 倍、KV 缓存减半,16K 时吞吐约 1.5 倍(数据来源:Amazon Science;笔记《大模型记忆机制全景综述》)
源势AI观点
第一,架构试错的成本曲线被压低了。对企业来说,"要不要为长上下文换架构"不再是预算问题,而是工程排期问题。
第二,混合架构省的是显存和吞吐,不是精度。我们做推理服务时看到,长上下文场景才是混合模型的甜点区——短上下文调用上,收益会明显缩水,选型要按实际请求长度分布来算。判断标准也简单:同样上下文长度下延迟降了多少、答案质量掉了多少,这两项不达标就不换。
第三,这类开源权重值得先做小规模验证。8B 档可以在自有数据上快速跑一遍,确认精度不掉队再考虑上生产;验证周期按周算,不按季度算。
话题标签:#混合架构 #预训练 #状态空间模型
