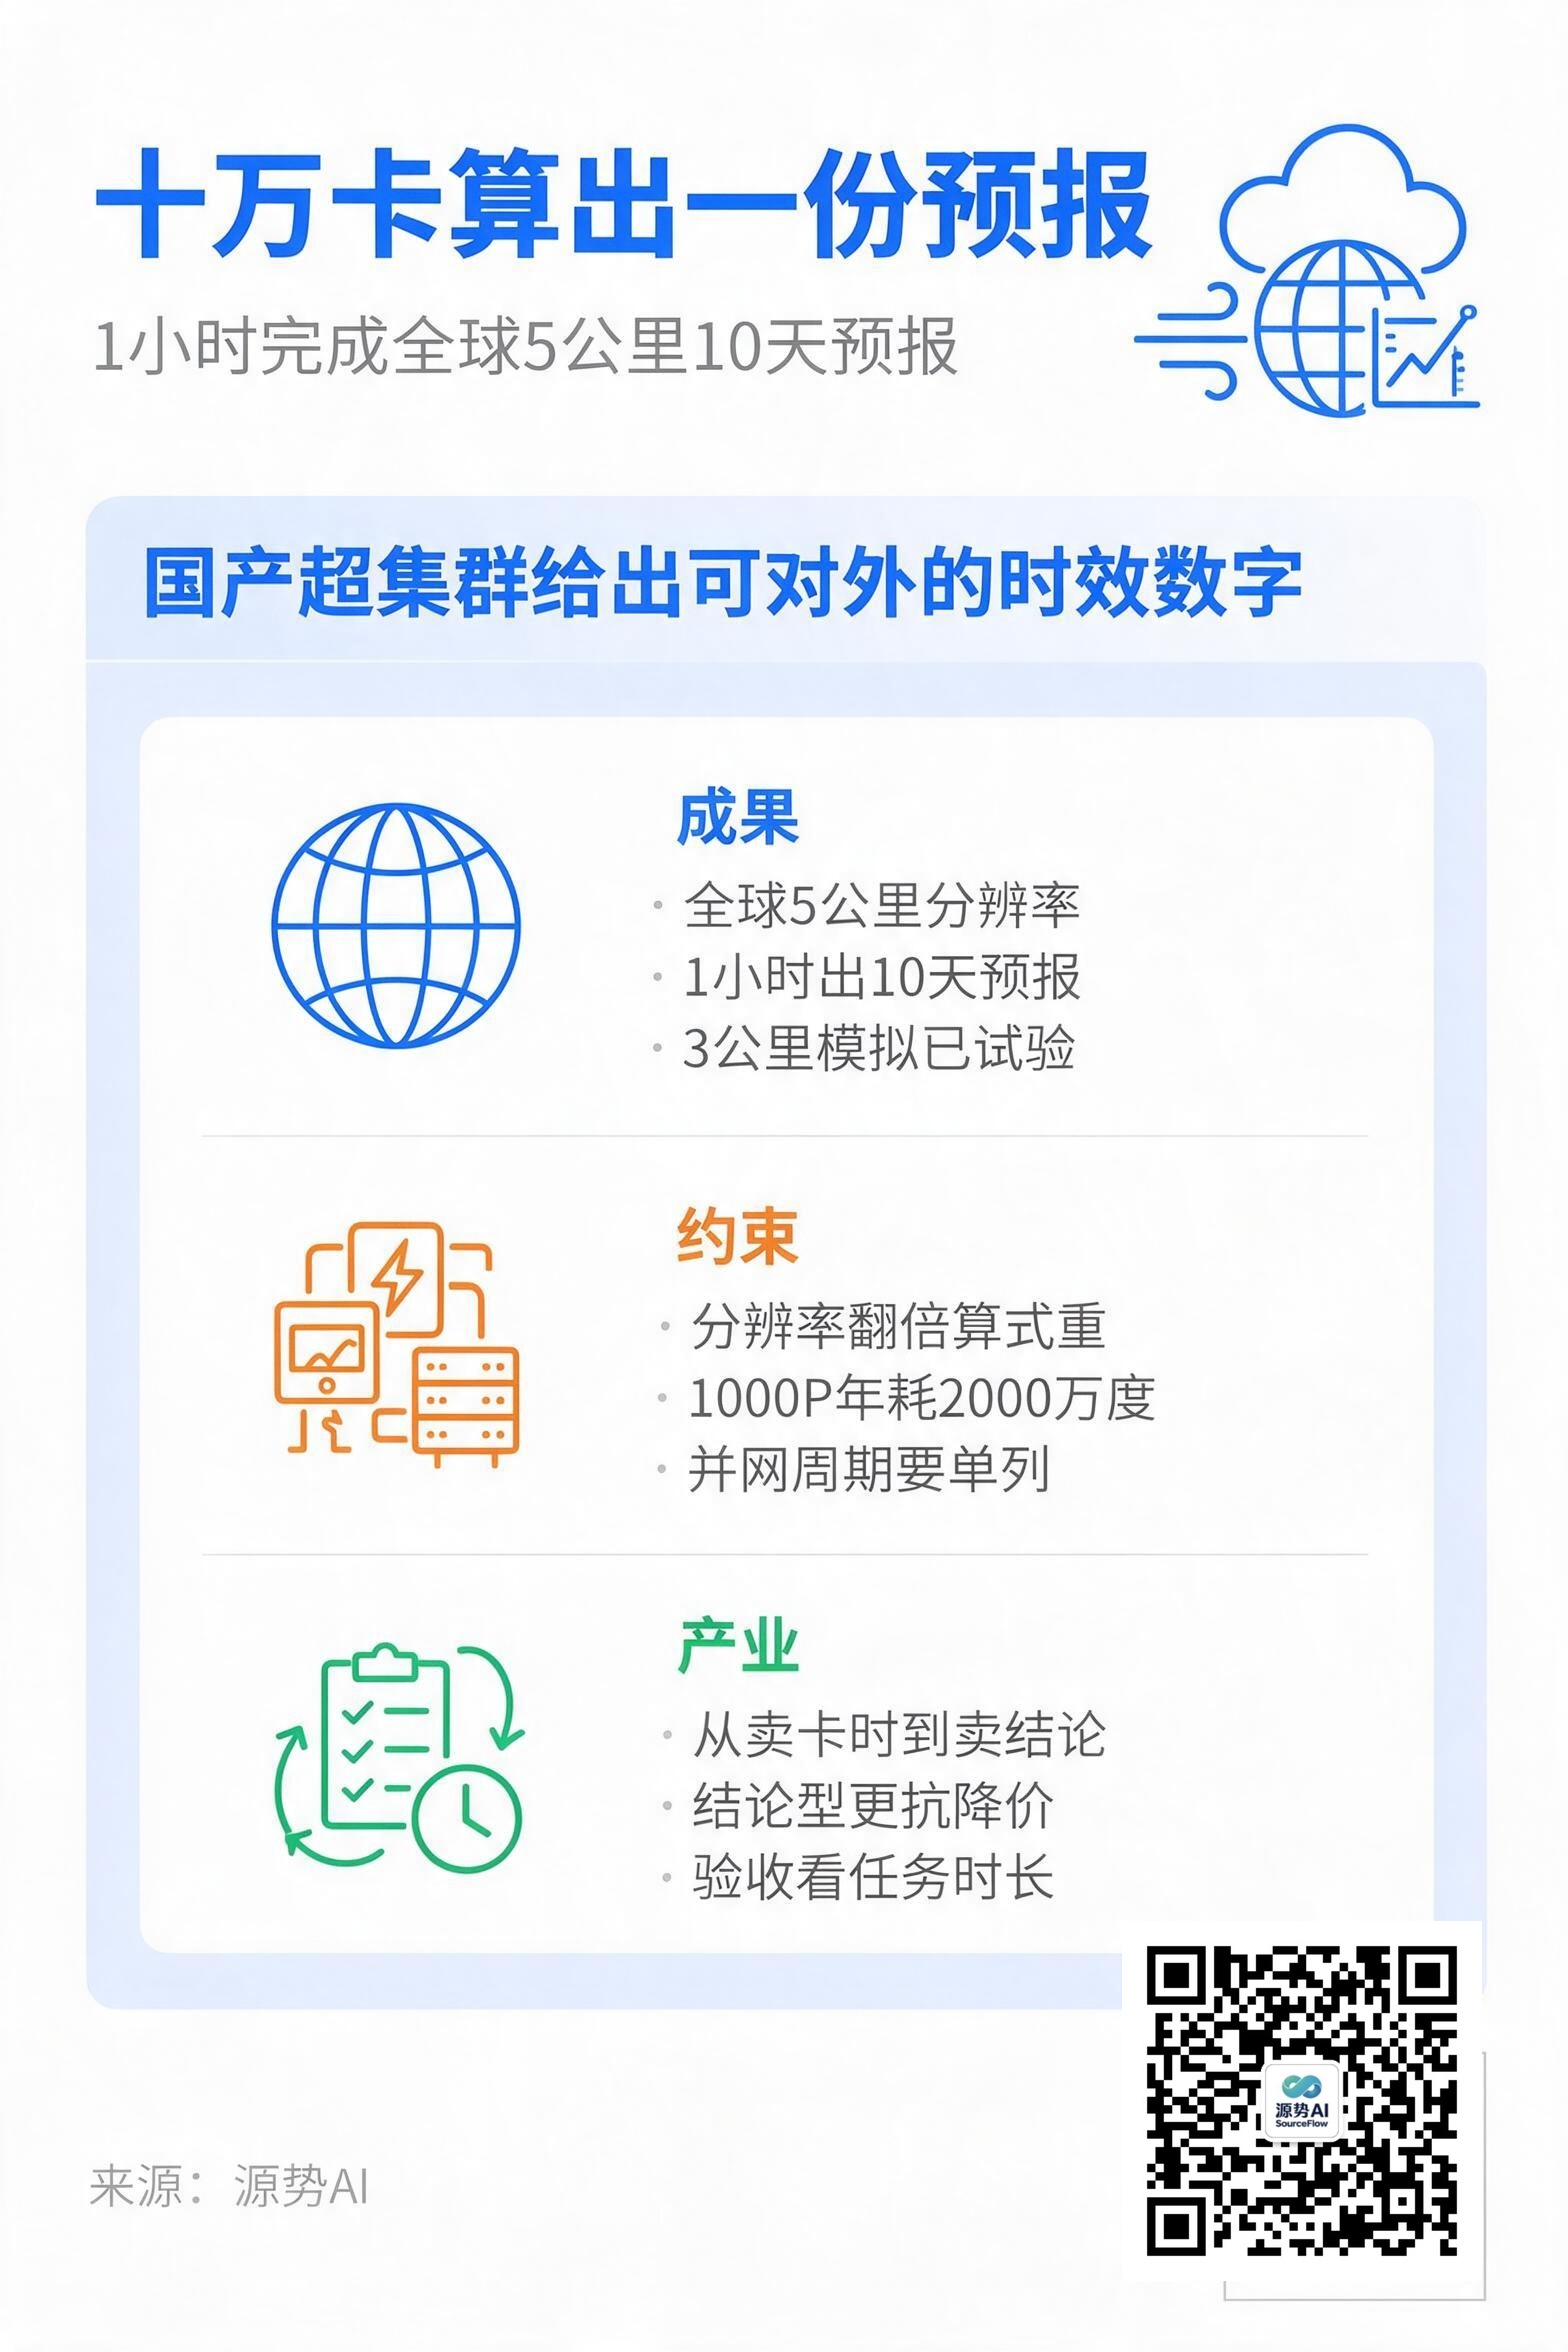
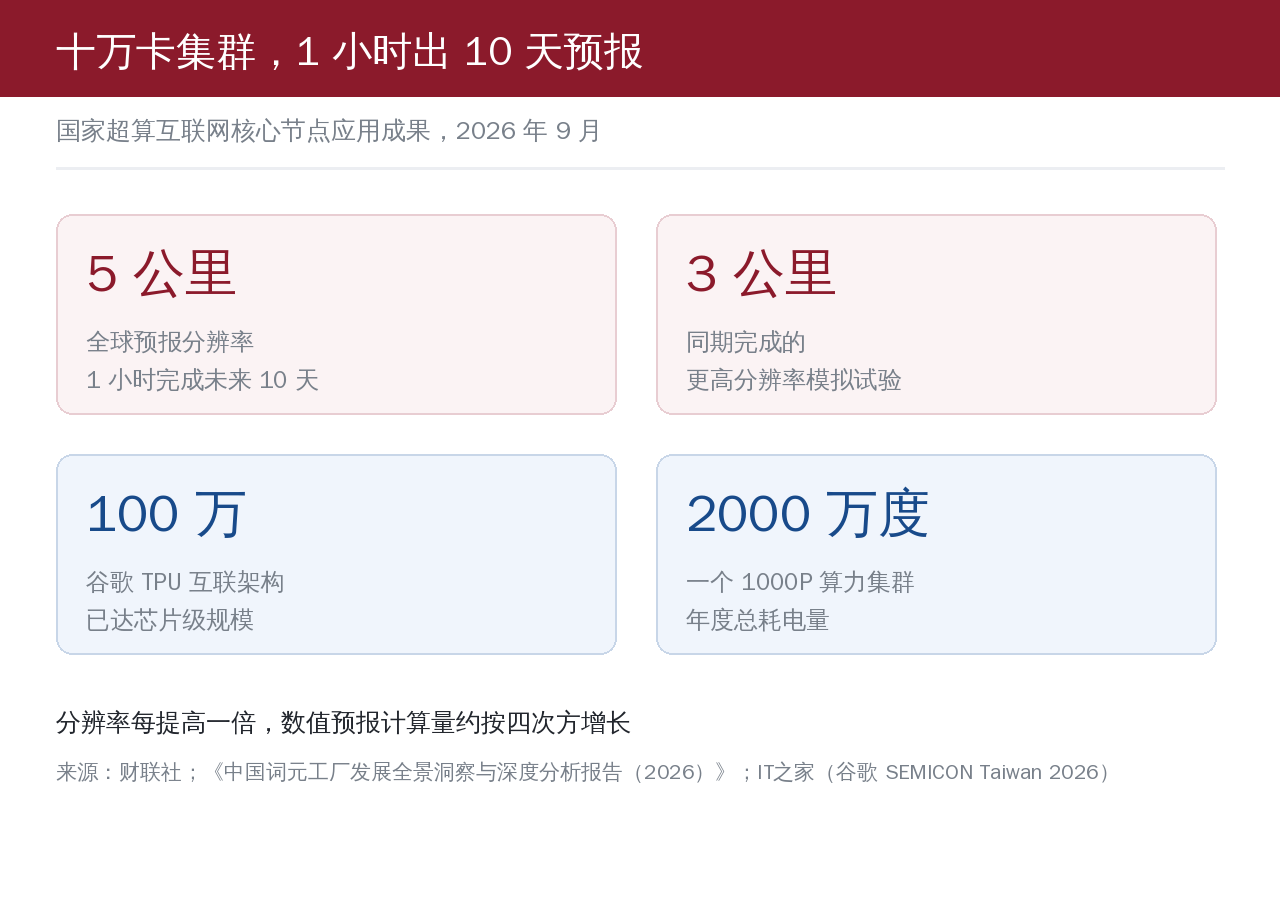
国家超算互联网核心节点发布了一批应用成果。其中一条的数字很硬:我国自主研发的新一代数值模式,依托国产十万卡 AI 超集群,1 小时完成全球 5 公里分辨率、未来 10 天预报的全部计算,达到国际主流时效标准。科研团队同期还完成了全球 3 公里分辨率的模拟试验(来源:财联社)。
天气预报本身不是这条消息的重点。重点是这条链路第一次给出了可对外引用的时效数字——国产十万卡级集群加科学计算,从"能跑"变成了"跑得可以对外说"。
图注:算力换来的不是更快的机器,是一个能按时交出去的预报结论
数字的价值在可比较
数值天气预报是典型的算力吞噬型任务。按这一领域通用的估算口径,分辨率每提高一倍,计算量约按四次方增长:5 公里和 3 公里看着只差 2 公里,计算量的差距接近一个数量级。
所以"1 小时出 10 天"这句话的真正含义是,国产集群在这类持续满载、通信密集、容错要求高的负载上,给出了一个可以被对标的时效指标。气象、海洋、环境这几类需要高频大算力的领域,一直缺的就是这种实测参照——之前能查到的标杆数据基本来自海外集群。
图注:前两个是成果,后两个是这类负载背后的规模与能耗约束
科学计算和训练不是同一种负载
把这条成果放到算力经营的角度看,另一层意义才浮出来。
训练任务的特征是阶段性强、可断点续跑、对通信拓扑极敏感;数值模式的特征是长期持续、时间步严格串行、容错窗口窄。这两类负载对集群的要求差别很大。
《中国词元工厂发展全景洞察与深度分析报告(2026)》里有一个容易被忽略的成本数(来源:该报告):一个 1000P 标准算力集群,年度总耗电量约 2000 万度。报告同时提到,政策层面在推进"算力并网池化及互联",以及全国一体化算力监测调度服务平台的建设——换句话说,算力正在被当成电力系统的一部分来调度。
科学计算负载在这一点上反而比训练更友好:它的用电曲线更平稳,可以签长周期的电力协议。这也是算力并网池化会被写进政策方向的现实原因(来源:该报告)。
互联先到位,瓶颈才会换位置
要让十万卡级集群跑出可对外引用的时效,光有卡不够,卡之间的连接才是决定项。
这方面最新的行业口径来自谷歌:其 TPU 互联架构已扩展至 100 万芯片级规模,可把最多 100 万颗 TPU 连成一个统一计算集群,支持跨数据中心、跨 Pod 的分布式训练。谷歌 CTO 同时把瓶颈指认得很直接——制约扩张的核心已经不再是芯片供给,而是电力(来源:IT之家)。
国内的同类实践可以看阿里云的灵骏真武 M890 超节点。《网络定义集群:阿里云灵骏真武 M890 超节点深度技术解析》里把架构逻辑说透了(来源:该技术解析):超节点本质上是把"网络定义集群"当作设计起点——先定义互联拓扑和带宽层级,再往上堆算力单元。这个顺序和过去"先把卡插满、再想办法连起来"的做法是反过来的。
两种口径指向同一个结论:集群规模上到万卡之后,瓶颈的迁移方向是固定的——从器件到互联,再从互联到电力。
从卖算力到卖结论
这条成果还有一层结构性变化,容易被数字盖过去。
过去的算力生意主要卖资源:卡时、Token、存储。数值预报这类任务卖的其实是结论——1 小时出 10 天全球预报,客户买的是这个时效,不是背后的卡时。
这对做 Token 生意的公司是个提醒。资源型定价的毛利会随着供给增加被压平,《中国词元工厂发展全景洞察与深度分析报告(2026)》里记录的推理成本下降曲线就是这个逻辑——有厂商的推理成本已经降到三年前的十分之一。而结论型交付的价格锚定在业务价值上,抗降价能力强得多。
源势AI怎么看
我们把这条消息读成国产算力的一次"交付验收",而不是一次性能发布。
过去两年,国产集群的消息大多停在规模上——多少卡、多少 P、多少 EFLOPS。规模是必要条件,但它证明不了任何事。可对外引用的时效数字不一样,它是一个把规模、互联、软件栈、运维能力全部打包后的结果。
对企业的实际意义是:如果你的业务里有那种"每天必须按时出结果、晚了就作废"的高频计算任务,现在有了一份国产方案的参照数据,可以拿去比价了。
我们自己在能源和工业客户那里的观察是,这类任务的采购逻辑正在变化——客户不再单独买算力,而是按"交付一个可用的结论"来签合同。今年我们接触的几个算力项目,甲方要求写的验收条款里已经出现了"单次任务完成时长"和"结果可复现"两项,而不是只写资源量。
算力生意的下一段,比的是谁能把结论按时交出来。
