图注:一图读懂本文要点——纯视觉路线靠上游监督拿到了可用的推理分数。
一个不看语言、只看图像的模型,把一道长期被视为"通用推理"的题做到了接近专门系统的水平。
何恺明团队的新论文提出 NAT-ARC,一条不依赖大语言模型的 ARC 解题路线(来源:量子位,转引自《AI行业24小时_20261002》;该论文为预印本,以下数字均为论文自报口径,尚未见独立复现)。做法不复杂:在已有视觉方案 VARC 前面插入一步 ImageNet MAE 预训练——直接取何恺明 2022 年提出的 MAE 公开 checkpoint 初始化视觉编码器,丢掉与 ImageNet 图片尺寸绑定的 patch embedding 与位置编码,改用 2D RoPE,再在 ARC 训练集上离线训练编解码器,测试时对每道题单独做 LoRA 微调(来源:量子位,转引自《AI行业24小时_20261002》)。
关键在最后一句:整个预训练阶段,没有用过一张 ARC 格子。
猫狗照片教的是"把物体分出来"
结果上,表现最好的单模型为 0.6B 参数,ARC-1 的 pass@2 达到 63.4%±0.7%;把无预训练、ImageNet MAE 预训练、ARC 风格格子 MAE 预训练三个模型池化投票后,约 2B 参数拿到 70.2%±0.6%(来源:量子位,转引自《AI行业24小时_20261002》,2026-10-02)。作为对照,专门针对 ARC 微调、使用 8B 语言模型的 The ARChitects 是 71.6%(来源:量子位,转引自《AI行业24小时_20261002》)。
论文给出的一项可视化验证更能说明迁移了什么:把一张猫片编码成 60×60、10 色的 ARC 式格子,让 NAT-ARC 执行旋转 180° 加蓝色边框,再解码回像素,图上确实完成了变换。研究人员认为,ImageNet 上学到的"把物体从背景里分出来"这类先验,迁移成了 ARC 里的区域分割与图案匹配(来源:量子位,转引自《AI行业24小时_20261002》)。
换句话说,模型在 ImageNet 上没学过任何一道 ARC 题,却学到了做 ARC 题需要的基础视觉操作。
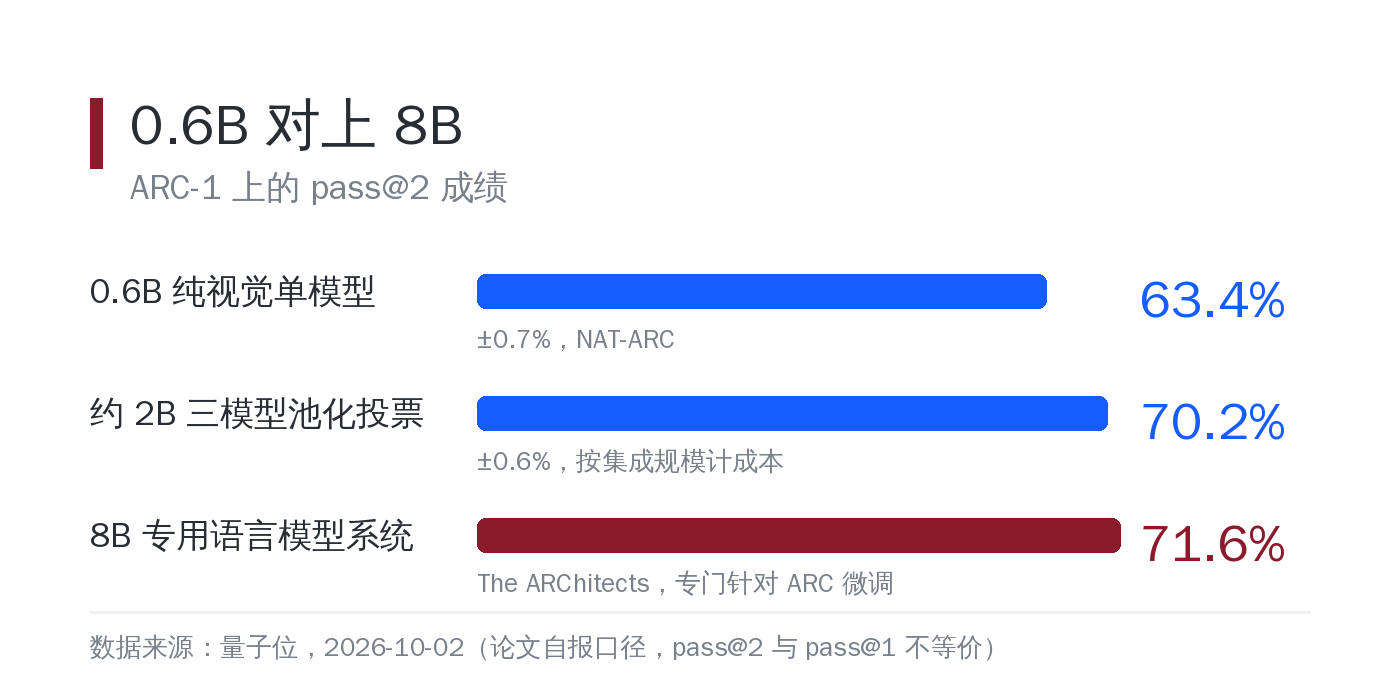
图注:三个数字的读法并不相同——63.4% 是单模型 pass@2,70.2% 来自三个模型池化投票的集成成绩,71.6% 出自使用 8B 语言模型、针对 ARC 专门微调的系统;把它们并排之前先确认是不是同一个口径(数据来源:量子位,转引自《AI行业24小时_20261002》,均为论文自报口径)
预训练真正改变的是缩放曲线
这项研究最有价值的发现,不是某个分数,而是预训练对 scaling 的影响。
论文报告:在无预训练的情况下,模型从 large 扩到 huge 这个相邻尺度时,成绩反而下降;加上 ImageNet 预训练后,论文测试的三个尺度才一路向上(来源:量子位,转引自《AI行业24小时_20261002》)。这解释了一个长期困扰纯视觉路线的现象——不是视觉方案不行,是缺了一层能从数据里稳定抽取结构的上游监督。补上这层监督,参数才愿意为能力买单。
这与另一条线上的判断互相印证。arXiv 上的《把视觉挡在语言模型之外》(2609.29601)把视觉从语言模型里彻底剥离,用确定性的语义序列化把感知状态编译成文本,再交给纯文本模型作答;在同一任务上,7B 的序列化接口(0.7892)超过了同为 7B 的零样本视觉语言模型(0.7462),3B 上差距更大(0.7673 对 0.6913)(来源:arXiv:2609.29601,南佛罗里达大学)。那篇论文的结论同样指向一个点:小模型的多模态瓶颈可能不在语言能力,而在"把视觉塞进语言模型"这个设计本身。
同一个方向还有 VIVAS 那条线:把视觉监督提前到预训练阶段,用视觉-语言统一自回归监督重塑细粒度感知(来源:arXiv:2609.27948)。三篇论文的路径不同,但都在回答同一个问题——视觉能力该在哪里被训练出来。
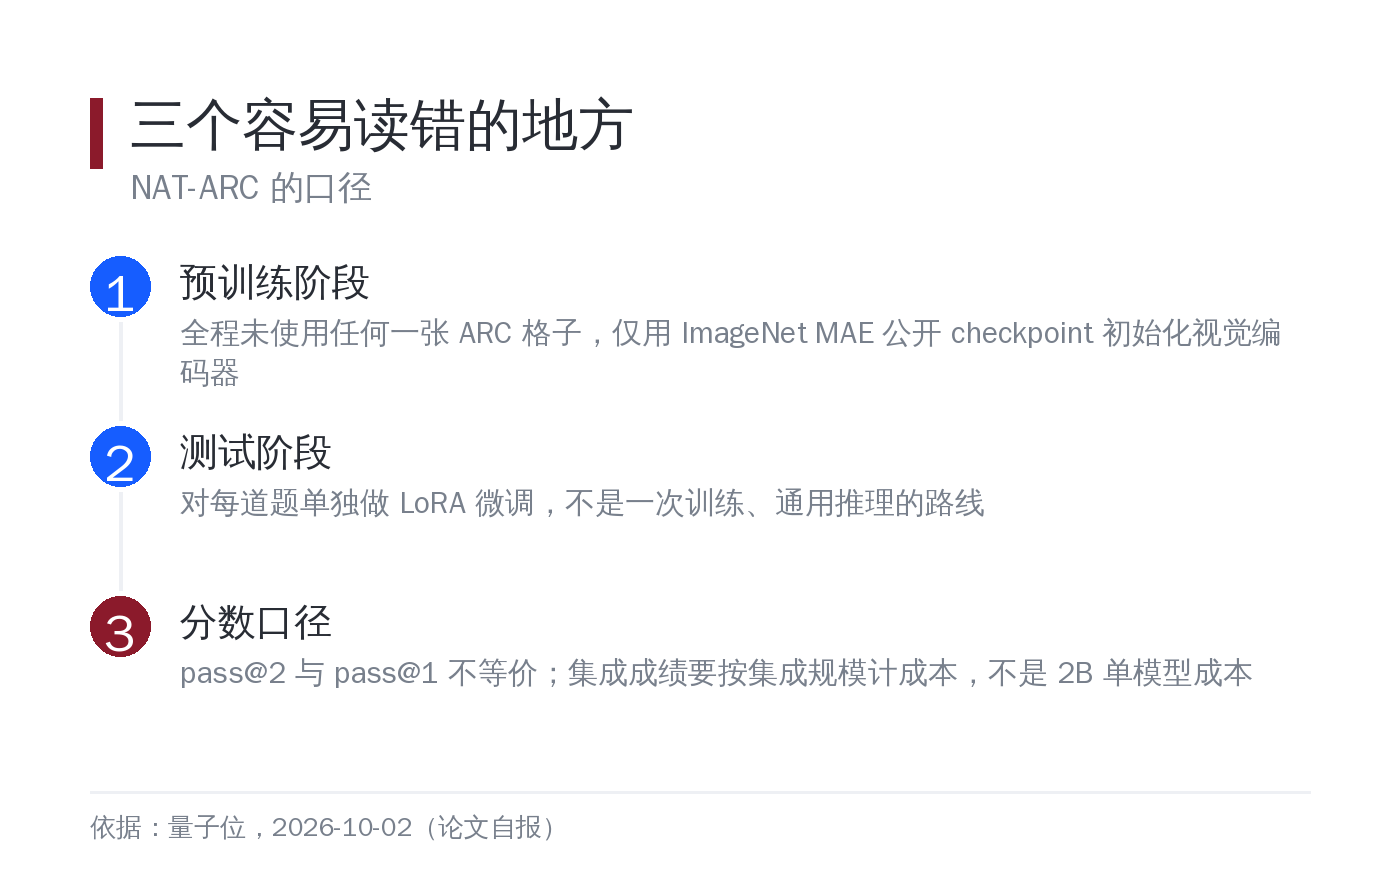
图注:三条路线分工不同——NAT-ARC 在编码器前面补上游预训练,语义序列化把感知编译成文本接口,VIVAS 把视觉监督提前到预训练阶段;共同点是都不靠堆语言模型的参数量(数据来源:量子位,转引自《AI行业24小时_20261002》;arXiv:2609.29601)
分数之外,口径要读准
这类论文的分数最容易读错,三个口径必须记住。
第一,pass@2 与 pass@1 不等价,不能与榜单的单条口径混用(来源:量子位,转引自《AI行业24小时_20261002》)。第二,70.2% 来自模型池化投票,参数量与推理成本都要按集成规模计,不能拿 2B 当单模型成本看(来源:量子位,转引自《AI行业24小时_20261002》)。第三,说"逼近专用 LLM 系统",指的是同一基准下分数接近,不覆盖训练与推理总成本——0.6B 的编码器加上逐题 LoRA 微调,账怎么算要和 8B 端到端系统比才公平(来源:量子位,转引自《AI行业24小时_20261002》,以上均为需要保留的报道口径)。
还有一个容易被省略的前提:测试时对每道题单独做 LoRA 微调。这意味着它不是"一次训练、通用推理"的路线,而是用少量样本快速适配单题的路线。它证明了视觉先验的有效,但离"一个模型解所有题"还差一段。逐题微调也把成本结构改了——每道新题都要付出一次微调的算力与时间,成本随题量线性增长,而论文没有给出单题微调的耗时与成本(来源:量子位,转引自《AI行业24小时_20261002》,该成本口径未在报道中披露)。做方案评估时,我们建议把这份"按题计费"的成本单独列出来,再和端到端系统的单位成本放在一起比。所以"逼近 8B 系统"只说分数接近,不等于整体更划算。
源势AI观点
第一,判断一条模型路线,先看它有没有稳定的上游监督。NAT-ARC 的贡献不是把分数推高,而是让纯视觉路线重新有了 scaling 的斜率——没有上游监督的架构,参数再多也换不来能力,这一点在多模态选型时同样适用。
第二,别被参数量对比带偏。小参数视觉模型对大参数语言系统的对比很抓眼球,但两边是不同口径的成绩:一边是逐题微调的视觉模型,一边是端到端系统。做技术评估时,我们习惯把"训练成本、推理成本、适配成本"三项分开列,再谈分数。
第三,跨领域先验是可以迁移的资产。ImageNet 的"分物体"能力迁移到 ARC 的"分区域",说明通用视觉预训练的价值被低估了。对做垂类视觉的团队,先用大规模通用数据把编码器喂好,再用少量垂类数据适配,往往比直接在小数据上端到端训练更划算。
一个不看语言的模型把这道题做到了六成多,重要的不是这个数字本身,而是它说明:通用推理未必只有语言模型一条路。
参考材料
- 量子位《何恺明团队用猫狗照片预训练:纯视觉方案 0.6B 参数在 ARC-1 拿到 63.4%》,2026-10-02
- 《Free the Language Model From the Vision Encoder: Semantic Serialization as a Perception Interface for Small Language Models》,arXiv:2609.29601
- 《VIVAS:通过视觉-语言统一自回归监督强化VLM预训练视觉感知》,arXiv:2609.27948
话题标签:#视觉推理 #预训练 #模型缩放
