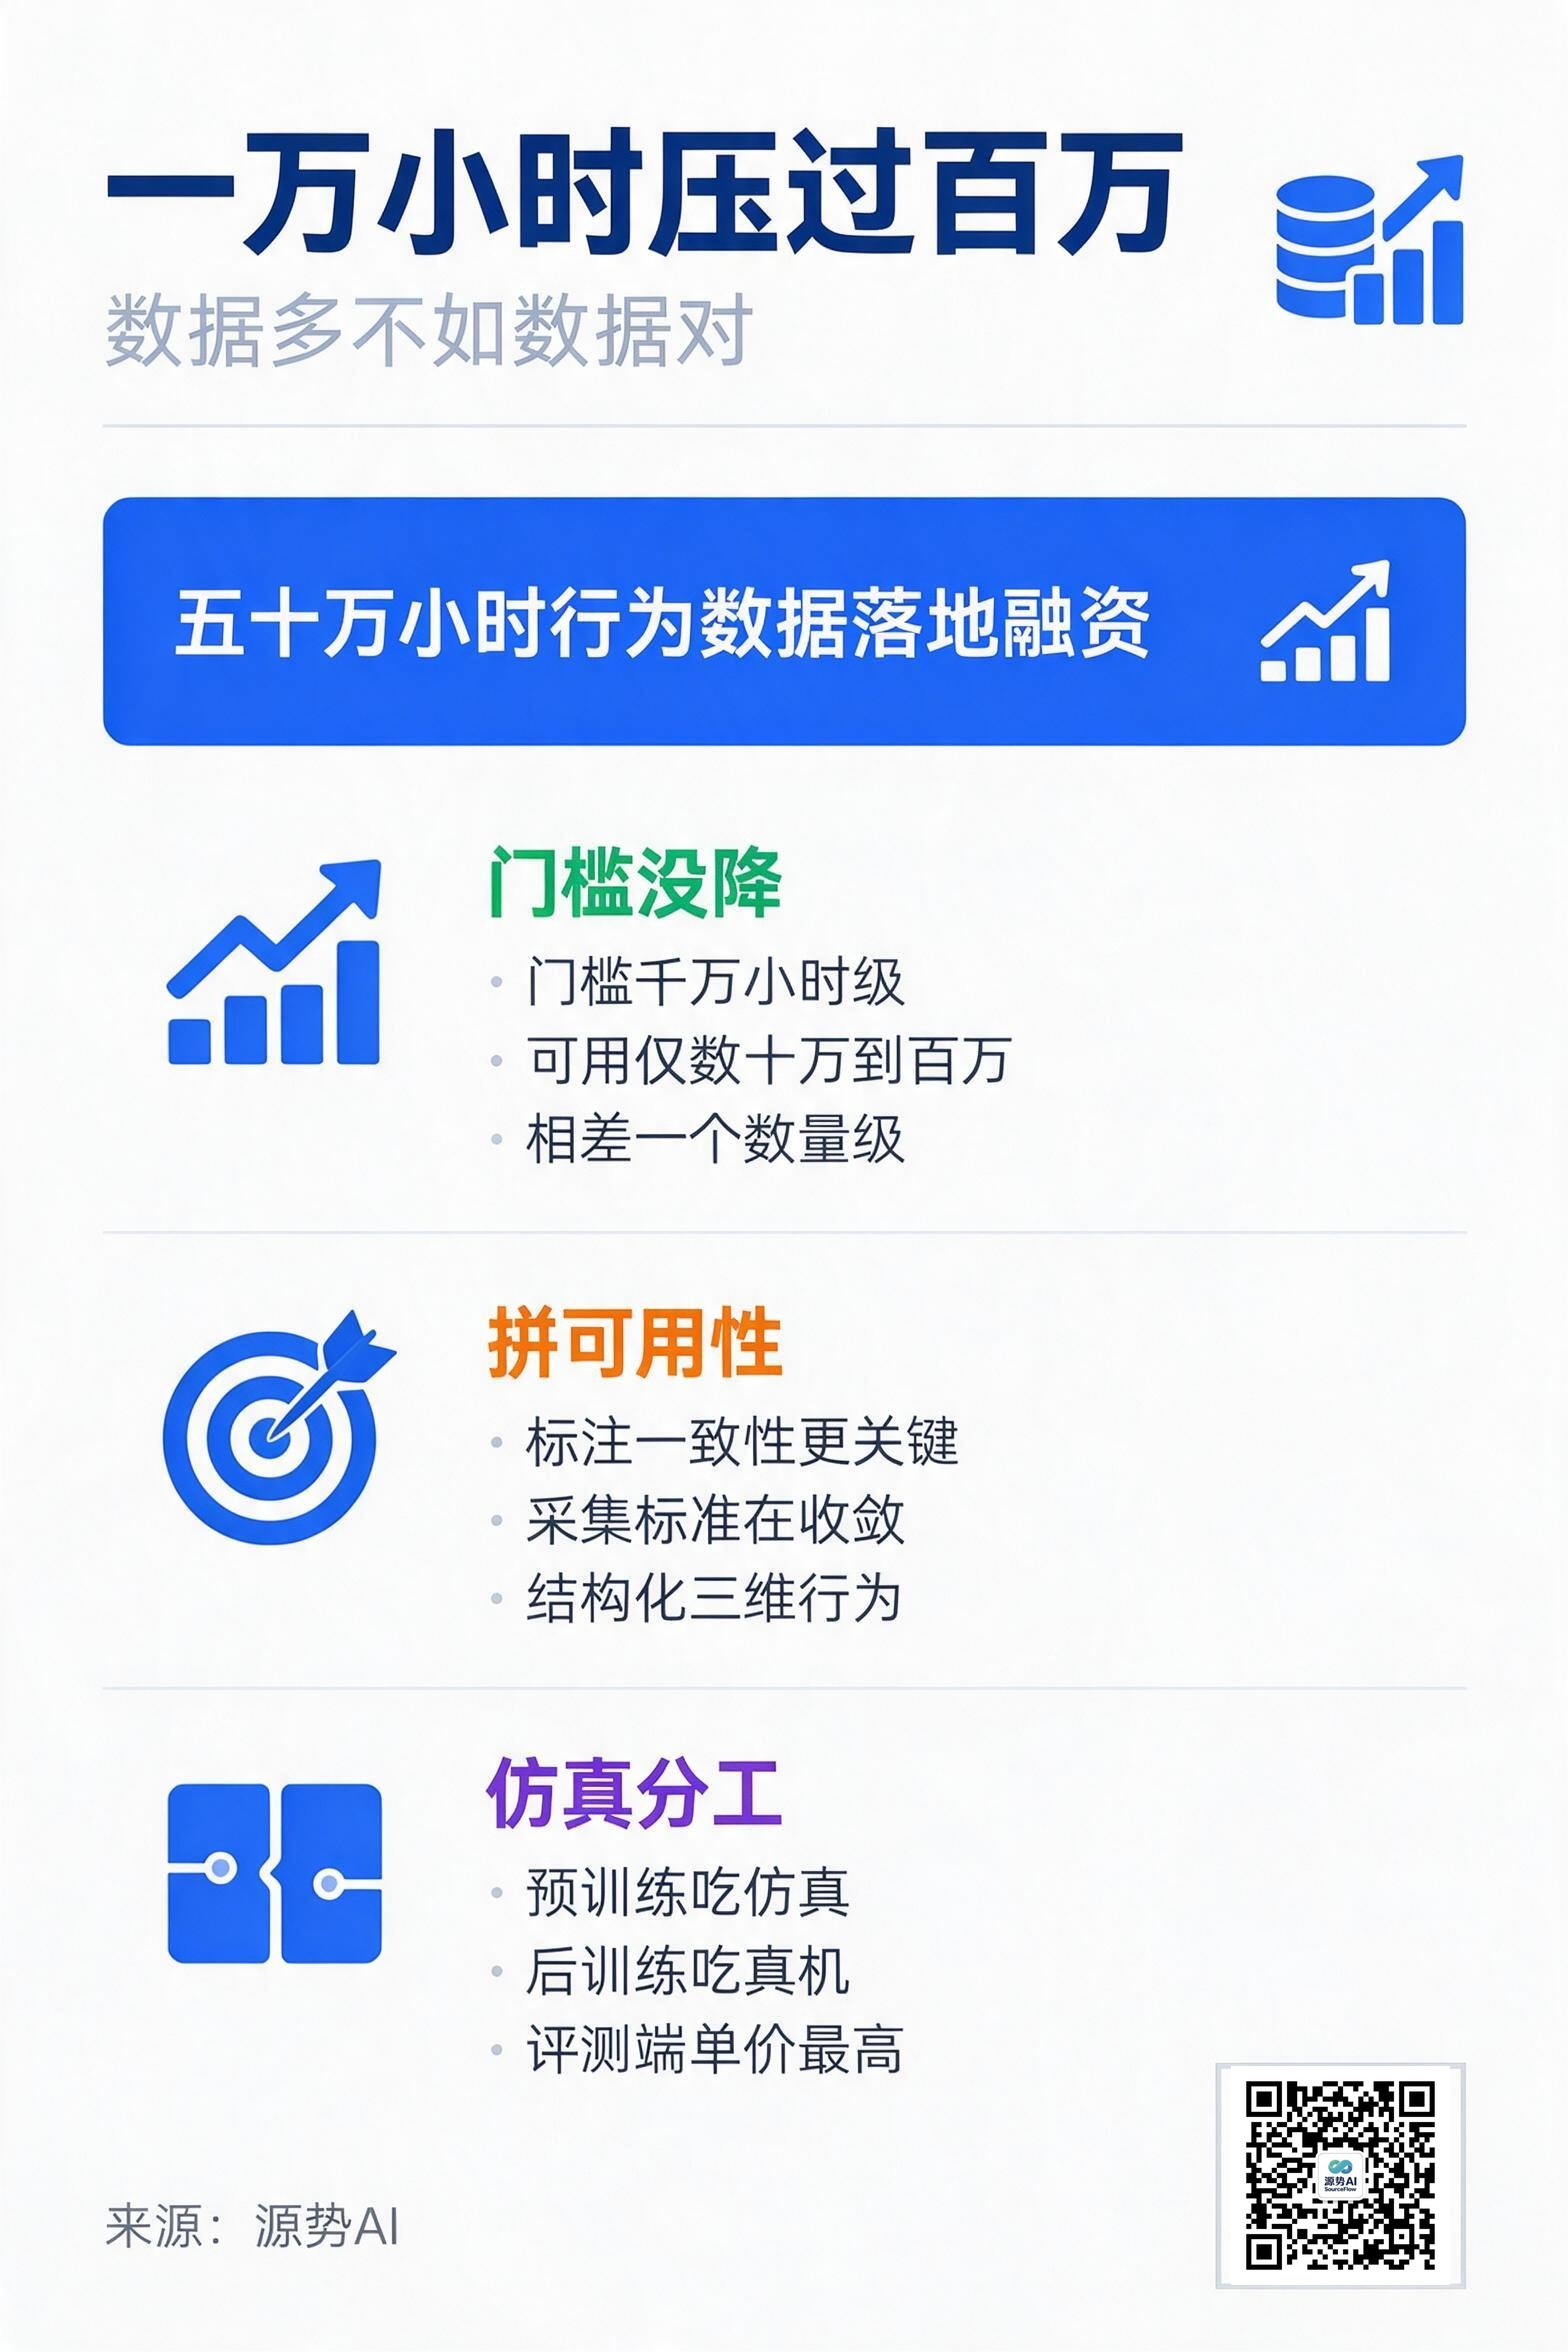
具身智能的数据账,正在被重新算一遍。
上海半图科技完成 Pre-A 轮超千万美元融资,联想创投领投、IDG 资本等跟投,资金用于人类行为模型研发、数据体系建设与 AI 原生 3D 互动场景落地;其累计 50 万小时级结构化行为数据,已接入国内头部具身智能企业的仿真训练体系(来源:科创板日报,2026-10-12,转引自 Tech Digest《AI行业24小时_20261013_10》)。
同一天,行业里另一句话更值得记:1 万小时的高质量数据,可能比 100 万小时的重复数据更重要(来源:科创板日报,2026-10-12,转引自 Tech Digest《AI行业24小时_20261013_10》)。
门槛没降,标准变了
这句判断出自北京人形机器人创新中心人士。据其统计,全球可用的高质量真实数据只有数十万至百万小时级,而机器人要到"ChatGPT 时刻"需要千万小时级(来源:同上)。
这句话的落点不在小时数,在"可用"两个字。一段随机晃动的机械臂视频,对模型没有增量;一段标注一致、覆盖边界条件的操作,才可能被反复用到。按这个口径,百万小时的重复采集,抵不上万小时的高密度样本。
缺口的量级早就被算过。中国信通院《具身智能训练场研究报告(2026 年)》测算,具身基础模型要达到类似"ChatGPT 时刻"的能力水平,至少需要千万小时级真实交互数据,而当前全球可用的高质量真实数据只有数十万到百万小时级,两者差一个数量级以上(来源:公众号源势AI《2026-09-04_机器人的ChatGPT时刻·卡在数据上》,引述中国信通院报告)。
供给端一直在补。截至 2026 年 6 月底,国内建成投用的具身智能训练场超过 70 家,另有 46 家在建或规划(来源:公众号源势AI《2026-09-04_机器人的ChatGPT时刻·卡在数据上》)。京东给出的采购目标是两年 1000 万小时(来源:界面新闻,2026-09)。
供给端的动作更具体。9 月初,智元机器人孵化的觅蜂科技宣布第 2 万套 MEgo 无本体采集设备下线,累计产出超 100 万小时无本体数据,现场交付京东物流(来源:界面新闻,2026-09)。这类设备把数据采集从机器人折旧加运维,压到设备折旧加人工,采集端在走向轻资产。
问题不在总量,在密度。
从拼小时数,到拼可用性
同样一小时数据,可用性可以差很多。
采集端的标准在收敛:60FPS、1080P、双目、深度信息、时间同步与空间标定精度,成了采购合同的常见门槛条款。但模型方拿到千万小时异构数据后会发现,真正难的是同一动作在不同光照、相机位姿与任务语境下的标注一致性——这比小时数更重要(来源:公众号源势AI《2026-09-04_机器人的ChatGPT时刻·卡在数据上》)。
训练侧也给出了同一方向的证据。智元 GE-Act 2.0 的四档数据 Scaling 实验里,3 万小时数据的零样本成功率从 17.1% 升到 44.1%,曲线仍未饱和——数据量确实与能力正相关,但前提是这些数据可用(来源:公众号源势AI《2026-09-10_三万小时·机器人没吃饱》)。
半图科技走的是另一条路:把动作、表情与交互关系转成结构化的 3D 行为表示,让前端采集与后端训练解耦;其自研 AI 互动产品《代号 Live》在 2026 年 9 月测试中次日留存 72%、5 日留存 57%、人均日互动近 200 条(来源:科创板日报,2026-10-12,转引自 Tech Digest《AI行业24小时_20261013_10》)。
留住用户的行为数据,本身就是训练素材。这类产品一边跑商业留存,一边沉淀人机交互的真实轨迹,数据与产品互为因果——这也是它区别于纯训练场的地方。
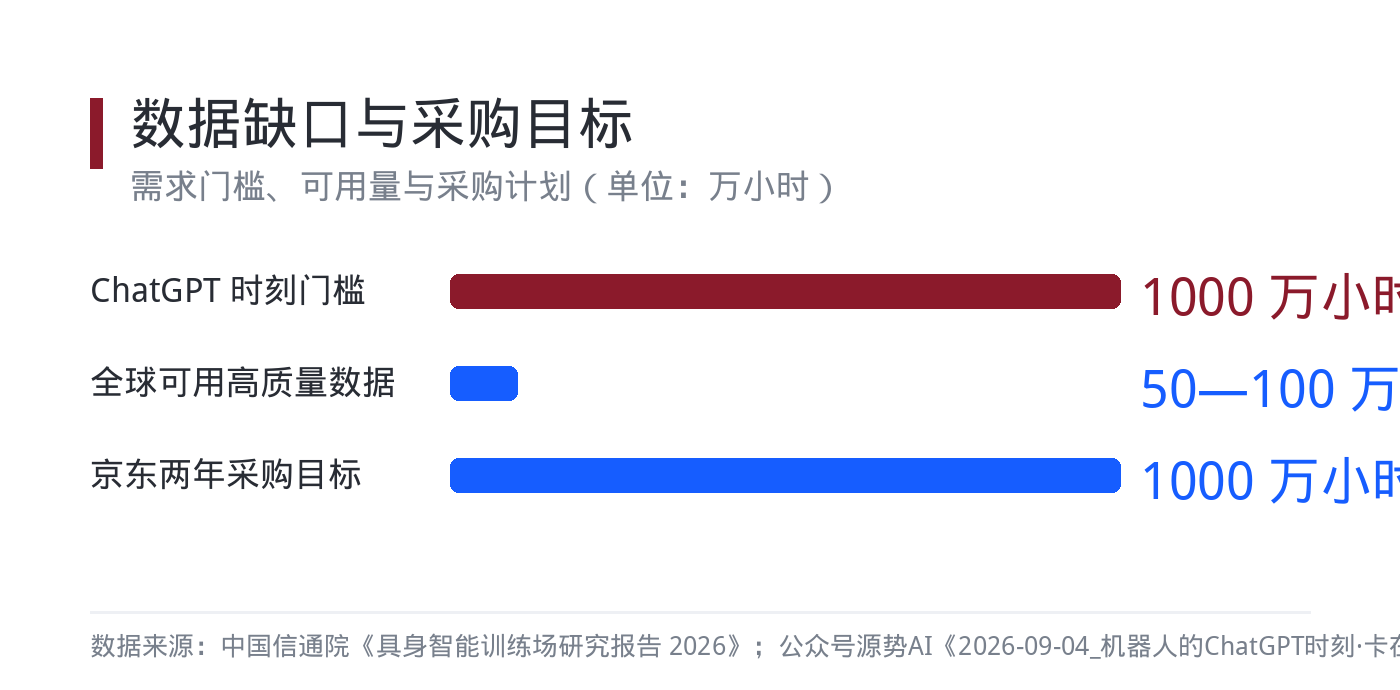
图注:需求门槛 1000 万小时,全球可用高质量数据只有 50—100 万小时,相差一个数量级以上;京东两年采购目标恰好等于门槛(数据来源:中国信通院;界面新闻,2026-09)
仿真在挤压真实数据的溢价
合成数据把预训练的成本打到接近零,真实数据的战场在收缩。
英伟达的 Isaac Sim 与 Cosmos 世界模型,把合成数据的成本压得很低;行业共识正在成形——预训练吃仿真和互联网视频,后训练与评测吃真机数据(来源:公众号源势AI《2026-09-04_机器人的ChatGPT时刻·卡在数据上》)。
市场空间撑得起这场竞争。沙利文测算,服务机器人主要细分市场 2026—2030 年复合增长率约 31%,餐饮与配送场景约 37%,中国占据近 40% 的份额(来源:《2025年全球具身智能与商用服务机器人独立市场研究报告》)。
结果就是真实数据的"最后一公里"单价反而更高:不是任何一小时都值钱,能被用于后训练与评测的那部分才值钱。半图科技把行为模型接进仿真体系,本质是既做数据、又做"数据怎么用"的中间层。
更实际的问题是配比。仿真数据近乎免费,真机数据按小时计价,两者混着训练时到底按什么比例最划算,目前没有公开的稳定结论——这也让"数据值不值钱"变成了一个需要自己跑实验的问题。
训练场、采集设备与模型厂三方之间,谁能掌握可用的评测标准,谁就掌握了数据的报价方式。

图注:预训练吃仿真、后训练与评测吃真机的分工,把真实数据挤到高价值环节(数据来源:公众号源势AI《2026-09-04_机器人的ChatGPT时刻·卡在数据上》)
源势AI观点
第一,具身数据会重演算力中心的周期:先过剩、再分化。70 家训练场加 46 家在建,同质化竞争几乎确定,活下来的是能绑定模型大客户、且验收标准话语权高的那几家。
第二,对大多数企业,正确姿势是买方而非卖方。手里有真实作业数据的零售、物流、制造企业,变现路径是给模型厂供数据、换股权或换定制模型,而不是自己训一个。
第三,盯住评测与采集标准。数据多不如数据对,这句话本质是在给"什么算好数据"下定义——谁定义标准,谁拿下一阶段分成;反过来,只能按小时卖数据的一方,议价空间会被持续压缩。
话题标签:#具身智能 #数据质量 #仿真训练
